
CHOIR পদ্ধতি: মুক্ত তালিকাকরণ সমষ্টিগত সিস্টেমের ভেতরে মডেলগুলোর অবস্থানের অমিল উন্মোচন করে
লেখকেরা CHOIR পদ্ধতির প্রস্তাব করেন, যেখানে এনসেম্বলগুলো বারবার উত্তরের র্যাঙ্ক করা তালিকা চায়, তারপর মডেল, প্রম্পটের শব্দচয়ন এবং ভূমিকার শর্ত অনুযায়ী একীভূত ধারণাগুলোর প্রাধান্য তুলনা করে। গবেষণায় দেখা যায়, উন্মুক্ত উত্তরের বাহ্যিক সাদৃশ্য বেশি হলেও তা মতৈক্যের ইঙ্গিত দেয় না: মূল মডেলের পরিচয়ই সবচেয়ে স্থিতিশীল পার্থক্যসূচক হিসেবে থাকে, আর পারসোনা-নির্ধারণগুলো প্রকাশিত ধারণাগুলোকে ভিন্ন দিকে সরিয়ে দেয়।
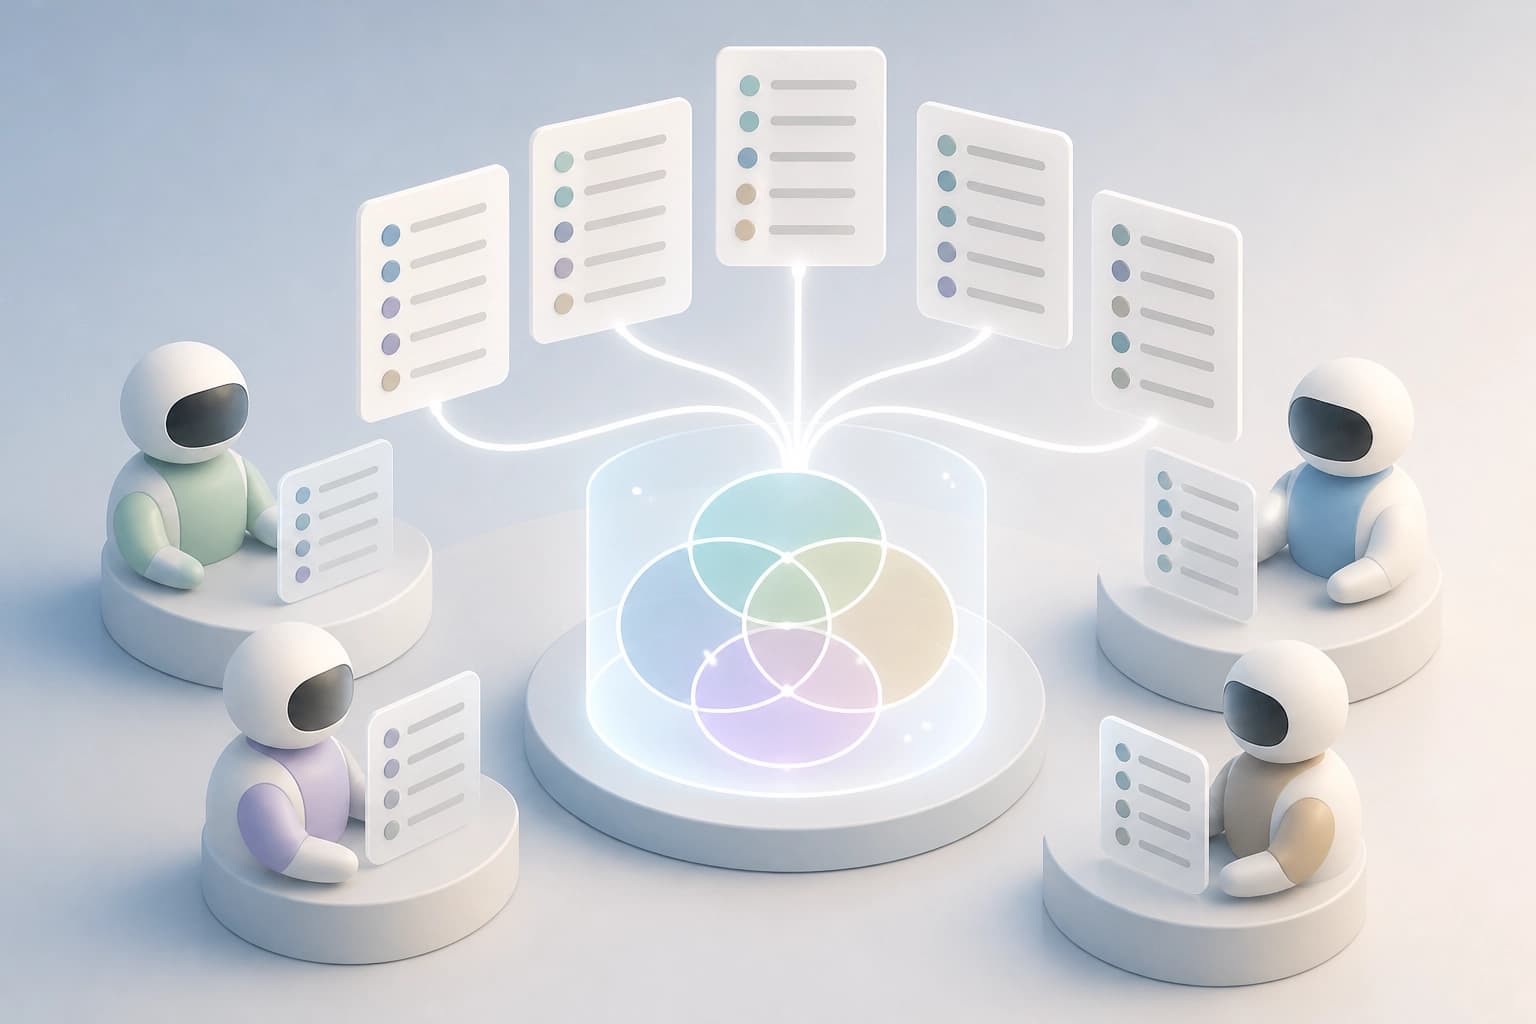
CHOIR কী দেয়
CHOIR-এর পূর্ণরূপ Collective Hierarchically-Ordered Inquiry Responses। এই পদ্ধতি LLM-এর ensemble-এর জন্য মুক্ত তালিকা আহরণের কৌশলকে অভিযোজিত করে। এর কাজ হলো ensemble-এর মডেলগুলোর মতপার্থক্যের অবস্থানগুলো উন্মোচন করা। উত্তরগুলোর উপরিতলের ঐকমত্য এই মতপার্থক্যগুলো আড়াল করে।
এই পদ্ধতি তৈরি করা উত্তর নিয়ে নয়, তালিকা নিয়ে কাজ করে। বারবার করা অনুরোধ থেকে মডেলগুলো নিজেরাই কোন বিষয়গুলো তোলে, সে সম্পর্কে উপাদান পাওয়া যায়। এরপর সেই উপাদানকে তুলনাযোগ্য রূপে আনা হয়।
ব্যবহারিক মানদণ্ড: ensemble-এর উত্তরগুলো দেখতে একই রকম হলেও মডেলগুলো ঠিক কোথায় একমত নয়, তা বুঝতে হলে CHOIR কাজে লাগান।
পদ্ধতির ধাপ
পদ্ধতিটি তিনটি ধাপে গঠিত।
- ensemble-এর মডেলগুলোকে বারবার র্যাঙ্ক করা তালিকা দিতে বলা।
- তালিকার উপাদানগুলোকে প্রম্পটের স্তরে ধারণায় একীভূত করা।
- মডেল, প্রম্পটের ধরন এবং পারসোনা-সহ শর্তগুলোর মধ্যে ধারণার দৃশ্যমানতা পরিমাপ করা।
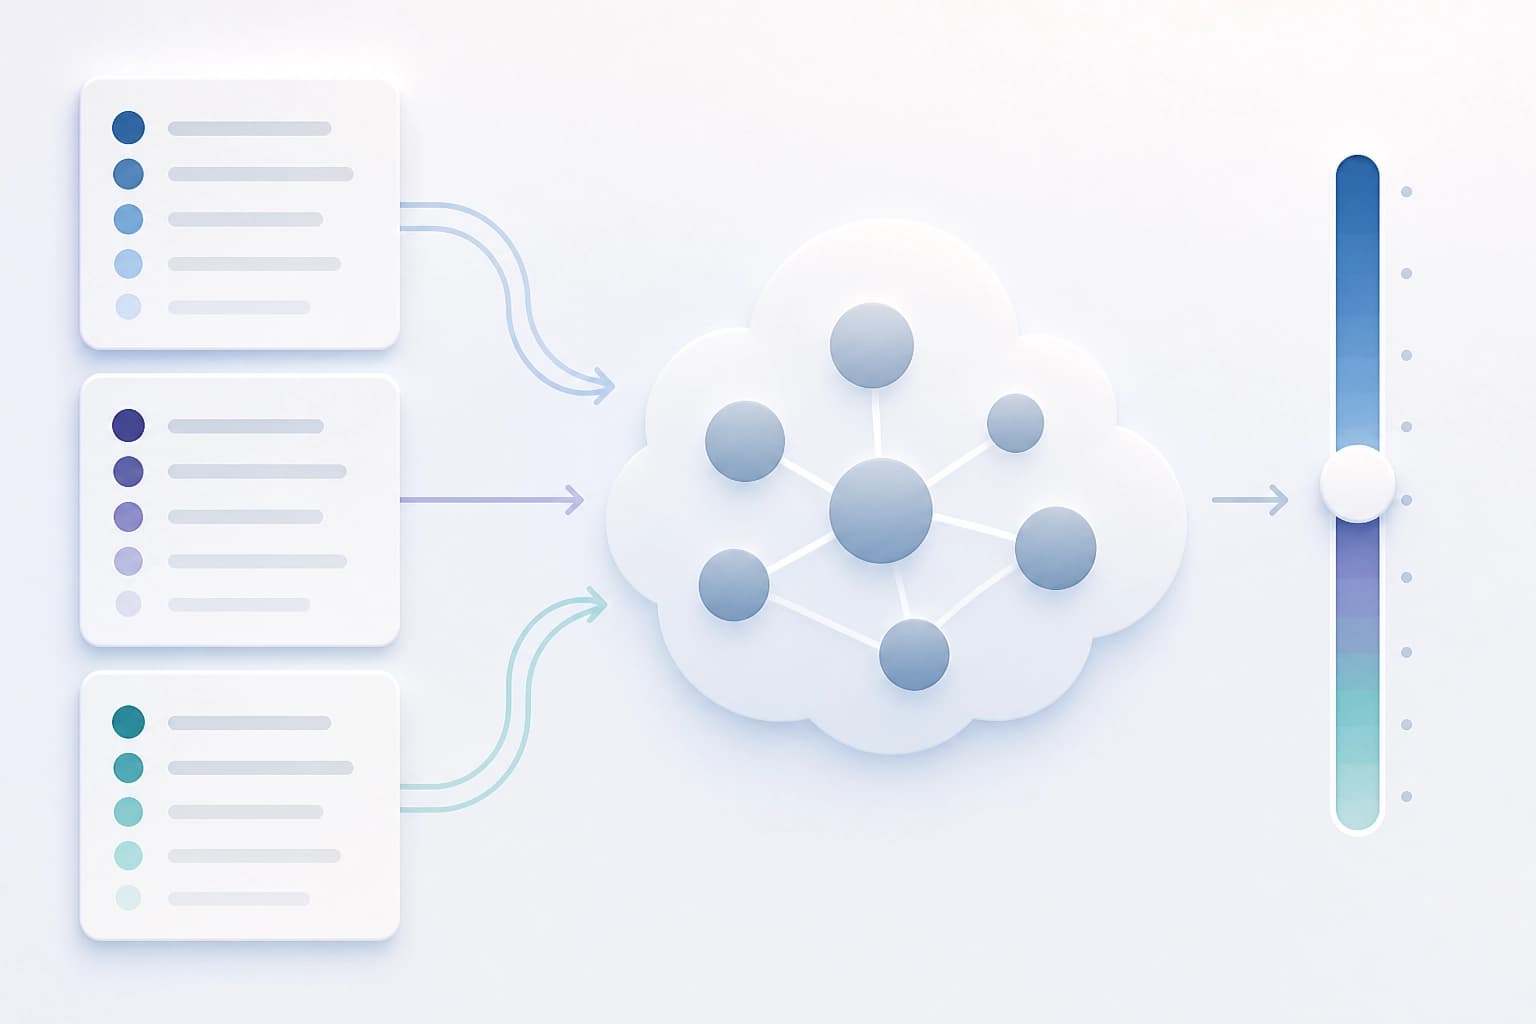
প্রতিটি ধাপ একটি করে মাত্রা যোগ করে। তালিকাগুলো কাঁচামাল দেয়, একীভূতকরণ সেগুলোকে তুলনাযোগ্য রূপে আনে, আর দৃশ্যমানতা মাপা পার্থক্যগুলো দেখায়। ধারণায় না আনলে তুলনা আলাদা আলাদা শব্দের স্তরেই থেকে যায়।
ব্যবহারিক মানদণ্ড: উপাদানগুলোকে ধারণায় একীভূত করার পরও পদ্ধতিটি পার্থক্য ধরে রাখতে পারে কি না, তা যাচাই করুন।
কোন কোন ডেটাসেটে পরীক্ষা করা হয়েছে
| ডেটাসেট | এটি কী | কী দেখিয়েছে |
|---|---|---|
| Infinity-Chat 100 | মডেলের উন্মুক্ত উত্তরের একরূপতা নিয়ে সাম্প্রতিক একটি গবেষণা থেকে নেওয়া বাহ্যিক প্রম্পট সেট | উপরিতলের উচ্চ ঐকমত্য পুনরুৎপাদন করে: ১০০টি প্রম্পটের মধ্যে ৯৩টি দৈব স্তরের ওপরে। সংকীর্ণ প্রম্পট থেকে বিস্তৃত প্রম্পটগুলোকে আলাদা করে, যেগুলোতে উত্তরের অন্তর্নিহিত গভীরতা প্রকাশ পায় |
| লক্ষ্যভিত্তিক ডায়াগনস্টিক ডেটাসেট | প্রক্রিয়ার স্তরে পার্থক্য শনাক্ত করার জন্য ২৭টি প্রশ্ন | মডেলগুলোর মধ্যে মতপার্থক্য লক্ষ্যভিত্তিকভাবে যাচাই করতে সহায়তা করে |
ডেটাসেটগুলো ভিন্ন ভিন্ন কাজে লাগে। বাহ্যিক ডেটাসেটটি ঐকমত্যের সামগ্রিক চিত্র দেখায় এবং একই সঙ্গে বিস্তৃত প্রম্পটকে সংকীর্ণ প্রম্পট থেকে আলাদা করে। লক্ষ্যভিত্তিক ডেটাসেটটি প্রক্রিয়ার স্তরের পার্থক্য শনাক্ত করার জন্য তৈরি।
নির্বাচনের মানদণ্ড: ঐকমত্যের চিত্র পেতে বাহ্যিক প্রম্পট সেট নিন, আর প্রক্রিয়া বিশ্লেষণের জন্য নিন ডায়াগনস্টিক সেট।
পার্থক্যের কী কী লক্ষণ দেখা যায়
পর্যবেক্ষণগুলো তিনটি দলে পড়ে।
- ভিত্তি মডেলের পরিচয়ই শনাক্তযোগ্য সবচেয়ে শক্তিশালী বৈশিষ্ট্য হিসেবে থাকে। লক্ষ্যভিত্তিক যাচাই এবং বাহ্যিক প্রম্পট সেট—উভয় ক্ষেত্রেই এটি সত্য।
- পারসোনা-সহ প্রম্পটগুলো ভিত্তি মডেলের স্বাক্ষরের মধ্যে প্রকাশিত ধারণাগুলোকে ভিন্ন দিকে সরিয়ে দেয়।
- উৎস সম্পর্কে না-জানা একটি র্যাঙ্কিং মডিউল পরবর্তী অধ্যয়নের জন্য বিরল, কিন্তু স্থিতিশীল প্রার্থী শনাক্ত করে।
পারসোনাগুলো ধারণার প্রকাশ বদলে দেয়, কিন্তু ভিত্তি মডেলের সংকেতকে ছাপিয়ে যায় না। উৎস সম্পর্কে না-জেনে করা র্যাঙ্কিং পরবর্তী বিশ্লেষণের জন্য একটি ফিল্টার হিসেবে কাজ করে।
ব্যবহারিক মানদণ্ড: প্রথমে ভিত্তি মডেল স্থির করুন, তারপর পারসোনার প্রভাব মূল্যায়ন করুন।
ঐকমত্যের ঘোষণার বদলে ডায়াগনস্টিক কাঠামো
লেখকেরা উন্মুক্ত উত্তরের একরূপতাকে একটি ডায়াগনস্টিক সমস্যা হিসেবে বিবেচনা করার প্রস্তাব দেন। তখন প্রশ্নটি হয় অন্য রকম: মডেলগুলো কোথায় একমত, কেন একমত, এবং আর কী শনাক্ত করা যায়।
- কোথায় একমত — মডেলগুলোর মধ্যে মিলে যাওয়া ধারণার মানচিত্র।
- কেন একমত — উপরিতলের ঐকমত্যের পেছনের কারণ।
- আর কী দেখা যায় — উৎস সম্পর্কে না-জানা র্যাঙ্কিংয়ের শনাক্ত করা প্রার্থী।
নিবন্ধটি Proceedings of the Third Conference on Language Modeling (COLM 2026), ২০২৬-এ প্রকাশিত হয়েছে। এটি arXiv-এ জমা দেওয়া হয় ২৯ সেপ্টেম্বর ২০২৬-এ। লেখক Ben Wigler এবং Maria Tsfasman।
মানদণ্ড: উত্তরের একরূপতা চূড়ান্ত সিদ্ধান্ত নয়, বরং গভীরতা নির্ণয়ের সূচনা।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
ইন্টারঅ্যাকটিভ XR ডেভেলপমেন্টে কোডিং এজেন্টদের মূল্যায়ন: GenXR-Bench-এর ফলাফল
প্রকাশিত হয়েছে GenXR-Bench—ইন্টারেক্টিভ XR ডেভেলপমেন্টে কোডিং এজেন্টগুলোর এন্ড-টু-এন্ড মূল্যায়নের জন্য ১১২টি বিশেষজ্ঞ-নির্ধারিত কাজের একটি সেট: ফিচার উন্নত করা ও ত্রুটি ঠিক করা থেকে শুরু করে ভোক্তা-পর্যায়ের ডিভাইসে আচরণ যাচাইসহ অ্যাপ্লিকেশন তৈরি পর্যন্ত। পরীক্ষিত দশটি মডেলের মধ্যে সেরা ফল ছিল ৫০.৯% Pass@1; বারবার দেখা ব্যর্থতার মধ্যে রয়েছে সেন্সরের অ্যাসিঙ্ক্রোনাস ইভেন্ট সামলানো, বাস্তব স্থানের সঙ্গে অবজেক্ট যুক্ত করা এবং ভৌত প্রেক্ষাপটে মিথস্ক্রিয়া বোঝা।
5 নভেম্বর 2026
স্কেলার পুরস্কার থেকে প্যারেটো ফ্রন্টিয়ার: বহু-উদ্দেশ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের মাধ্যমে LLM-ভিত্তিক RTL সংশ্লেষণ
একটি ভাষা মডেলকে একটি মাত্র নকশা নয়, বরং ক্ষেত্রফল, বিলম্ব ও বিদ্যুৎ খরচের মধ্যে বিভিন্ন সমঝোতাসহ একগুচ্ছ RTL প্রার্থী তৈরি করতে প্রশিক্ষণ দেওয়ার একটি পদ্ধতি প্রস্তাব করা হয়েছে; পুরস্কার নির্ধারিত হয় প্যারেটো ফ্রন্টের হাইপারভলিউমে প্রতিটি বিকল্পের অবদানের ভিত্তিতে। RTLLM v2-তে আপেক্ষিক হাইপারভলিউম PPA অপ্টিমাইজেশনবিহীন বেসলাইন সংস্করণের তুলনায় ১৩.৩ শতাংশ পয়েন্ট এবং একক-লক্ষ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের তুলনায় ১৪.৪ শতাংশ পয়েন্ট বেড়েছে।
5 নভেম্বর 2026
চিকিৎসাবিষয়ক LLM-গুলো নির্দেশিকা সংশোধনের কথা জানে, কিন্তু প্রায়ই পুরোনো নিয়ম অনুযায়ী উত্তর দেয়
1709টি ক্লিনিক্যাল নির্দেশিকার পরিবর্তন নিয়ে ChronoEvo-এর গবেষণায় দেখা গেছে: মূল মডেলে 90,8% উত্তর নতুনত্বটি শনাক্ত করেছিল, তবে মাত্র 58,5% তা সম্পূর্ণভাবে প্রয়োগ করেছিল; 32,3 শতাংশ পয়েন্টের এই ব্যবধান 14টি মডেলেই বজায় ছিল। আপডেটগুলোর দৃশ্যমানতা বাড়িয়েও নতুন নিয়মগুলো ক্লিনিক্যাল নির্দেশিকায় সম্পূর্ণভাবে অন্তর্ভুক্ত করার ক্ষেত্রে উল্লেখযোগ্য উন্নতি হয়নি।
4 নভেম্বর 2026