
মাল্টি-এজেন্ট এআই-তে কেন্দ্রীয় মেমরি ব্যবস্থাপনা: কম খরচে ব্যক্তিগতকরণ
লেখকেরা সাধারণ স্মৃতির একটি সিস্টেম স্তরের প্রস্তাব দিয়েছেন: এজেন্টরা কাঠামোবদ্ধ তথ্য সংরক্ষণ করে, আর সিস্টেম সেগুলোর নির্বাচন, ডেটা সুরক্ষা এবং মডেলগুলোর কাছে হস্তান্তর নিয়ন্ত্রণ করে। AIOS-এ পরীক্ষায়, এই পদ্ধতি বাহ্যিক স্টোরেজ ও RAG-এর তুলনায় ব্যক্তিগতকরণ উন্নত করেছে, আর সম্পূর্ণ কনটেক্সট পাঠানোর তুলনায় তিনটি মডেলের মধ্যে দুটিতে তুলনীয় ফল বজায় রেখে লেটেন্সি ১৫–৬১% কমিয়েছে।
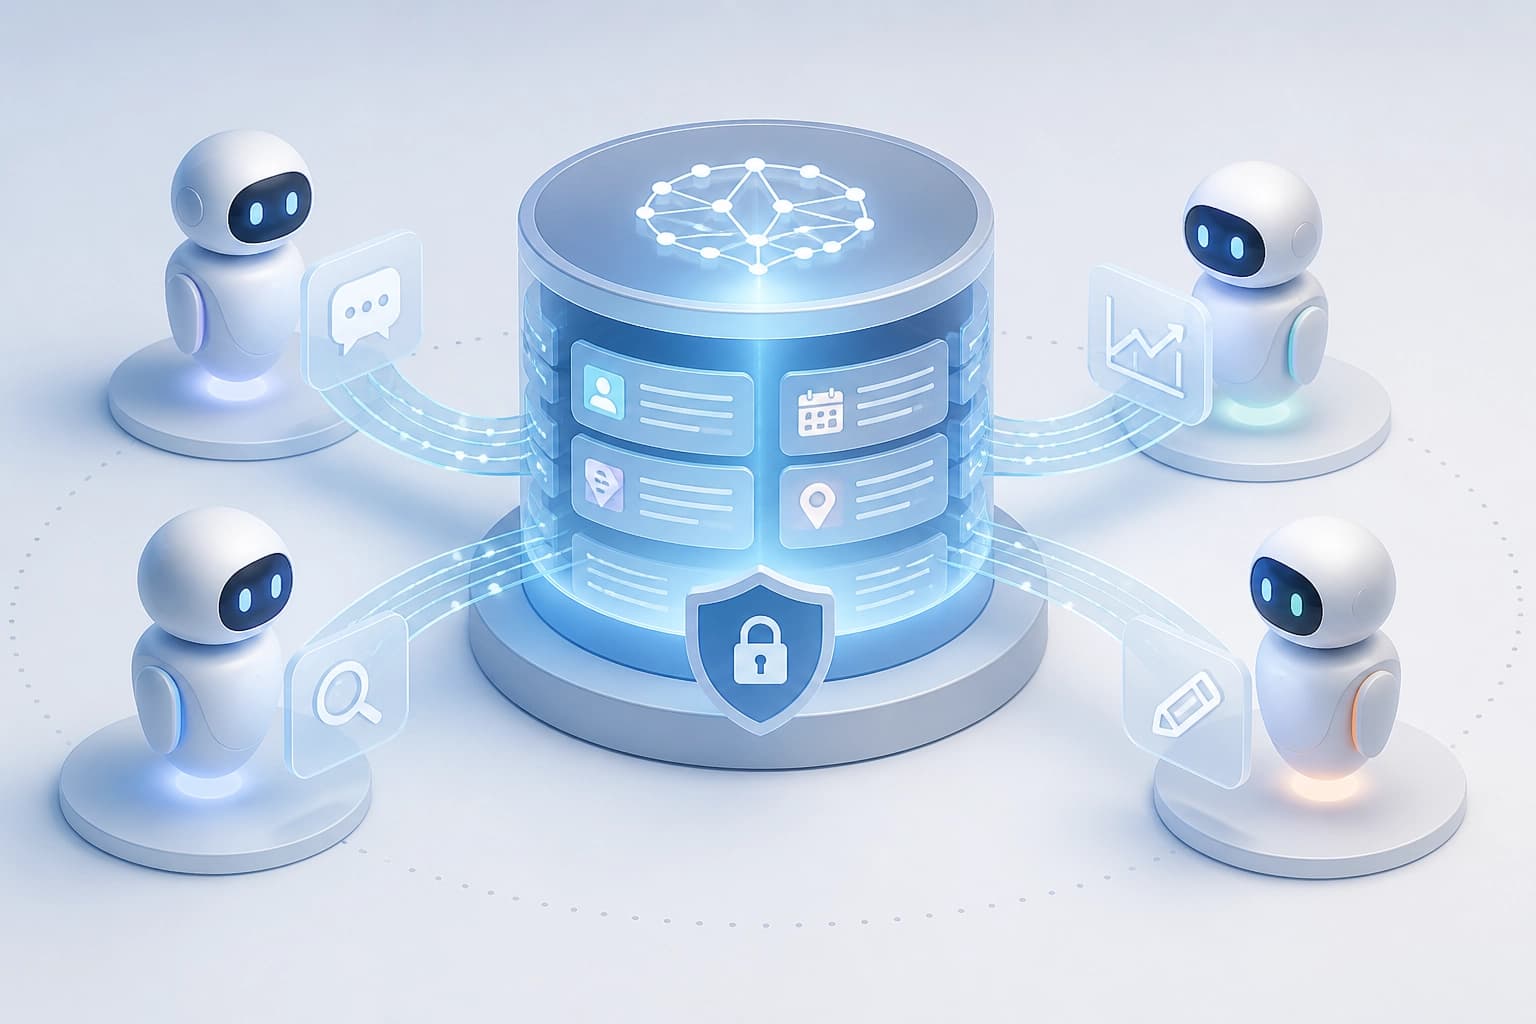
কেন্দ্রীয় স্মৃতি কীভাবে কাজ করে
বিশেষায়িত এজেন্টরা লেবেলসহ কাঠামোবদ্ধ স্মৃতি সংরক্ষণ করে। এজেন্ট সিস্টেমের কোর সেগুলো পুনরুদ্ধার, গোপনীয়তা রক্ষা এবং প্রম্পটে যুক্ত করার কাজ পরিচালনা করে।
এই কাঠামোয় এজেন্টরা স্মৃতি তৈরি করে, আর সিস্টেম কোর নির্ধারণ করে সিস্টেম সেগুলো কীভাবে ব্যবহার করবে:
- সংরক্ষণ: এজেন্টরা লেবেলযুক্ত কাঠামোবদ্ধ স্মৃতি সংরক্ষণ করে।
- পুনরুদ্ধার: এটি পৃথক এজেন্টরা নয়, কোর পরিচালনা করে।
- সুরক্ষা ও সংযোজন: কোর গোপনীয়তা রক্ষা এবং প্রম্পটে স্মৃতি যোগ করার দায়িত্বে থাকে।
কেন্দ্রীকরণের ফলে স্মৃতি তৈরি করা থেকে তার ব্যবহার নিয়ন্ত্রণের কাজ আলাদা থাকে। পুনরুদ্ধার ও সংযোজনের নিয়ম এজেন্ট সিস্টেমের সামগ্রিক পর্যায়ে প্রয়োগ করতে হলে এটি গুরুত্বপূর্ণ।
পদ্ধতিটি কীভাবে যাচাই করা হয়েছে
নকশাটি AIOS-এ বাস্তবায়ন ও মূল্যায়ন করা হয়েছিল। লেখকেরা তিনটি সহায়ক মডেলে তাদের নকশার সঙ্গে তিনটি বিকল্পের তুলনা করেছেন।
- GPT-4o
- Llama-3.1:8B
- Qwen-2.5:7B
গবেষণায় মোট 1 800টি পরীক্ষা অন্তর্ভুক্ত ছিল। কাজের এই অংশে যাচাইয়ের পরিসর বর্ণনা করা হয়েছে, তুলনার পৃথক শর্তাবলি নয়।
তুলনাগুলোতে কী দেখা গেছে
স্মৃতি ব্যবহারের পদ্ধতির ওপর ফলাফল নির্ভর করে। সারণিতে তিনটি বিকল্পের বিপরীতে কেন্দ্রীয় নিয়ন্ত্রণ সম্পর্কে লেখকদের সিদ্ধান্ত তুলে ধরা হয়েছে।
| বিকল্প | কেন্দ্রীয় নিয়ন্ত্রণের ফলাফল |
|---|---|
| একই বেস স্টোরেজসহ Mem0 | পাঁচ-দফা স্কেলে ব্যক্তিকরণের স্কোর 2,4–4,0 পয়েন্ট বেড়েছে। প্রতিটি তুলনাই পরিসংখ্যানগতভাবে তাৎপর্যপূর্ণ: p < 10^-18। |
| রিট্রিভাল-অগমেন্টেড জেনারেশনের মাধ্যমে প্রচলিত সংযোজন | তিনটি মডেলেই উন্নতি বড় এবং ধারাবাহিক ছিল। |
| প্রসঙ্গের সম্পূর্ণ, অপরিশোধিত সংযোজন | দুটি মডেলে ফলাফল পরিসংখ্যানগতভাবে তুলনীয়; তৃতীয়টিতে কেন্দ্রীয় পদ্ধতিটি সামান্য পিছিয়ে ছিল। প্রম্পট ছোট হয়েছে, এবং সব মডেলেই শুরু থেকে শেষ পর্যন্ত বিলম্ব 15–61% কমেছে। প্রতি কলে টোকেনের সংখ্যা ও ইনফারেন্সের খরচও কমেছে। |
GPT-4o-এর ক্ষেত্রে, প্রোফাইল ব্যবহারের একটি উদাহরণমূলক স্কোর 1,05 থেকে 4,69-এ পরিবর্তিত হয়েছে। এই পরিমাপটি Mem0-এর সঙ্গে তুলনার ফলাফল তুলে ধরে।
কখন কেন্দ্রীকরণ বিবেচনা করবেন
সিস্টেমে স্মৃতি পুনরুদ্ধার, সুরক্ষা ও সংযোজনের জন্য সাধারণ নিয়মের প্রয়োজন হলে কেন্দ্রীয় স্মৃতি-নিয়ন্ত্রণ বিবেচনা করা উচিত। এই পদ্ধতিতে এসব সিদ্ধান্ত পৃথক এজেন্টের বদলে সিস্টেম কোরের হাতে থাকে।
ব্যবহারিক মানদণ্ড হলো, প্রয়োজনীয় ব্যক্তিকরণকে গ্রহণযোগ্য প্রসঙ্গের পরিমাণ ও খরচের সঙ্গে তুলনা করা। লেখকদের সিদ্ধান্ত, কেন্দ্রীকরণে উল্লেখযোগ্যভাবে কম খরচে সীমাহীন প্রসঙ্গের ব্যক্তিকরণ-সুবিধার বেশির ভাগই পাওয়া যায়।
এই নিবন্ধের ভিত্তি হলো সিস্টেমজুড়ে ব্যক্তিকরণের জন্য কার্নেল-পরিচালিত ভাগ করা স্মৃতি রায়ান লুম ও ইয়ংফেং ঝাংয়ের লেখা, যা 9 সেপ্টেম্বর 2026-এ জমা দেওয়া হয়েছে।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
ইন্টারঅ্যাকটিভ XR ডেভেলপমেন্টে কোডিং এজেন্টদের মূল্যায়ন: GenXR-Bench-এর ফলাফল
প্রকাশিত হয়েছে GenXR-Bench—ইন্টারেক্টিভ XR ডেভেলপমেন্টে কোডিং এজেন্টগুলোর এন্ড-টু-এন্ড মূল্যায়নের জন্য ১১২টি বিশেষজ্ঞ-নির্ধারিত কাজের একটি সেট: ফিচার উন্নত করা ও ত্রুটি ঠিক করা থেকে শুরু করে ভোক্তা-পর্যায়ের ডিভাইসে আচরণ যাচাইসহ অ্যাপ্লিকেশন তৈরি পর্যন্ত। পরীক্ষিত দশটি মডেলের মধ্যে সেরা ফল ছিল ৫০.৯% Pass@1; বারবার দেখা ব্যর্থতার মধ্যে রয়েছে সেন্সরের অ্যাসিঙ্ক্রোনাস ইভেন্ট সামলানো, বাস্তব স্থানের সঙ্গে অবজেক্ট যুক্ত করা এবং ভৌত প্রেক্ষাপটে মিথস্ক্রিয়া বোঝা।
5 নভেম্বর 2026
স্কেলার পুরস্কার থেকে প্যারেটো ফ্রন্টিয়ার: বহু-উদ্দেশ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের মাধ্যমে LLM-ভিত্তিক RTL সংশ্লেষণ
একটি ভাষা মডেলকে একটি মাত্র নকশা নয়, বরং ক্ষেত্রফল, বিলম্ব ও বিদ্যুৎ খরচের মধ্যে বিভিন্ন সমঝোতাসহ একগুচ্ছ RTL প্রার্থী তৈরি করতে প্রশিক্ষণ দেওয়ার একটি পদ্ধতি প্রস্তাব করা হয়েছে; পুরস্কার নির্ধারিত হয় প্যারেটো ফ্রন্টের হাইপারভলিউমে প্রতিটি বিকল্পের অবদানের ভিত্তিতে। RTLLM v2-তে আপেক্ষিক হাইপারভলিউম PPA অপ্টিমাইজেশনবিহীন বেসলাইন সংস্করণের তুলনায় ১৩.৩ শতাংশ পয়েন্ট এবং একক-লক্ষ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের তুলনায় ১৪.৪ শতাংশ পয়েন্ট বেড়েছে।
5 নভেম্বর 2026
চিকিৎসাবিষয়ক LLM-গুলো নির্দেশিকা সংশোধনের কথা জানে, কিন্তু প্রায়ই পুরোনো নিয়ম অনুযায়ী উত্তর দেয়
1709টি ক্লিনিক্যাল নির্দেশিকার পরিবর্তন নিয়ে ChronoEvo-এর গবেষণায় দেখা গেছে: মূল মডেলে 90,8% উত্তর নতুনত্বটি শনাক্ত করেছিল, তবে মাত্র 58,5% তা সম্পূর্ণভাবে প্রয়োগ করেছিল; 32,3 শতাংশ পয়েন্টের এই ব্যবধান 14টি মডেলেই বজায় ছিল। আপডেটগুলোর দৃশ্যমানতা বাড়িয়েও নতুন নিয়মগুলো ক্লিনিক্যাল নির্দেশিকায় সম্পূর্ণভাবে অন্তর্ভুক্ত করার ক্ষেত্রে উল্লেখযোগ্য উন্নতি হয়নি।
4 নভেম্বর 2026