
CARAT: পরীক্ষা করে, পদার্থবিজ্ঞানভিত্তিক LLM-গুলো কাঠামো অনুমান করে, নাকি প্রম্পটের পুনর্কথন করে
এই কাজে এমন একটি প্রোটোকল প্রস্তাব করা হয়েছে, যা কাঠামো উপস্থাপনের আটটি পদ্ধতিতে প্রশ্ন ও সঠিক উত্তর নথিভুক্ত করে এবং GraphSpace-এ সংযোগগুলোকে আলাদাভাবে চিহ্নিত করে। জোড়াভিত্তিক ফাইন-টিউনিং, লক্ষ্য ক্ষেত্র মাস্ক করা এবং প্রমাণ যোগ করার পরীক্ষা দেখায় যে মডেলটি সম্পর্কের প্রয়োগ এবং সংযোগ অনুসরণ—দুটিই শিখতে সক্ষম; তবে সংযোগ সরিয়ে দিলে নির্ভুলতা হিউরিস্টিক অনুসন্ধানের স্তরেরও নিচে নেমে যায়।
কেন নির্ভুলতা যুক্তি প্রমাণ করে না
উপকরণবিজ্ঞানের জন্য একটি ভাষা মডেল দুটি ভিন্ন কারণে সঠিক উত্তর দিতে পারে। হয় এটি কাঠামোগত তথ্য থেকে উত্তরটি নির্ণয় করে, নয়তো ইনপুটে আগে থেকেই থাকা মানটি পুনরাবৃত্তি করে। সাধারণ নির্ভুলতার মেট্রিক এই দুটি ঘটনাকে আলাদা করতে পারে না। কাঠামোগত বিবরণে এমন একটি ক্ষেত্র থাকতে পারে, যেটির ভিত্তিতে উত্তর মূল্যায়ন করা হয়; সেক্ষেত্রে স্কোরটি আসলে ইঙ্গিত পড়ার ক্ষমতা প্রতিফলিত করে।
CARAT বেঞ্চমার্ক এই পার্থক্যকে কেন্দ্র করে তৈরি। এটি যাচাই করে, উপকরণবিজ্ঞানের LLM-গুলো কাঠামোগত তথ্যের ভিত্তিতে যুক্তি করে, নাকি ইঙ্গিতটি পুনরাবৃত্তি করে। নিবন্ধটির লেখক Jiajun Wu, Jian Yang, Zixiang Ni, Zhenzhu Li এবং Bin Chong; কাজটি জমা দেওয়া হয়েছিল ২৯ সেপ্টেম্বর ২০২৬-এ।
ব্যবহারিক মানদণ্ড: কাঠামোগত তথ্যের ক্ষেত্রে উচ্চ নির্ভুলতা নিজে থেকে কিছুই প্রমাণ করে না। উত্তরটি কোন পরিস্থিতিতে পাওয়া হয়েছে, সেটিই দেখতে হবে।
মিলিয়ে তুলনা কীভাবে সাজানো হয়েছে
আটটি মেলানো উপস্থাপনার ক্ষেত্রেই প্রশ্ন ও আদর্শ উত্তর অপরিবর্তিত রাখা হয়েছে। কাঠামোগত সম্পর্কগুলো GraphSpace-এ আলাদাভাবে চিহ্নিত করা হয়েছে।
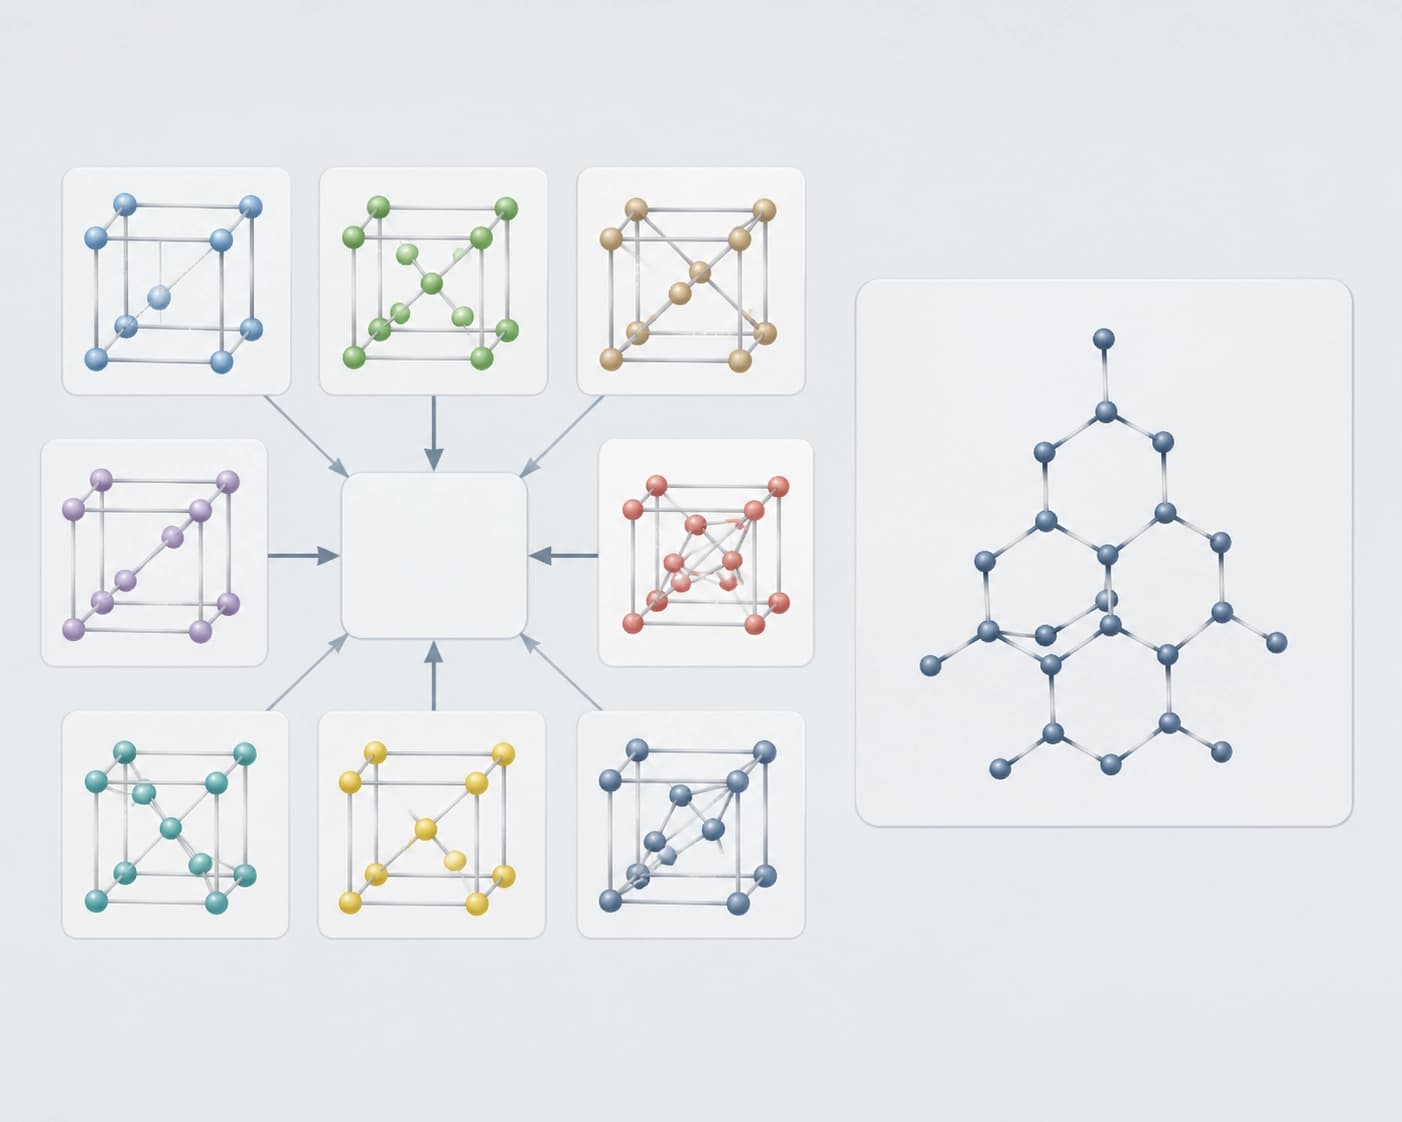
এর সঙ্গে যোগ করা হয়েছে মেলানো ফাইন-টিউনিং, উত্তর মাস্ক করা, প্রমাণ যোগ করা, জোড়াভিত্তিক ইনফারেন্স এবং দাবি করা থেকে বিরত থাকার নিয়ম।
| কী তুলনা করা হচ্ছে | পার্থক্য |
|---|---|
| সবচেয়ে কঠিন কাজের পরিবারগুলোতে কাঠামোভিত্তিক উপস্থাপনার সঙ্গে শুধু সূত্রের ইনপুটের তুলনা | ১৭.৩ পয়েন্ট |
প্রশ্ন অপরিবর্তিত রাখলে প্রশ্নের ভাষাকে ব্যাখ্যা হিসেবে ব্যবহার করার সুযোগ থাকে না। উত্তর মাস্ক করা হলে মডেলের পক্ষে প্রস্তুত মান বসিয়ে দেওয়া কঠিন হয়।
উপসংহার: প্রশ্ন ও আদর্শ উত্তর অপরিবর্তিত থাকলেই কেবল উপস্থাপনাগুলোর তুলনা অর্থবহ। তা না হলে পার্থক্যটি কাঠামো নিয়ে কাজের দক্ষতা নয়, বরং প্রশ্নের লেখার মান দেখাবে।
GraphSpace ও সাধারণ গ্রাফের মধ্যে ব্যবধান কত
GraphSpace সাধারণ পর্যায় সারণির গ্রাফকে ১৯.৩ পয়েন্টে ছাড়িয়ে যায়। এই ব্যবধানের পেছনে দুটি ভিন্ন প্রভাব রয়েছে।
| শর্ত | পার্থক্য |
|---|---|
| সাধারণ উপস্থাপনায় উত্তর দেওয়ার জন্য প্রয়োজনীয় সব তথ্য রয়েছে | ১.৯৬ পয়েন্ট |
| সাধারণ উপস্থাপনায় এই ক্ষেত্রগুলো সম্পূর্ণ অনুপস্থিত | ৪৬.৭ পয়েন্ট |
ভিত্তিগত উপস্থাপনায় উত্তর দেওয়ার জন্য যথেষ্ট তথ্য থাকলে সুবিধাটি প্রায় মিলিয়ে যায়। প্রয়োজনীয় ক্ষেত্রগুলো সেখানে না থাকলে ব্যবধান বড় হয়ে ওঠে। লেখকেরা উল্লেখ করেছেন: তুলনার মূল ফলাফলটি প্রমাণের উপস্থাপনা-পদ্ধতি নয়, বরং ভিত্তিগত উপস্থাপনায় তথ্যের ঘাটতি প্রতিফলিত করে।
ব্যবহারিক মানদণ্ড: কোনো একটি উপস্থাপনা শ্রেয় বলে সিদ্ধান্ত নেওয়ার আগে সেটিতে কোন কোন ক্ষেত্র রয়েছে, তা যাচাই করুন। তা না হলে পদ্ধতি নয়, তথ্যের পূর্ণতাই মাপা হবে।
বিকল্প কৌশল ও বেঞ্চমার্কের পুনর্গঠন
পরীক্ষায় কাজের সেটটির একটি দুর্বলতা প্রকাশ পেয়েছে। যে নিয়মটি লিংক এড়িয়ে সরাসরি তালিকা পড়ে, সেটি আরও কঠিন করা সাতটি কাজের পরিবারের মধ্যে চারটির উত্তর দিতে পারে। মডেলটি সম্পর্কটি না বুঝেও সেটি এড়িয়ে যেতে পারে।
বেঞ্চমার্কটি পুনর্গঠন করা হয়েছে। এ ধরনের এগারোটি বিকল্প কৌশল এখন দৈবচয়নের কাছাকাছি ফল দেয়।
উপসংহার: বিকল্প পথ আছে কি না, তা যাচাই করার পরেই কেবল কাজের সেটটি যুক্তি মূল্যায়নের উপযোগী হয়। কোনো সাধারণ নিয়ম যদি কয়েকটি কাজের পরিবারের সমাধান করে ফেলে, তাহলে মাপা হচ্ছে না যুক্তি।
উত্তরে লিংক উল্লেখ করা আর সম্পর্কের ওপর নির্ভর করা এক নয়
একটি অপরিবর্তিত মডেল লিংক উদ্ধৃত করে, কিন্তু লিংকটি অন্য দিকে পাঠালেও ৯৫.৬% জোড়াভিত্তিক ক্ষেত্রে একই উত্তর দেয়। মডেলটি সম্পর্কটি পুনরাবৃত্তি করে, সেটি ব্যবহার করে না।
| শর্ত | একই উত্তর পাওয়া জোড়াভিত্তিক ক্ষেত্রের হার |
|---|---|
| অপরিবর্তিত মডেল, লিংক অন্য দিকে পাঠানো হয় | ৯৫.৬% |
| মেলানো প্রশিক্ষণের পর, লিংক অন্য দিকে পাঠানো হয় | ৯৯.৮% |
| লিংক সরিয়ে দেওয়া হয় | ২৩.৪% |
| সেরা বিকল্প কৌশল | ২৭.০% |
মেলানো প্রশিক্ষণের পর এই হার ৯৯.৮%-এ পৌঁছায়। লিংক সরিয়ে দিলে হার কমে ২৩.৪%-এ দাঁড়ায়, যা সেরা বিকল্প কৌশলের ২৭.০%-এর চেয়েও কম। লেখকেরা সিদ্ধান্তে আসেন, প্রশিক্ষণের দুটি ধাপই—সম্পর্ক ব্যবহার করা এবং লিংকের ওপর নির্ভর করা—আয়ত্ত করা সম্ভব।
মানদণ্ড: লিংক উদ্ধৃত করা মানেই সেটি ব্যবহার করা নয়। লিংক অন্য দিকে পাঠালে এবং সরিয়ে দিলে মডেলের আচরণ যাচাই করতে হবে।
টুল মূল্যায়নের ক্ষেত্রে এর তাৎপর্য
- ইনপুটে প্রশ্নের উত্তর আগে থেকেই রয়েছে কি না, তা যাচাই করুন।
- শুধু উদ্ধৃতি নয়, লিংক অন্য দিকে পাঠানো ও সরিয়ে দেওয়ার পরের ফলাফল দেখুন।
- নিয়ন্ত্রণ-পদ্ধতির বিবরণ দাবি করুন: প্রশ্ন, আদর্শ উত্তর এবং একাধিক উপস্থাপনা অপরিবর্তিত রাখা হয়েছে কি না।
- বিকল্প কৌশল যাচাইয়ের পর কাজের সেটটি হালনাগাদ করা হয়েছে কি না, তা জেনে নিন।
- ঘোষিত ব্যবধানকে তথ্যের গঠনের সঙ্গে মিলিয়ে মূল্যায়ন করুন, একক সংখ্যা হিসেবে নয়।
নির্বাচনের মানদণ্ড: কোনো ফলাফল তখনই বিশ্বাসযোগ্য, যখন ইঙ্গিতে প্রয়োজনীয় ক্ষেত্রটির উপস্থিতি বা কোনো সাধারণ বিকল্প নিয়মের কার্যকারিতা দিয়ে সেটি ব্যাখ্যা করা যায় না।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
ইন্টারঅ্যাকটিভ XR ডেভেলপমেন্টে কোডিং এজেন্টদের মূল্যায়ন: GenXR-Bench-এর ফলাফল
প্রকাশিত হয়েছে GenXR-Bench—ইন্টারেক্টিভ XR ডেভেলপমেন্টে কোডিং এজেন্টগুলোর এন্ড-টু-এন্ড মূল্যায়নের জন্য ১১২টি বিশেষজ্ঞ-নির্ধারিত কাজের একটি সেট: ফিচার উন্নত করা ও ত্রুটি ঠিক করা থেকে শুরু করে ভোক্তা-পর্যায়ের ডিভাইসে আচরণ যাচাইসহ অ্যাপ্লিকেশন তৈরি পর্যন্ত। পরীক্ষিত দশটি মডেলের মধ্যে সেরা ফল ছিল ৫০.৯% Pass@1; বারবার দেখা ব্যর্থতার মধ্যে রয়েছে সেন্সরের অ্যাসিঙ্ক্রোনাস ইভেন্ট সামলানো, বাস্তব স্থানের সঙ্গে অবজেক্ট যুক্ত করা এবং ভৌত প্রেক্ষাপটে মিথস্ক্রিয়া বোঝা।
5 নভেম্বর 2026
স্কেলার পুরস্কার থেকে প্যারেটো ফ্রন্টিয়ার: বহু-উদ্দেশ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের মাধ্যমে LLM-ভিত্তিক RTL সংশ্লেষণ
একটি ভাষা মডেলকে একটি মাত্র নকশা নয়, বরং ক্ষেত্রফল, বিলম্ব ও বিদ্যুৎ খরচের মধ্যে বিভিন্ন সমঝোতাসহ একগুচ্ছ RTL প্রার্থী তৈরি করতে প্রশিক্ষণ দেওয়ার একটি পদ্ধতি প্রস্তাব করা হয়েছে; পুরস্কার নির্ধারিত হয় প্যারেটো ফ্রন্টের হাইপারভলিউমে প্রতিটি বিকল্পের অবদানের ভিত্তিতে। RTLLM v2-তে আপেক্ষিক হাইপারভলিউম PPA অপ্টিমাইজেশনবিহীন বেসলাইন সংস্করণের তুলনায় ১৩.৩ শতাংশ পয়েন্ট এবং একক-লক্ষ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের তুলনায় ১৪.৪ শতাংশ পয়েন্ট বেড়েছে।
5 নভেম্বর 2026
চিকিৎসাবিষয়ক LLM-গুলো নির্দেশিকা সংশোধনের কথা জানে, কিন্তু প্রায়ই পুরোনো নিয়ম অনুযায়ী উত্তর দেয়
1709টি ক্লিনিক্যাল নির্দেশিকার পরিবর্তন নিয়ে ChronoEvo-এর গবেষণায় দেখা গেছে: মূল মডেলে 90,8% উত্তর নতুনত্বটি শনাক্ত করেছিল, তবে মাত্র 58,5% তা সম্পূর্ণভাবে প্রয়োগ করেছিল; 32,3 শতাংশ পয়েন্টের এই ব্যবধান 14টি মডেলেই বজায় ছিল। আপডেটগুলোর দৃশ্যমানতা বাড়িয়েও নতুন নিয়মগুলো ক্লিনিক্যাল নির্দেশিকায় সম্পূর্ণভাবে অন্তর্ভুক্ত করার ক্ষেত্রে উল্লেখযোগ্য উন্নতি হয়নি।
4 নভেম্বর 2026