ফলাফলভিত্তিক পুরস্কার — এবং তার ভেতরের অন্ধ জায়গা
GUI-এজেন্ট গবেষণায় লক্ষণীয়ভাবে গুরুত্ব সরে গেছে: 점점 더 많은 কাজ ফলাফলভিত্তিক পুরস্কার মডেলিং (outcome reward modeling)-এ নিবেদিত হচ্ছে। যুক্তিটা সহজ — এজেন্ট একটি স্কোর পায় তার ট্রাজেক্টরি ব্যবহারকারীর নির্দেশে বোঝানো অবস্থায় পৌঁছেছে কি না তার ভিত্তিতে। আছে একটি অ্যাকশন, আছে একটি স্ক্রিন, আছে একটি পরিণতি, আছে একটি মূল্যায়ন।
কিন্তু এখানেই লুকিয়ে আছে ফাঁদ। যদি এজেন্ট "ফলাফলের জন্য" পুরস্কার পায়, তবে কাউকে স্পষ্ট করতে হবে ঠিক কী ফলাফল হিসেবে গণ্য হবে। সাধারণ স্কিমে এই ধাপটি হয় এড়িয়ে যাওয়া হয়, একটি সাধারণ বাক্য দিয়ে প্রতিস্থাপন করে, নয়তো মডেলের নিজের বিবেচনায় ছেড়ে দেওয়া হয়: সে যাচাইয়ের সময় "যুক্তি" করে, স্পষ্টভাবে নির্ধারিত মানদণ্ড ছাড়াই। দুটোই কাজ করে বলেই মনে হয় — ঠিক সেই মুহূর্ত পর্যন্ত, যখন একই ভেরিফায়ার দিয়ে ডজনখানেক ভিন্ন কাজ মূল্যায়ন করতে হয়।
সাধারণ রুব্রিকের তিনটি সাধারণ ভুল
arXiv:2608.24174 «Task-Adaptive Rubrics for GUI Reward Modeling» (Tao Xiong এবং সহলেখকরা) কাজে বর্ণনা করা হয়েছে, একটি সর্বজনীন টেমপ্লেট বা মডেলের অন্তর্নিহিত যুক্তির উপর নির্ভর করলে কী হয়। সমস্যাগুলো অনুমেয়:
- কাজের মধ্যে যাচাই স্থানান্তর। একসময় একটি দৃশ্যপটের জন্য তৈরি মানদণ্ড যান্ত্রিকভাবে অন্যটিতে প্রয়োগ করা হয়, যেখানে তার কোনো অর্থই নেই।
- সীমাবদ্ধতার ক্ষতি। বর্তমান নির্দেশের সুনির্দিষ্ট দাবি — প্রয়োজনীয় মান, নির্দিষ্ট ফিল্ড, নির্দিষ্ট ধাপ — অলক্ষিত থেকে যায়, কারণ সাধারণ রুব্রিক সেগুলো আলাদা করে না।
- অতিরিক্ত কঠোরতা। ভেরিফায়ার এমন কিছু দাবি করতে শুরু করে যা ব্যবহারকারী চাননি, এবং সঠিকভাবে সম্পন্ন কাজ বাতিল করে।
তিনটিরই সাধারণ কারণ এক: রুব্রিক কাজ থেকে আলাদা হয়ে বাস করে। এটি নির্দেশ থেকে উদ্ভূত হয় না, বরং বাইরে থেকে তার উপর চাপিয়ে দেওয়া হয়।
AdaptRubric কীভাবে গঠিত
প্রস্তাবিত ফ্রেমওয়ার্কের নামই তাই — "মোটা থেকে সূক্ষ্ম" রুব্রিক (Coarse-to-Fine Rubrics Framework)। এর কাজ প্রস্তুত মানদণ্ডের সেট সংরক্ষণ করা নয়, বরং প্রতিটি নির্দিষ্ট নির্দেশের জন্য সেগুলো তৈরি করা, বিস্তৃত স্তর থেকে সংকীর্ণ স্তরের দিকে এগিয়ে। দুটি পর্যায় দুটি ভিন্ন সমস্যার সমাধান করে, এবং এটিই গঠনের মূল সূক্ষ্ম বিষয়।
মোটা পর্যায়: প্রথমে বুঝতে হবে এটি কোন ধরনের কাজ
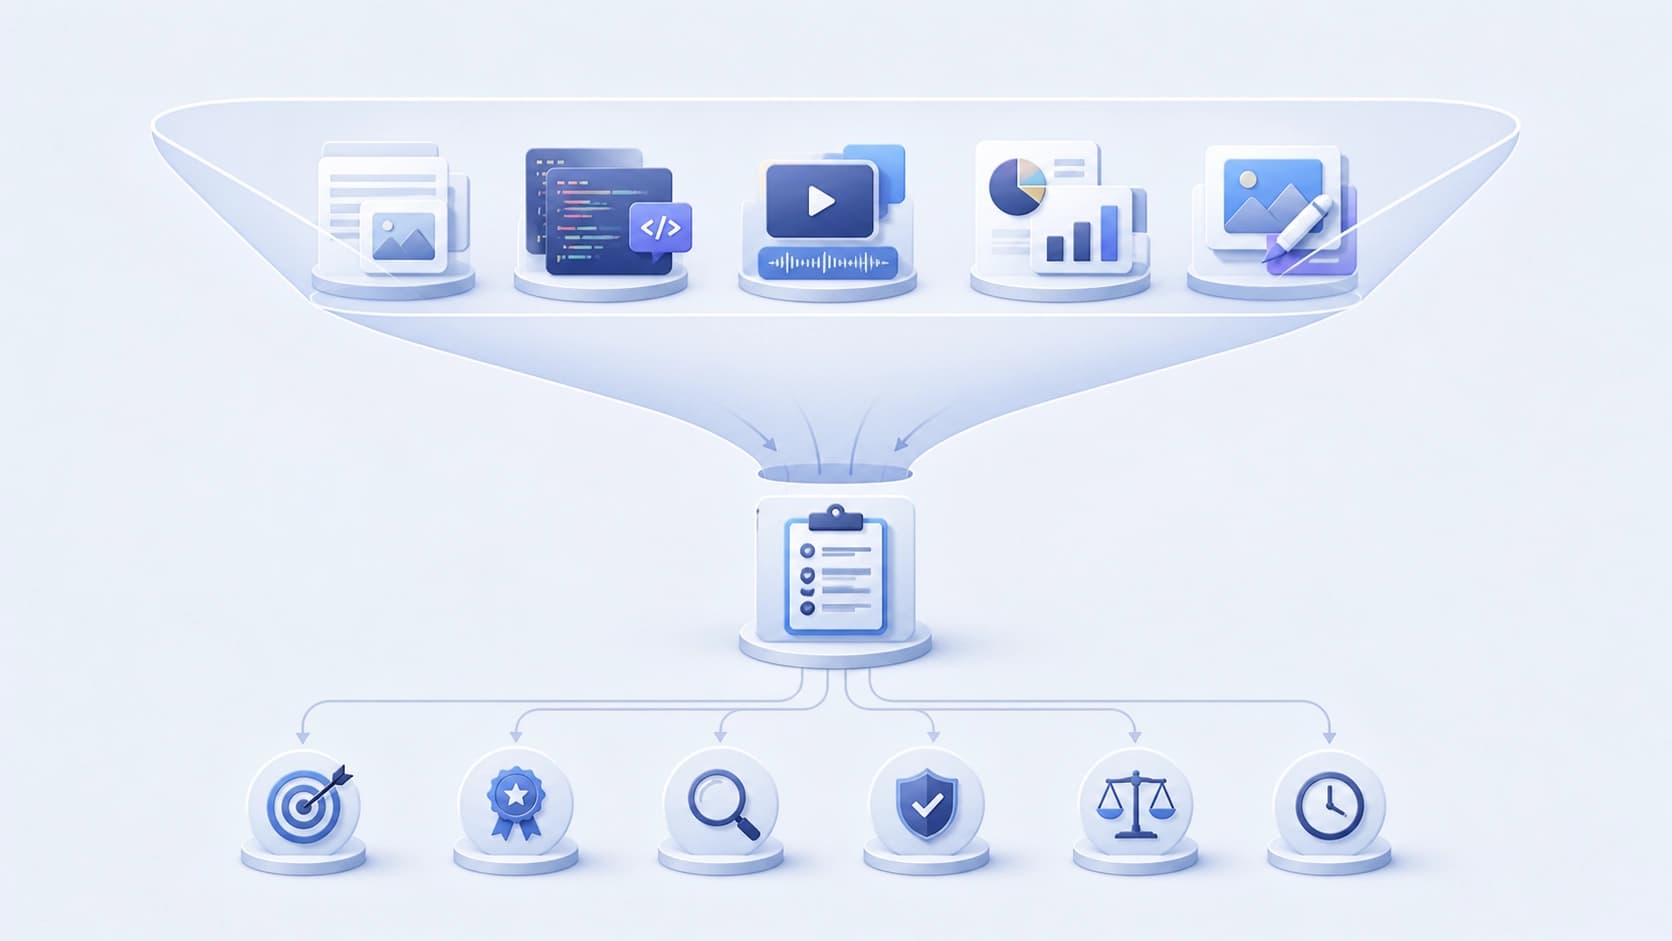
প্রথম ধাপ — রাউটিং। নির্দেশটি GUI-কাজের একটি নির্দিষ্ট পরিবারের অন্তর্গত, এবং সেই পরিবার থেকে পুনর্ব্যবহারযোগ্য মানদণ্ড টেনে আনা হয়। মর্ম হলো, অনুরূপ অ্যাকশনের সফলতার স্থিতিশীল লক্ষণ থাকে: সেগুলো ইতিমধ্যেই জানা, এবং প্রতিটি নতুন অনুরোধের জন্য সেগুলো নতুন করে উদ্ভাবন করতে হয় না। মোটা রুব্রিক একটি কাঠামো নির্ধারণ করে — কাঠামো, চূড়ান্ত রায় নয়।
সূক্ষ্ম পর্যায়: নির্দিষ্ট দৃষ্টান্তের বিস্তারিত বের করা
দ্বিতীয় ধাপ ইতিমধ্যেই একটি পৃথক নির্দেশ নিয়ে কাজ করে। এটি থেকে সংক্ষিপ্ত সংকেত বের করা হয় — নির্দিষ্ট মান, কার্যপরিধি, সীমাবদ্ধতা, যা এই কাজে মূলগত। এখানেই রুব্রিক সাধারণ থাকা বন্ধ করে এই নির্দিষ্ট ক্ষেত্রের নিজস্ব হয়ে ওঠে। ব্যবহারকারী যে দাবি করেননি তা উপস্থিত হয় না; তিনি যে দাবি করেছেন তা হারায় না।
এই বিভাজন সর্বজনীন স্কিমের প্রধান অভিযোগ দূর করে: সাধারণীকরণ থাকে, কিন্তু তা আর স্পেসিফিকেশনকে প্রতিস্থাপন করে না।
ফলাফল: অফলাইন এবং রিইনফোর্সমেন্ট লার্নিংয়ে
AdaptRubric দুটি মোডে পরীক্ষা করা হয়েছে। প্রথমটি — অফলাইন পুরস্কার মূল্যায়ন, অর্থাৎ ভেরিফায়ার কত ভালোভাবে সফল ও অসফল ট্রাজেক্টরি আলাদা করে। দ্বিতীয়টি — অনলাইন অপ্টিমাইজেশন রিইনফোর্সমেন্ট লার্নিং দিয়ে, যেখানে রুব্রিক ইতিমধ্যেই এজেন্ট প্রশিক্ষণের সংকেতের উৎস হিসেবে কাজ করে।
ঘোষিত সংখ্যা: তুলনীয় ইমেজ বাজেটে F1 সূচক বেসলাইন সমাধানের গড় মানের তুলনায় ৩.৬ পয়েন্ট বেড়েছে, এবং কাজ সম্পন্ন করার সাফল্যের বৃদ্ধি হয়েছে ৪.২৩ পয়েন্ট। লেখকরা জোর দেন যে সুবিধাটি ধারাবাহিকভাবে পুনরুৎপাদিত হয়, কয়েকটি সৌভাগ্যজনক রানের উপর নির্ভর করে না।
মূলগতভাবে এটি কী বদলায়
এজেন্টের মূল্যায়ন আর "ভালো ভেরিফায়ার নাকি খারাপ" প্রশ্ন থাকে না। এটি একটি পদ্ধতিগত প্রশ্ন হয়ে ওঠে: কে এবং কোন ভিত্তিতে এই নির্দিষ্ট কাজের জন্য মানদণ্ড তৈরি করেছে। যতদিন মানদণ্ড অন্তর্নিহিতভাবে উদ্ভূত হচ্ছিল, মূল্যায়নের ভুল এজেন্টের নিজের ভুল থেকে প্রায় আলাদা করা অসম্ভব ছিল — চূড়ান্ত প্রতিবেদনে দুটোই একই রকম দেখাচ্ছিল।
অভিযোজিত রুব্রিকের পদ্ধতি মধ্যবর্তী স্তরটিকে স্পষ্ট করে তোলে, ফলে এটি মডেল থেকে আলাদাভাবে যাচাই, আলোচনা এবং সংশোধন করা যায়। ডেভেলপমেন্টের জন্যও এটি একটি ব্যবহারিক সুবিধা: যদি রুব্রিক নির্দেশ অনুযায়ী তৈরি হয়, তবে কাজের বাক্যবিন্যাস পরিবর্তন স্বয়ংক্রিয়ভাবে তার মূল্যায়নের পদ্ধতিও বদলে দেয়, ভেরিফায়ার পুনর্লিখন ছাড়াই।
খোলা প্রশ্নও রয়ে যায় — পরিবারগুলোর সংযোগস্থলে থাকা কাজগুলো রাউটিং কত ভালোভাবে সামলায়, ইচ্ছাকৃতভাবে দ্ব্যর্থক নির্দেশে সূক্ষ্ম পর্যায় কেমন আচরণ করে। কিন্তু সমস্যার উপস্থাপনাটাই ইতিমধ্যেই আরেকটি সর্বজনীন টেমপ্লেটকে একটু বেশি নিখুঁত করার প্রচেষ্টার চেয়ে বেশি উপকারী মনে হচ্ছে।