
Modelo del mundo para agentes basados en LLM cerrados: corrección en puntos de riesgo
Se propone PAWM, un predictor externo que no duplica la observación paso a paso, sino que se activa cuando es probable que ocurra un fallo y desvía al agente de una acción equivocada. Tras el ajuste fino supervisado (SFT) con escenarios sintéticos y el coentrenamiento con GRPO, el método logró una mejora del 24,3 % en ScienceWorld y del 7,7 % en WebArena-Lite para Claude Sonnet 4.5.
Problema: al agente le falta conocimiento sobre el entorno
Los agentes avanzados basados en LLM de tipo «caja negra» se desempeñan bien en el razonamiento a largo plazo y en la generación precisa de acciones. Sin embargo, no tienen conocimientos adquiridos sobre cómo evoluciona el entorno para una tarea agentiva concreta. El artículo arXiv:2610.29139, presentado el 21 de octubre de 2026, describe esta brecha.
Un modelo del mundo proporciona al agente conocimientos sobre un entorno concreto. Predice cómo reaccionará el entorno ante la acción que el agente está a punto de realizar. Ese modelo añade información sobre la tarea.
Criterio práctico: comprobar la conexión entre el modelo del mundo y el entorno objetivo. Los conocimientos generales sobre razonamiento no cierran la brecha en la comprensión de una tarea concreta.
Modo de corrección: en los puntos de riesgo, no en cada paso
Los modelos del mundo anteriores para agentes basados en LLM predicen principalmente la siguiente observación en cada paso. Este modo es costoso y aporta poca información. Las observaciones individuales ofrecen una orientación limitada y vinculada a la tarea. No es necesario anticiparse en cada paso.
Un estudio piloto mostró que la orientación del modelo del mundo es más útil cuando anticipa trampas en un futuro limitado de varios pasos. Por tanto, la corrección debe activarse en los puntos de riesgo, no funcionar de forma continua.
| Opción | Qué se sabe |
|---|---|
| Predicción paso a paso | Predice la siguiente observación en cada paso; es costosa y aporta poca información. |
| Anticipación de trampas | Anticipa trampas en un futuro limitado de varios pasos; ofrece la orientación más útil. |
Criterio práctico: elegir un modo que se active ante una posible trampa y no consuma recursos de anticipación en cada paso.
Cómo funciona la anticipación de trampas
Los autores presentaron Pitfall Anticipation World Model (PAWM). El modelo funciona mediante tres elementos:
- interviene de forma selectiva cuando surge una posible trampa;
- predice un fallo inminente;
- aleja al agente de la trampa en el punto de riesgo.
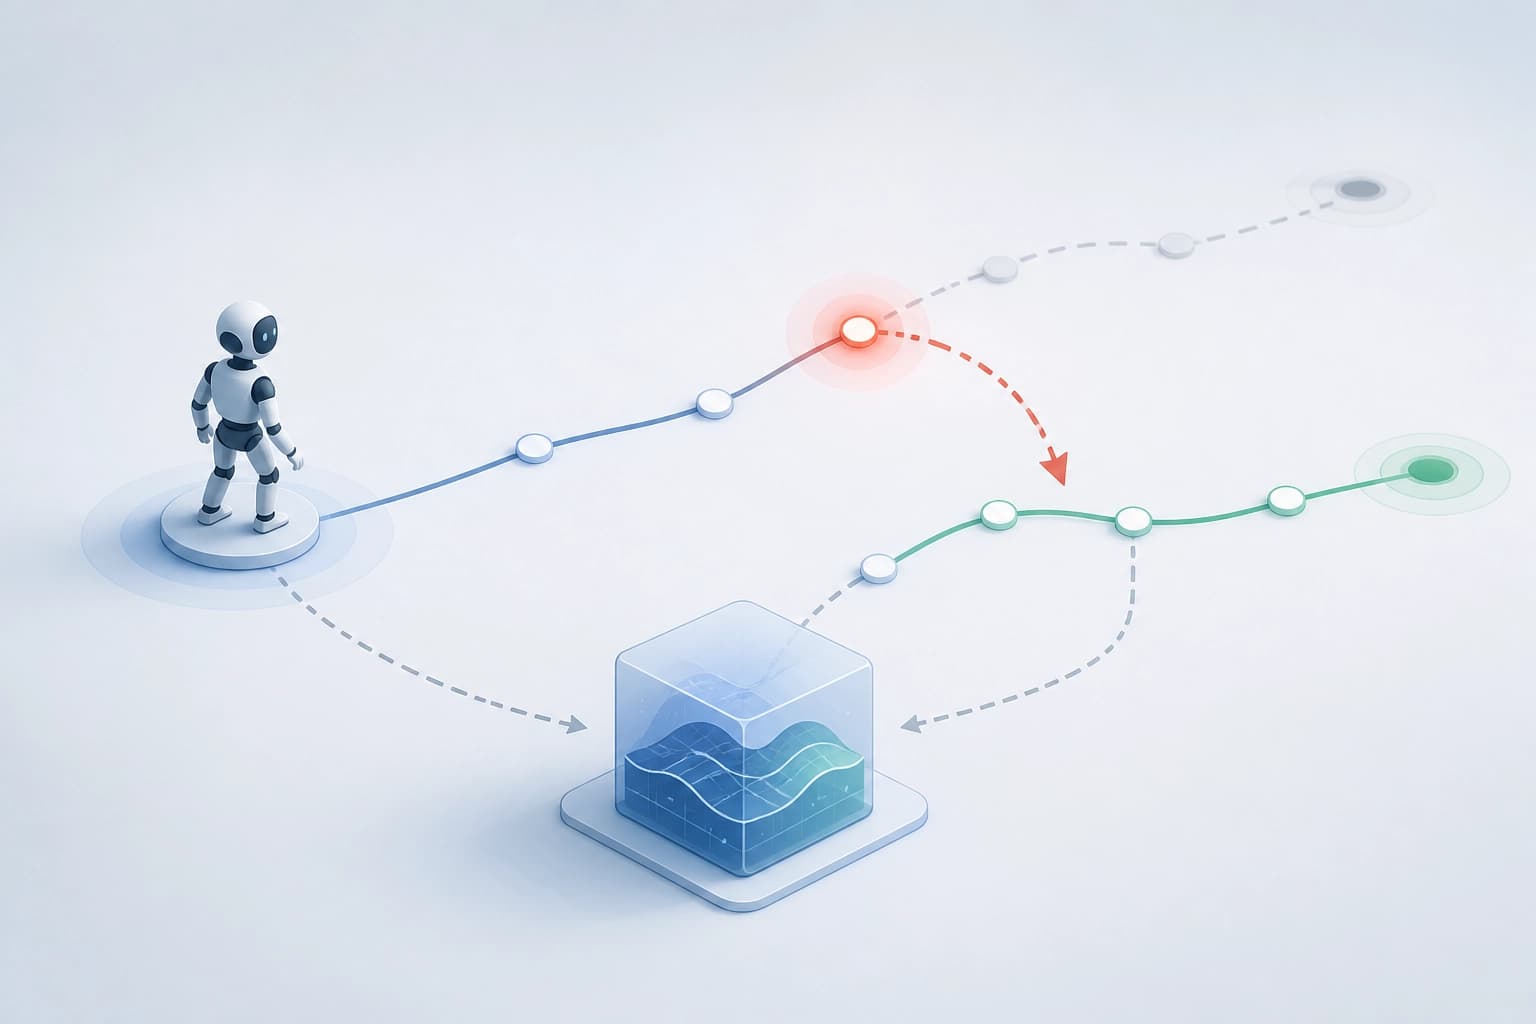
Criterio práctico: el activador de la corrección debe basarse en una posible trampa y en la predicción de un fallo inminente.
Entrenamiento del modelo en dos etapas
Los autores entrenan Pitfall Anticipation World Model (PAWM) en dos etapas.
- Supervised Fine-Tuning (SFT) con datos sintéticos. Los datos sintéticos incluyen etiquetas de trampas para agentes.
- Coentrenamiento con GRPO y un LLM de tipo «caja negra». Optimiza el modelo en el entorno objetivo.
Criterio práctico: comprobar ambas etapas: el etiquetado de trampas y el coentrenamiento en el entorno objetivo.
Evaluación: dónde observar las mejoras
El método mejora los resultados de Claude Sonnet 4.5 en un 24.3% en ScienceWorld y en un 7.7% en WebArena-Lite.
| Entorno | Mejora de Claude Sonnet 4.5 |
|---|---|
| ScienceWorld | 24.3% |
| WebArena-Lite | 7.7% |
Los autores también señalan que el modelo supera a varios métodos de referencia. Criterio práctico: observar las mejoras en el entorno objetivo y compararlas con los métodos de referencia. La transferencia de resultados entre entornos requiere una evaluación independiente.
Preguntas frecuentes
Material similar
Todos los materiales
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026
Capa de clasificación sobre SpeechLLM: dónde supera a la generación de etiquetas en el reconocimiento de emociones
En IEMOCAP y MELD se compara la predicción generativa de etiquetas emocionales con un clasificador lineal aplicado a las representaciones ocultas de una SpeechLLM compacta. La mejora en la calidad que aporta el clasificador no es universal: depende del corpus y de si se utilizan transcripciones de referencia o resultados de ASR.
4 noviembre 2026
De las puntuaciones individuales a los conjuntos admisibles: decodificación global bajo restricciones DDI
El artículo compara la selección global exacta de un conjunto compatible de medicamentos, implementada mediante programación lineal entera mixta, con varios esquemas locales para resolver conflictos de DDI con puntuaciones FLAME fijas en MIMIC-III. En el conjunto de prueba, la opción global ofrece una mejora pequeña pero constante en Jaccard, que aumenta al endurecer las restricciones y alcanza +0.0064 frente al método local de referencia más sólido.
4 noviembre 2026