
«गैर-मौखिक संकेत» स्पीच सिंथेसिस के लिए एक अलग सिरदर्द क्यों हैं
बोला गया टेक्स्ट अभी जीवंत भाषण के बराबर नहीं है। इंसान थकने पर आह भरता है, असहज पल में हँसी फूट पड़ती है, खालीपन भरने के लिए खाँसता है, और इन बारीकियों के बिना बेदाग़ उच्चारण भी ऑटो-रेस्पॉन्डर जैसा लगता है। इसीलिए गैर-मौखिक वोकलाइज़ेशन — NV, non-verbal vocalizations — को लंबे समय से «अभिव्यक्तिपूर्ण» स्पीच सिंथेसिस के संकेतकों में से एक माना जाता है: यह कागज़ से पढ़ने वाले रोबोट और उस आवाज़ के बीच फ़र्क़ करता है, जिस पर भरोसा करने का मन करता है।
मुश्किल यह है कि हँसी डालना तकनीकी रूप से कठिन नहीं है, लेकिन उसे सही जगह पर डालना — बिल्कुल दूसरे स्तर का काम है। शब्दों की सटीकता को अक्षरों और शब्दों में गिना जा सकता है, लेकिन किसी ख़ास वाक्य में आह या हल्की हँसी की उपयुक्तता — एक धुँधली श्रेणी है, जिसे औपचारिक रूप देना मुश्किल है और जिसकी स्वचालित जाँच लगभग असंभव है। पारंपरिक मेट्रिक्स यहाँ बेकार हैं: वे मॉडल को «अतिरिक्त» ध्वनि के लिए दंडित करेंगी, जबकि वही ध्वनि संवाद को इंसानी बना रही थी।
लेखक क्या पेश करते हैं: निर्देशों की जगह प्राथमिकताएँ
Preference Optimization for Non-Verbal Vocalization Synthesis (arXiv:2608.24163, eess.AS संग्रह, 25 अगस्त 2026 को प्रस्तुत) शीर्षक वाला यह काम इस विषय को प्राथमिकताओं पर प्रशिक्षण के नज़रिए से देखता है। लेखकों की टीम — Haoyang Li, Chenglin Xu, Junchuan Zhao, Yuang Cao, Liumeng Xue, Yiwen Guo और Eng Siong Chng।
मुख्य विचार सरल है: «यहाँ हँसी उपयुक्त है, यहाँ नहीं» जैसे नियम हाथ से लिखने के बजाय, मॉडल को ऑडियो विकल्पों के जोड़े दिखाए जा सकते हैं और संकेत दिया जा सकता है कि कौन-सा बेहतर है। लेकिन, जैसा शोधकर्ता बताते हैं, गैर-मौखिक वोकलाइज़ेशन पर इस दृष्टिकोण की उपयोगिता अब तक कम ही अध्ययनित है — यह स्पष्ट नहीं है कि कौन-से प्राथमिकता संकेत एकत्र करने हैं, जोड़े कैसे बनाने हैं और अनुकूलन का लक्ष्य क्या रखना है।
लेखकों ने एक साथ तीन अक्षों पर व्यवस्थित शोध किया: प्राथमिकता संकेतों के स्रोत, जोड़े बनाने के तरीके और DPO (Direct Preference Optimization) आधारित अनुकूलन लक्ष्य। मूल रूप से यह किसी नए एल्गोरिदम का आविष्कार नहीं, बल्कि एक नक्शा है — यह समझने की कोशिश कि पाइपलाइन में कौन-से निर्णय वाकई नतीजा बदलते हैं और कौन-से लगभग कुछ नहीं देते।
NV-CER: एक मेट्रिक जो शब्द और हँसी दोनों गिनती है
इस काम की एक अलग खोज है — NV-aware character error rate, या NV-CER। विचार यह है कि गैर-मौखिक अंतर्वेशनों को शोर मानना बंद किया जाए और उनके साथ आम शब्दों के समान व्यवहार किया जाए: NV-टैग भी वही आउटपुट प्रतीक बन जाते हैं, और पिनयिन आधारित भारित CER संयुक्त सामग्री — मौखिक और गैर-मौखिक दोनों — पर गिना जाता है।
ऐसी मेट्रिक का व्यावहारिक अर्थ नियंत्रणीयता में है। चूँकि गैर-मौखिक हिस्सा अब अलग से मापा जा सकता है, उसे अनुकूलन एल्गोरिदम को फिर से लिखे बिना इच्छित दिशा में लक्षित रूप से बढ़ाया जा सकता है। यह एक महत्वपूर्ण बात है: टीम जानबूझकर नई आर्किटेक्चर नहीं गढ़ती, बल्कि दिखाती है कि समस्या को सही ढंग से रखकर मौजूदा उपकरणों से अधिक कैसे निकाला जाए।
इसकी जाँच कैसे की गई
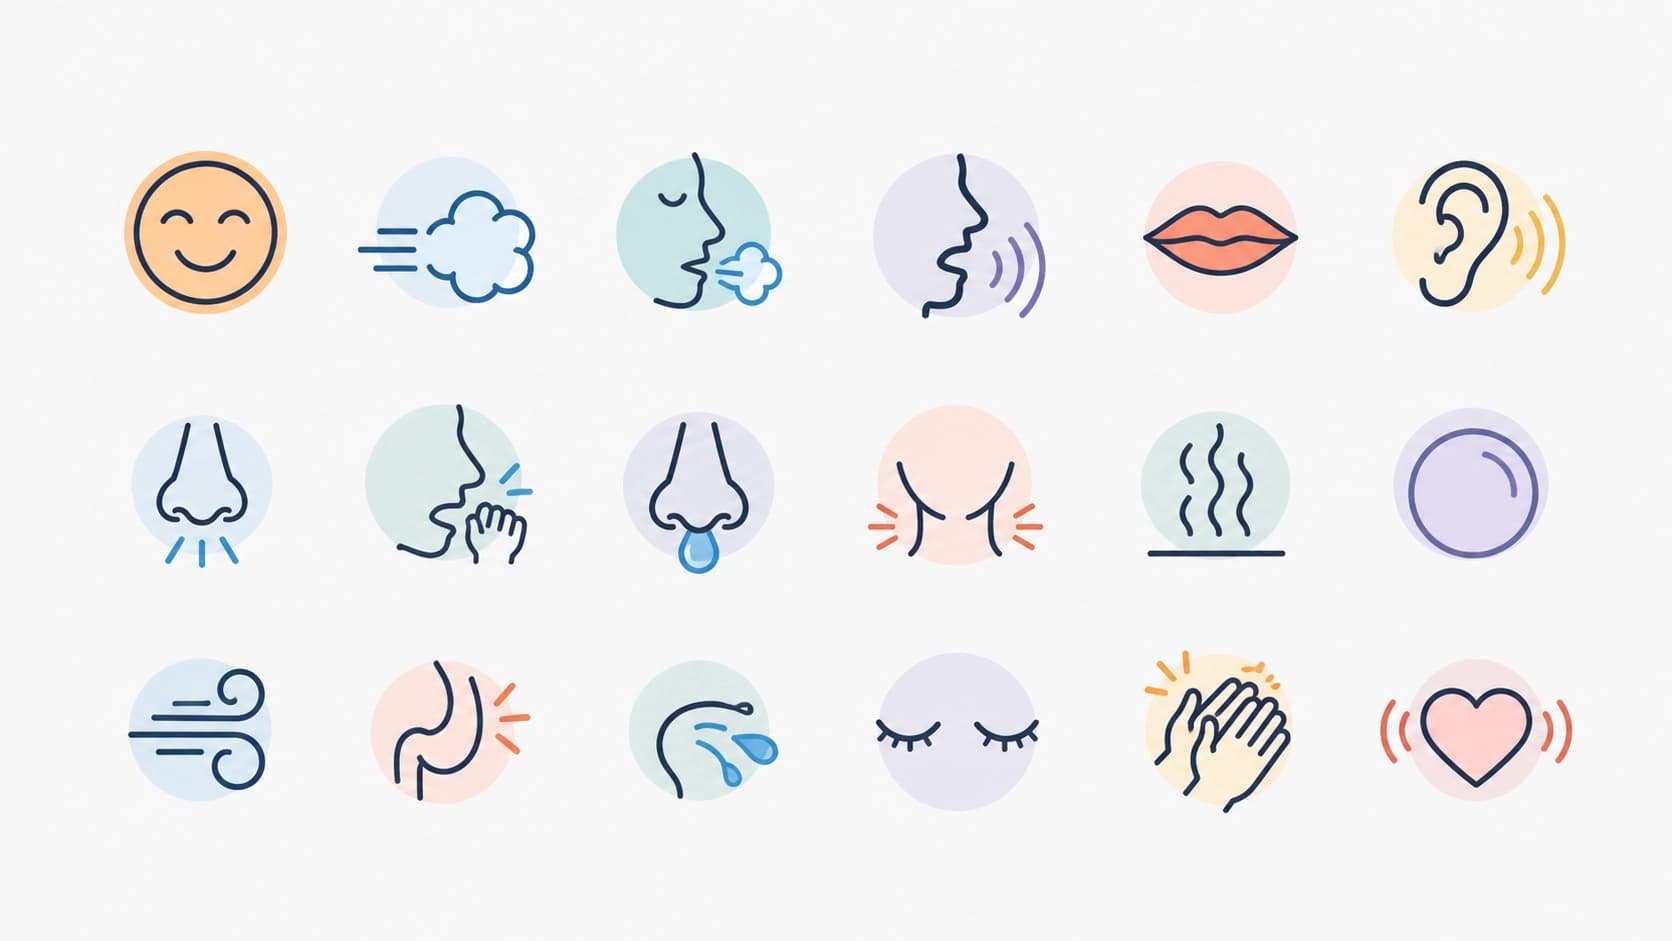
प्रयोग Emilia-NV डेटासेट पर, और साथ ही NV-Bench के विस्तारित संस्करण पर किए गए — एक ऐसा सेट जो 18 विभिन्न प्रकार के गैर-मौखिक वोकलाइज़ेशन को कवर करता है। इतनी विविधता महत्वपूर्ण है: हँसी, खाँसी और आह एक ही चीज़ नहीं हैं, और जो तरीका एक प्रकार के लिए काम करता है, वह दूसरे पर पूरी तरह विफल हो सकता है।
मूल्यांकन एक साथ तीन माध्यमों से किया गया: वस्तुनिष्ठ मेट्रिक्स, बड़े भाषा मॉडल द्वारा निर्णायन और मानवीय मूल्यांकन। तीनों प्रमाण-रेखाओं का मेल एक मज़बूत तर्क है, क्योंकि स्वचालित मेट्रिक्स और मानवीय धारणा के बीच अंतर ही आमतौर पर ऐसे शोध को बिखेर देता है।
नतीजों ने क्या दिखाया
मुख्य निष्कर्ष: कॉन्फ़िगरेशन मायने रखता है, लेकिन हर नहीं। डिज़ाइन के अलग-अलग विकल्प एक साथ दो चीज़ों पर अलग-अलग असर डालते हैं — मॉडल कितनी बार और कितनी स्वाभाविकता से वोकलाइज़ेशन करता है, और साथ ही कितनी सटीकता से शब्दों की सामग्री बनाए रखता है। यह एक क्लासिक समझौता है: अभिव्यक्ति पर बहुत आक्रामक ट्यूनिंग स्पष्टता को ख़राब करने लगती है।
साथ ही शोधकर्ता मानक DPO के आधार पर एक प्रभावी कॉन्फ़िगरेशन चुनने में सफल रहे — बिना किसी विचित्र अतिरिक्त परत के। यह मामूली नतीजा लगता है, लेकिन व्यवहार में यह चमकदार नतीजे से अधिक मूल्यवान है: इसका मतलब है कि तरीका पुनरुत्पादनीय है और उसे दुर्लभ संसाधनों की ज़रूरत नहीं।
इससे व्यवहार के लिए क्या निकलता है
यह काम अभिव्यक्तिपूर्ण सिंथेसिस के लिए NV-aware पोस्ट-ट्रेनिंग पर व्यावहारिक सिफ़ारिशों के एक सेट के रूप में प्रस्तुत किया गया है। कुछ निष्कर्ष जो इससे तर्कसंगत रूप से निकलते हैं:
- मेट्रिक व्यवहार तय करती है। जब तक गैर-मौखिक अंतर्वेशनों को एक अलग मापनीय इकाई नहीं बनाया जाता, मॉडल के पास इस दिशा में व्यवस्थित सुधार का कोई साधन नहीं होता।
- संकेत एल्गोरिदम से ज़्यादा मायने रखता है। मुख्य विविधता इस बात में है कि प्राथमिकताएँ कहाँ से आती हैं और जोड़े कैसे बनते हैं, न कि ऑप्टिमाइज़र के चुनाव में।
- अलग-अलग NV प्रकार — अलग-अलग कार्य। हँसी और आह अलग नियमों पर चलते हैं, और औसत संकेतक पर मूल्यांकन संभवतः कुछ छिपा देता है।
- तीहरी जाँच अनिवार्य है। वस्तुनिष्ठ, LLM- और मानवीय मूल्यांकनों की सहमति — नतीजे पर भरोसे की न्यूनतम शर्त है।
अगर व्यापक रूप से देखें, तो यह कहानी स्पीच सिंथेसिस में दृष्टिकोण बदलने की है। पहले गुणवत्ता का मतलब था «सही ढंग से बोले गए शब्द»। अब बात अक्सर इसकी होती है कि सिस्टम इंसान की तरह व्यवहार करना जानता है या नहीं: सही पल में चुप रहना, वहाँ हल्की हँसी देना जहाँ सामने वाला हँसता। और ऐसे व्यवहार के लिए, जैसा यह शोध दिखाता है, नया एल्गोरिदम नहीं, बल्कि एक ईमानदार मेट्रिक और सही ढंग से एकत्र किया गया प्राथमिकता संकेत कहीं अधिक उपयोगी है।


