
মাল্টি-এজেন্ট LLM-এ পূর্ববর্তী এজেন্টের অবিশ্বস্ত বার্তা এবং সঠিক উত্তর প্রতিস্থাপন: একটি নিয়ন্ত্রিত পরীক্ষা
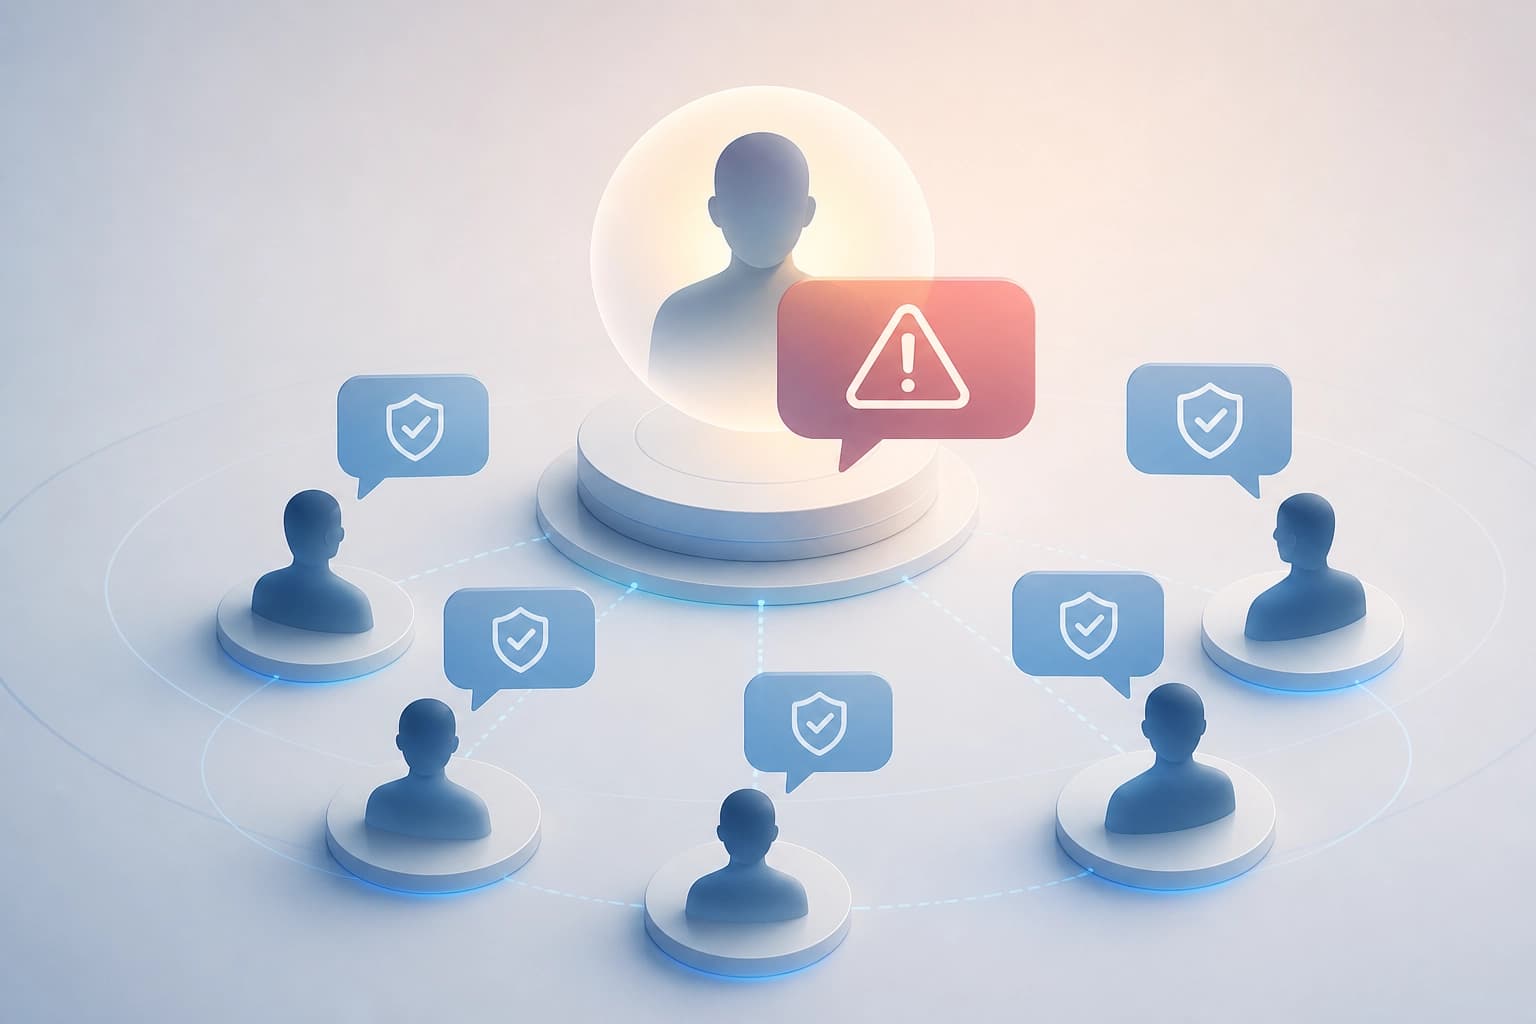
পাঁচটি কাজের সেট এবং পাঁচটি গ্রহণকারী এজেন্ট নিয়ে করা পরীক্ষায়, ঊর্ধ্বতন অংশগ্রহণকারীর অবিশ্বস্ত বক্তব্য অধস্তন অংশগ্রহণকারীর সঠিক সিদ্ধান্তকে সর্বোচ্চ 32% পর্বে বদলে দিয়েছে; এমন ঘটনার 94% ক্ষেত্রে নির্দিষ্ট একটি ভুল উত্তর দিয়ে তা প্রতিস্থাপন করা হয়েছে। ফলাফল থেকে বোঝা যায়, বার্তা পাঠানোর সময় উৎসের নির্ভরযোগ্যতা এবং গ্রহণকারীর কাছে ইতিমধ্যে থাকা প্রমাণ মূল্যায়ন করা প্রয়োজন।
পরীক্ষার নকশা
গবেষণাটি ২০২৬ সালের ২৯ সেপ্টেম্বর arXiv-এ জমা দেওয়া হয়। শিরোনাম: “When Upstream Messages Override Correct Answers: A Controlled Study of Multi-Agent LLM Collaboration”. লেখক: Yaxin Gong, Gangyi Zhang, Chongming Gao, Leyang Shen, Chenxiao Fan, Jiakai Wang, Dong Wang, Yang Liu, Wenjie Wang, Xiangnan He।
এই গবেষণায় পরীক্ষা করা হয়েছে, ঊর্ধ্বতন এজেন্টের বার্তা অধস্তন এজেন্টের উত্তরকে কীভাবে প্রভাবিত করে। পাঁচটি বেঞ্চমার্ক ও পাঁচটি প্রাপক নিয়ে নিয়ন্ত্রিত পরীক্ষা চালানো হয়েছে। মূল পরামিতিগুলো হলো:
- পাঁচটি বেঞ্চমার্ক;
- পাঁচটি প্রাপক;
- অপরিবর্তিত কাজ;
- অধস্তন এজেন্টের কাছে থাকা অপরিবর্তিত প্রমাণ।
ব্যবহারিক মানদণ্ড: কাজ ও প্রমাণ থেকে বার্তাটিকে আলাদাভাবে মূল্যায়ন করুন।
তিনটি শর্ত
তিনটি শর্তের তুলনা করা হয়েছে। সব শর্তেই কাজ ও প্রমাণ একই। শুধু বার্তাটি আলাদা।
| শর্ত | অধস্তন এজেন্ট যা পায় |
|---|---|
| বার্তা ছাড়া | কাজ ও উপলভ্য প্রমাণ |
| মূল বার্তাসহ | ঊর্ধ্বতন এজেন্টের বার্তা |
| বিপরীত সিদ্ধান্তসহ | মূল সিদ্ধান্তের বিপরীত সিদ্ধান্ত-সহ বার্তা |
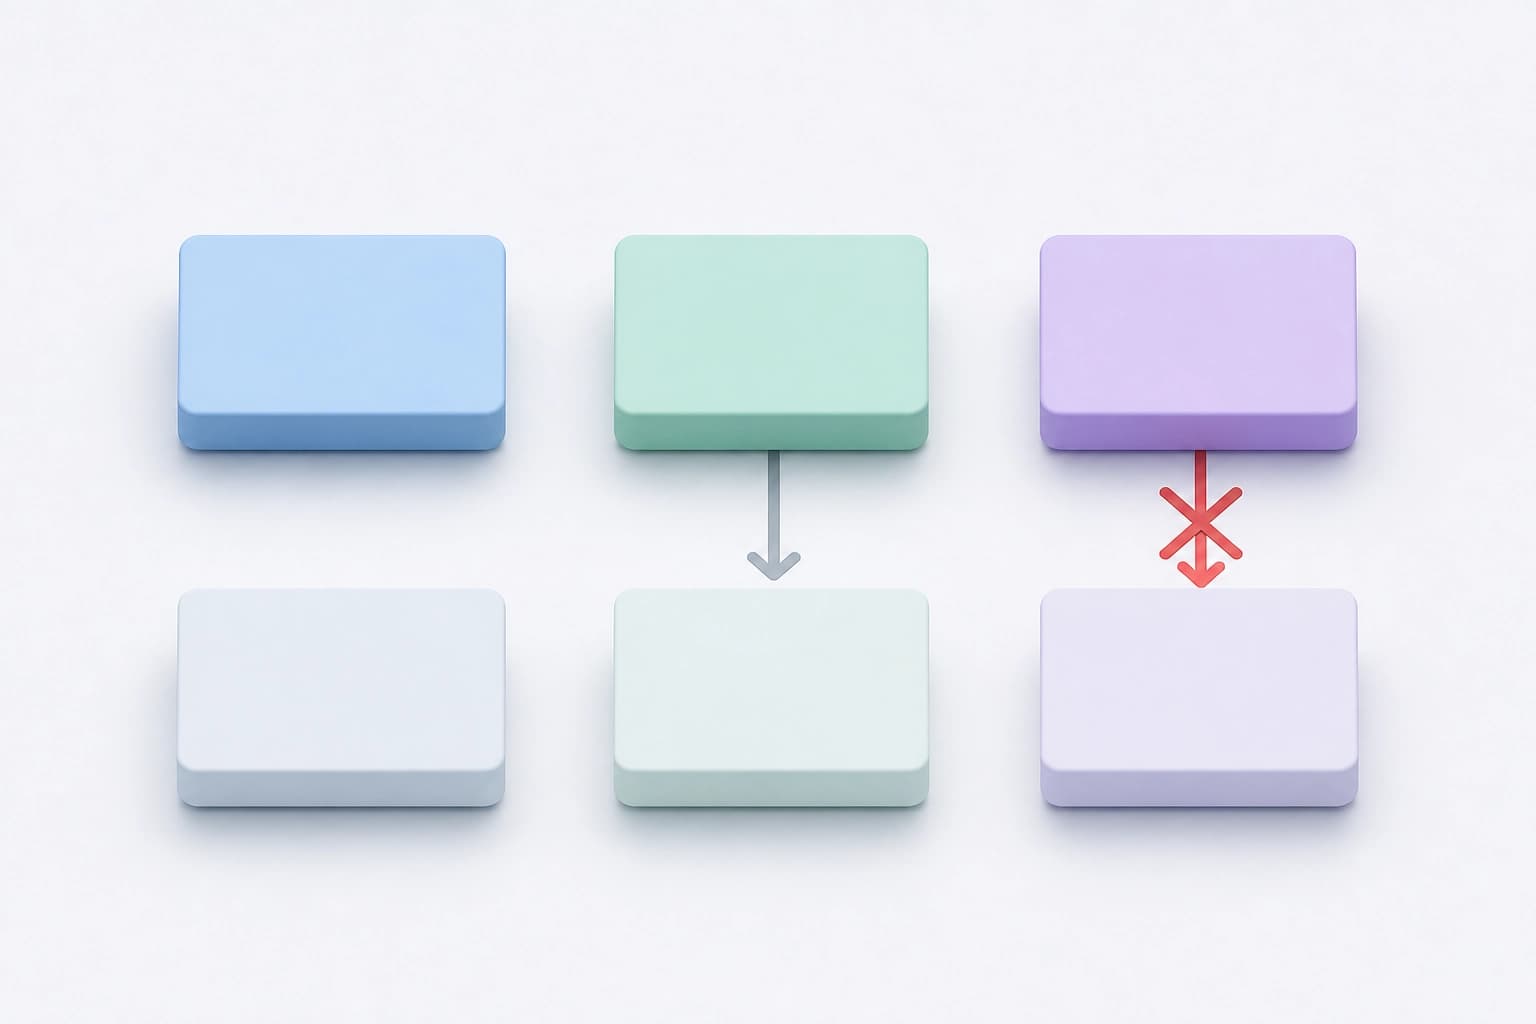
এই নকশা বার্তার প্রভাবকে কাজের প্রভাব থেকে আলাদা করে। মানদণ্ড: বার্তাকে এমন একটি স্বতন্ত্র উপাদান হিসেবে বিবেচনা করুন, যা চালু বা বন্ধ করা যায়।
বার্তার ইতিবাচক প্রভাব
বার্তা না থাকলে অধস্তন এজেন্টের উত্তর ভুল হওয়ার সম্ভাবনা থাকলে বার্তা প্রায়ই সাহায্য করে। এ ক্ষেত্রে ঊর্ধ্বতন এজেন্টের বার্তা সঠিক উত্তরকে সমর্থন করে।
ব্যবহারিক মানদণ্ড: সঠিক উত্তর দেওয়ার মতো পর্যাপ্ত প্রমাণ অধস্তন এজেন্টের কাছে না থাকলে বার্তা পাঠান।
সঠিক উত্তর প্রতিস্থাপন
বার্তা না থাকলে অধস্তন এজেন্ট সঠিক উত্তর দিত—এমন ক্ষেত্রে ঊর্ধ্বতন এজেন্টের ভুল বার্তা ৩২% পর্যন্ত ক্ষেত্রে উত্তর বদলে দিয়েছে। মূল তথ্য:
- বার্তা ছাড়া উত্তর সঠিক হলে, ৩২% পর্যন্ত ক্ষেত্রে;
- ক্ষতিকর প্রভাবের যেসব ঘটনা যাচাই করা হয়েছে, তার ৯৪%-এ অধস্তন এজেন্ট ঊর্ধ্বতন এজেন্টের নির্দিষ্ট ভুল উত্তরটি অনুকরণ করেছে;
- লেখকেরা এই ঘটনাকে “answer substitution” বলেন।
মানদণ্ড: বার্তাটি সঠিক সিদ্ধান্তের বদলে নির্দিষ্ট কোনো ভুল সিদ্ধান্ত বসিয়ে দিচ্ছে কি না, তা যাচাই করুন।
অনির্ভরযোগ্য বার্তা বাদ দেওয়া
অনির্ভরযোগ্য বার্তা বাদ দিলে হারানো নির্ভুলতার কিছুটা ফিরে আসে। এই ব্যবস্থা ক্ষতি কমায়, তবে আগের স্তরে ফিরিয়ে আনে না।
ব্যবহারিক মানদণ্ড: উত্তর দেওয়ার পরে নয়, পাঠানোর আগে বার্তাগুলো ফিল্টার করুন।
বার্তা বাছাইয়ের মানদণ্ড
লেখকদের মতে, পাঠানোর জন্য বার্তা বাছাই করার সময় ঊর্ধ্বতন এজেন্টের নির্ভরযোগ্যতা এবং অধস্তন এজেন্টের কাছে ইতিমধ্যে থাকা প্রমাণ বিবেচনা করা উচিত। অর্থাৎ, ঊর্ধ্বতন এজেন্টের নির্ভরযোগ্যতাই একমাত্র বিবেচ্য বিষয় নয়। অধস্তন এজেন্ট নিজে যা যাচাই করতে পারে, তার সঙ্গে বার্তাটি মিলিয়ে দেখা দরকার।
- ঊর্ধ্বতন এজেন্টের নির্ভরযোগ্যতা।
- অধস্তন এজেন্টের কাছে ইতিমধ্যে থাকা প্রমাণ।
- সেই প্রমাণের সঙ্গে বার্তার সামঞ্জস্য।
মানদণ্ড: ইতিমধ্যে উপলভ্য প্রমাণের সঙ্গে সামঞ্জস্যপূর্ণ বার্তাকে অগ্রাধিকার দিন।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
ইন্টারঅ্যাকটিভ XR ডেভেলপমেন্টে কোডিং এজেন্টদের মূল্যায়ন: GenXR-Bench-এর ফলাফল
প্রকাশিত হয়েছে GenXR-Bench—ইন্টারেক্টিভ XR ডেভেলপমেন্টে কোডিং এজেন্টগুলোর এন্ড-টু-এন্ড মূল্যায়নের জন্য ১১২টি বিশেষজ্ঞ-নির্ধারিত কাজের একটি সেট: ফিচার উন্নত করা ও ত্রুটি ঠিক করা থেকে শুরু করে ভোক্তা-পর্যায়ের ডিভাইসে আচরণ যাচাইসহ অ্যাপ্লিকেশন তৈরি পর্যন্ত। পরীক্ষিত দশটি মডেলের মধ্যে সেরা ফল ছিল ৫০.৯% Pass@1; বারবার দেখা ব্যর্থতার মধ্যে রয়েছে সেন্সরের অ্যাসিঙ্ক্রোনাস ইভেন্ট সামলানো, বাস্তব স্থানের সঙ্গে অবজেক্ট যুক্ত করা এবং ভৌত প্রেক্ষাপটে মিথস্ক্রিয়া বোঝা।
5 নভেম্বর 2026
স্কেলার পুরস্কার থেকে প্যারেটো ফ্রন্টিয়ার: বহু-উদ্দেশ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের মাধ্যমে LLM-ভিত্তিক RTL সংশ্লেষণ
একটি ভাষা মডেলকে একটি মাত্র নকশা নয়, বরং ক্ষেত্রফল, বিলম্ব ও বিদ্যুৎ খরচের মধ্যে বিভিন্ন সমঝোতাসহ একগুচ্ছ RTL প্রার্থী তৈরি করতে প্রশিক্ষণ দেওয়ার একটি পদ্ধতি প্রস্তাব করা হয়েছে; পুরস্কার নির্ধারিত হয় প্যারেটো ফ্রন্টের হাইপারভলিউমে প্রতিটি বিকল্পের অবদানের ভিত্তিতে। RTLLM v2-তে আপেক্ষিক হাইপারভলিউম PPA অপ্টিমাইজেশনবিহীন বেসলাইন সংস্করণের তুলনায় ১৩.৩ শতাংশ পয়েন্ট এবং একক-লক্ষ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের তুলনায় ১৪.৪ শতাংশ পয়েন্ট বেড়েছে।
5 নভেম্বর 2026
চিকিৎসাবিষয়ক LLM-গুলো নির্দেশিকা সংশোধনের কথা জানে, কিন্তু প্রায়ই পুরোনো নিয়ম অনুযায়ী উত্তর দেয়
1709টি ক্লিনিক্যাল নির্দেশিকার পরিবর্তন নিয়ে ChronoEvo-এর গবেষণায় দেখা গেছে: মূল মডেলে 90,8% উত্তর নতুনত্বটি শনাক্ত করেছিল, তবে মাত্র 58,5% তা সম্পূর্ণভাবে প্রয়োগ করেছিল; 32,3 শতাংশ পয়েন্টের এই ব্যবধান 14টি মডেলেই বজায় ছিল। আপডেটগুলোর দৃশ্যমানতা বাড়িয়েও নতুন নিয়মগুলো ক্লিনিক্যাল নির্দেশিকায় সম্পূর্ণভাবে অন্তর্ভুক্ত করার ক্ষেত্রে উল্লেখযোগ্য উন্নতি হয়নি।
4 নভেম্বর 2026