
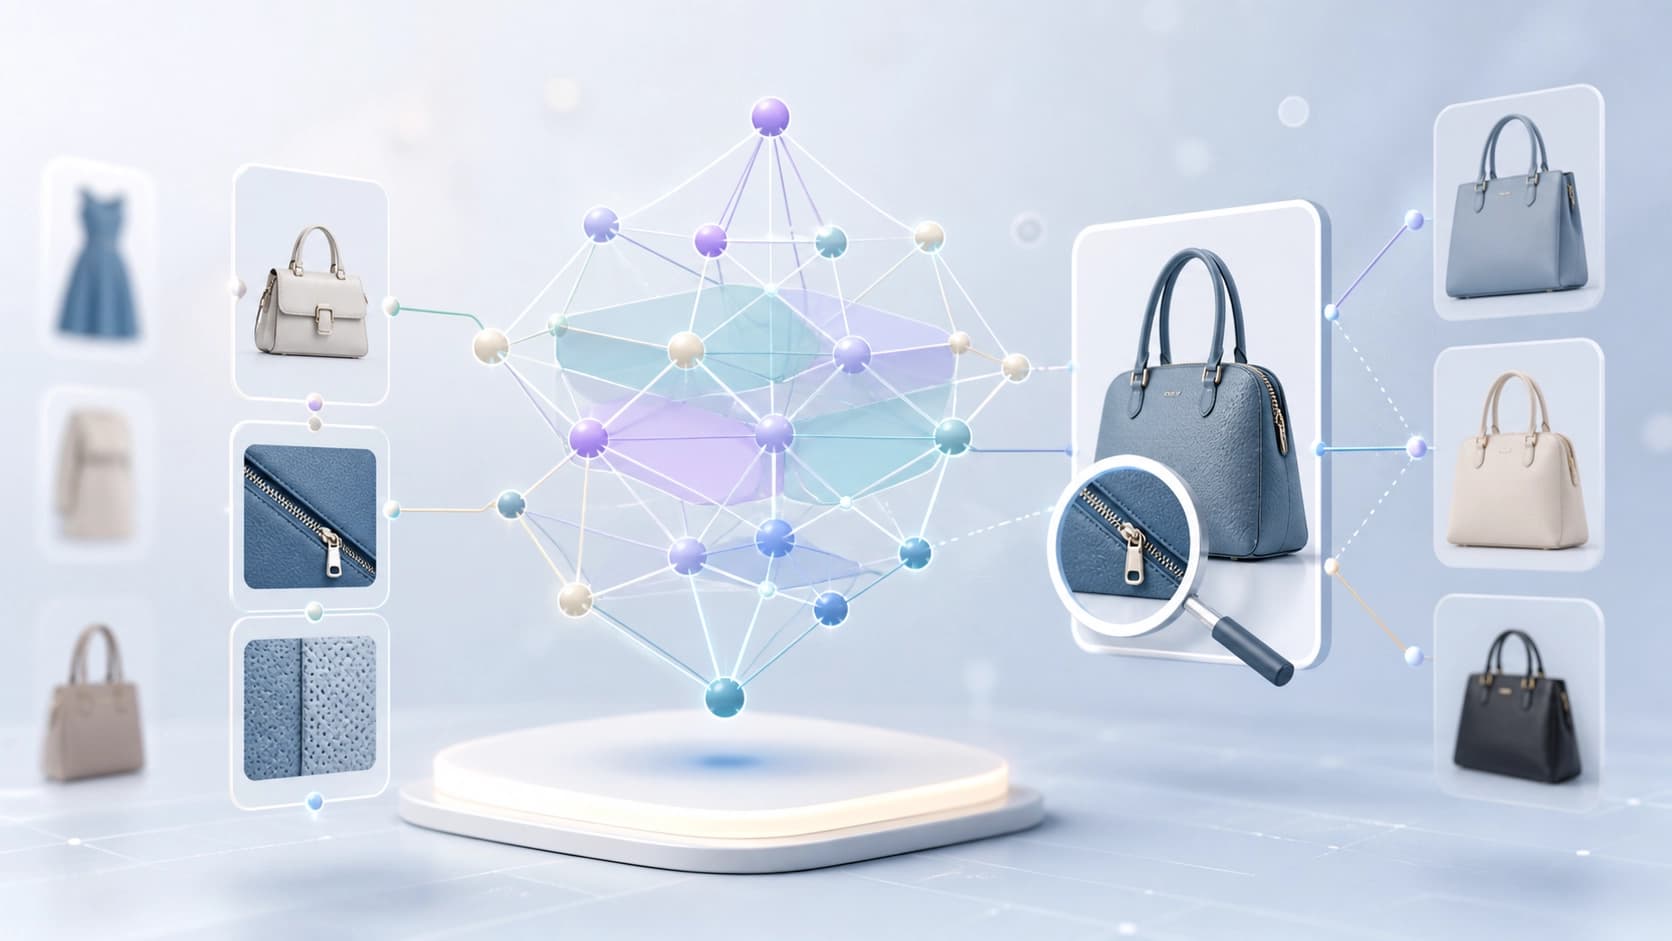
उत्पाद अंतरिक्ष में एक बिंदु तक सीमित नहीं है
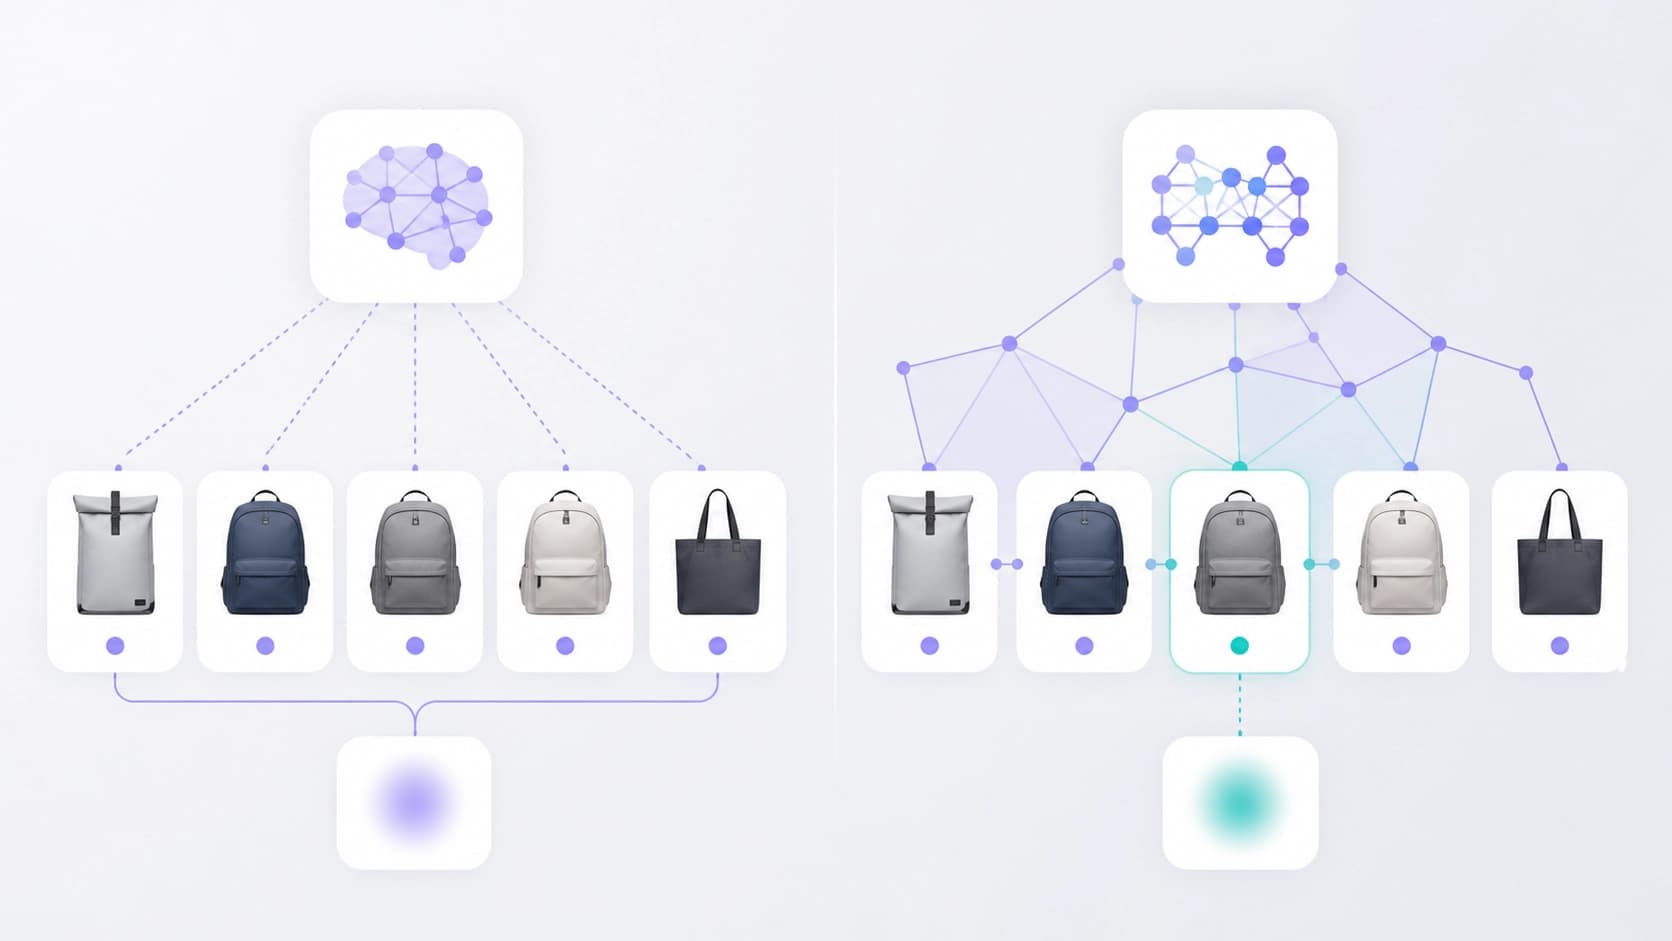
मल्टीमॉडल बड़े भाषा मॉडल उत्पाद कार्डों को "समझने" में काफी हद तक सक्षम हो गए हैं: वे फ़ोटो, नाम और विवरण को एक एकीकृत अर्थ क्षेत्र में जोड़ते हैं। लेकिन इस योजना में एक छिपी हुई लागत है। उत्पाद की जानकारी एक वैश्विक एम्बेडिंग में संपीड़ित हो जाती है — एक औसत वेक्टर, जिसमें विवरण घुल जाते हैं। मॉडल जितना अधिक एक साथ सब कुछ समाहित करने की कोशिश करता है, अंतिम वेक्टर में विशिष्टता उतनी ही कम बचती है।
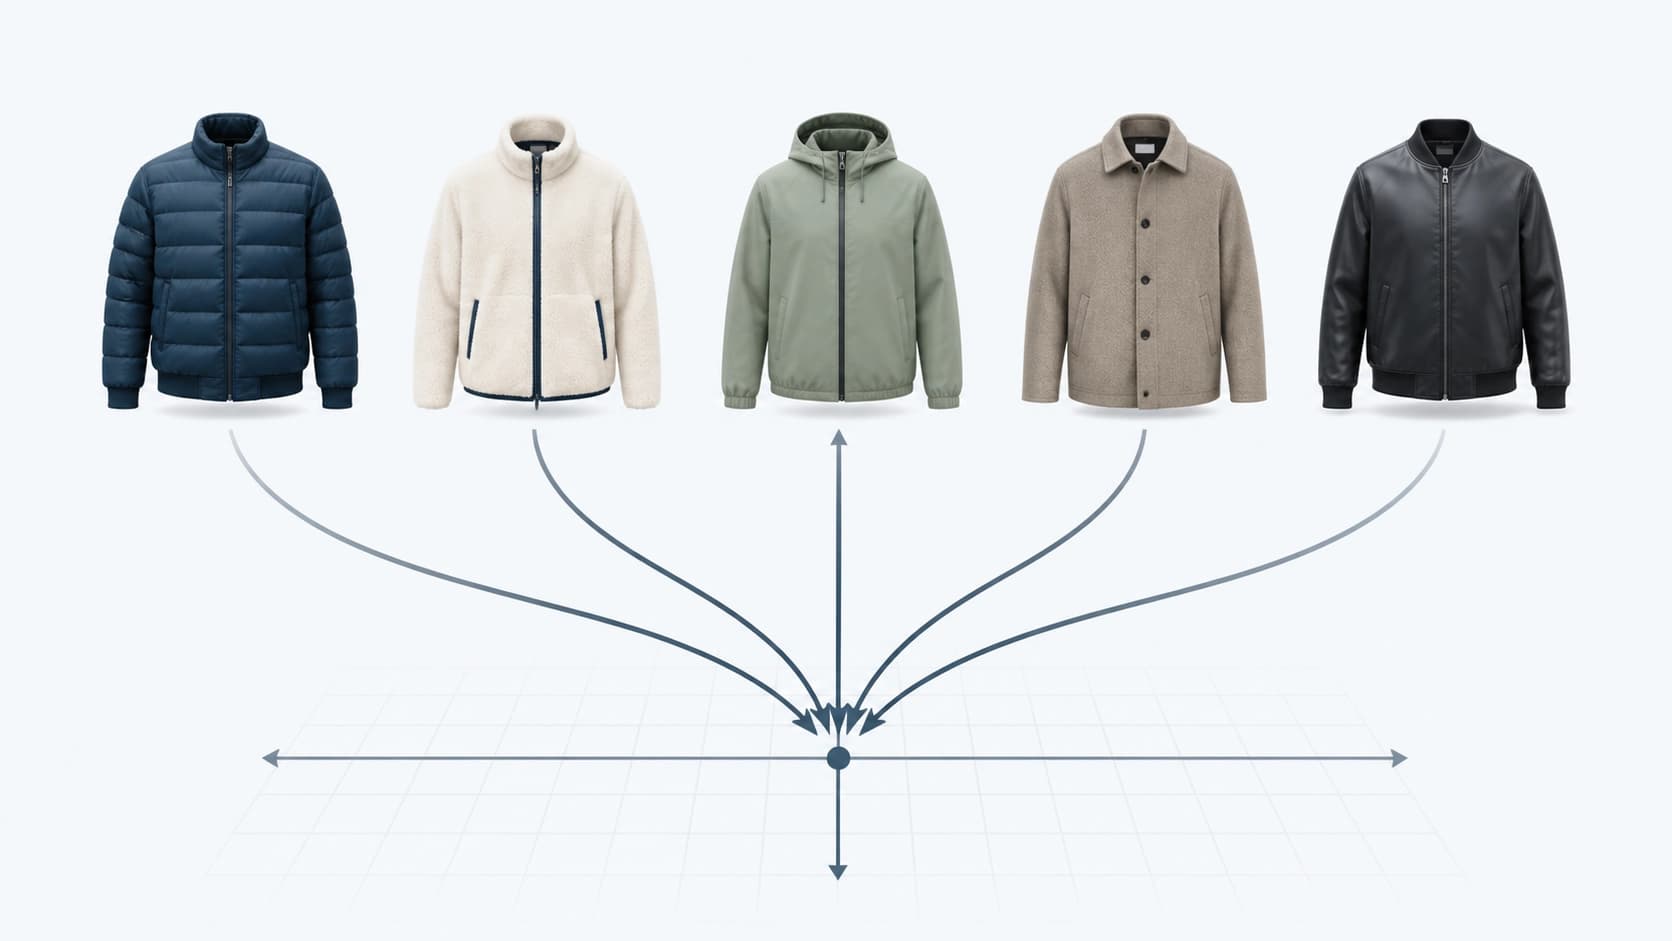
इस संक्षिप्तता की कीमत उन कार्यों में दिखती है जहाँ बारीकियाँ ही महत्वपूर्ण होती हैं। अलग-अलग सामग्री की दो जैकेटें, लगभग एक जैसे ग्लेज़ वाली दो मग, अलग-अलग कनेक्टर वाले दो केबल — दिखने में वे लगभग जुड़वाँ होते हैं, और एम्बेडिंग अंतरिक्ष में लगभग एक ही बिंदु पर आ जाते हैं। जबकि उपयोगकर्ता "कुछ समान" नहीं, बल्कि एक विशिष्ट सामग्री, संगतता या विशेषता खोज रहा होता है। ऐसी क्वेरीज़ पर ही औसत निकालना बाधा बनने लगता है: मॉडल विशेषताओं में अंतर नहीं कर पाता, और इसलिए रैंकिंग भी अनुमानित रह जाती है।
arXiv:2608.24467 लेख (Qiuyu Zhu, Yi Gao, Zhichao Wan, Mingyang Ma, अगस्त 2026) सीधे निदान करता है: वैश्विक एम्बेडिंग उत्पाद को समग्र रूप से अंतर्निहित रूप से एन्कोड करते हैं, और यह सूक्ष्म-कणिक विशेषताओं को पकड़ने को सीमित करता है। क्या इसे साधारण "वेक्टर को बड़ा कर दें" से ठीक किया जा सकता है? कार्य के तर्क को देखते हुए — नहीं, समस्या आयाम में नहीं, बल्कि प्रस्तुति के तरीके में है।
एम्बेडिंग की सपाट सूची के बजाय हाइपरग्राफ
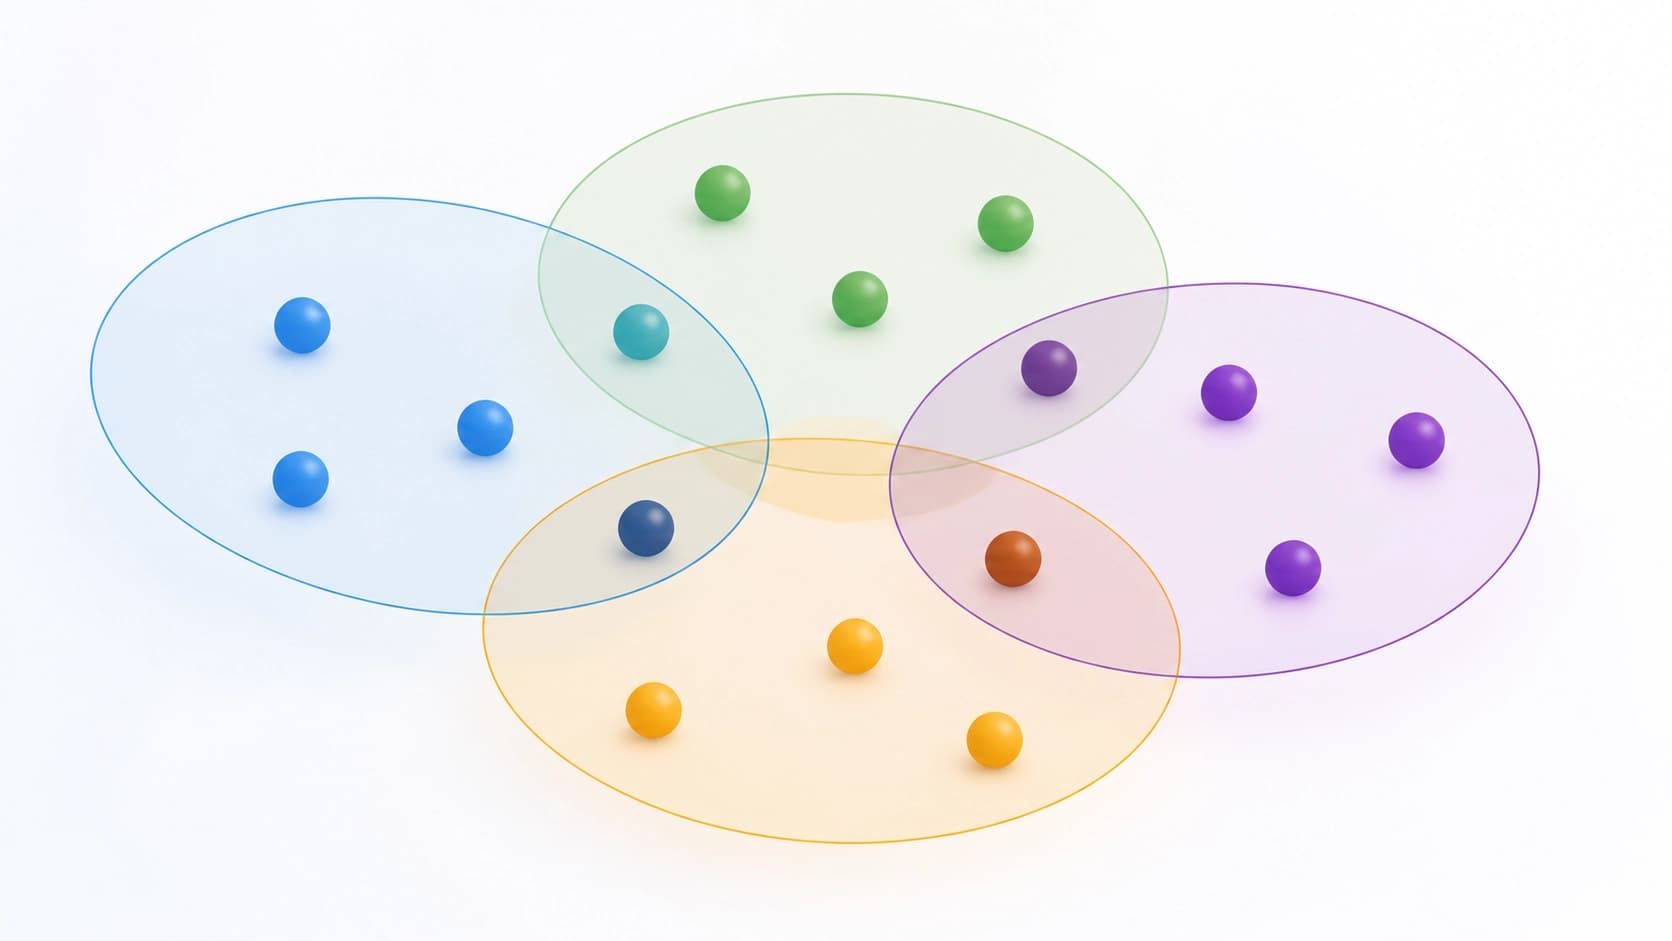
लेखक HMGCLIP प्रस्तावित करते हैं — एक मल्टीमॉडल एम्बेडिंग फ्रेमवर्क, जिसका आधार एक विषमांगी हाइपरग्राफ है। सामान्य ग्राफ से अंतर मूलभूत है। सामान्य किनारा दो वस्तुओं को जोड़ता है; हाइपरएज एक साथ एक समूह को जोड़ता है — उदाहरण के लिए, एक ही श्रेणी के सभी उत्पाद, जो एक सामान्य विशेषता से जुड़े हैं। ऐसी संरचना उन संबंधों का वर्णन करने की अनुमति देती है जिन्हें जोड़ों में विभाजित नहीं किया जा सकता: "ये सात आइटम — सामग्री की एक श्रृंखला", "ये चार — परस्पर विनिमेय विकल्प"।
आगे हाइपरग्राफ की टोपोलॉजी दो दिशाओं में काम करती है। पहला, इससे संरचनात्मक रूप से जागरूक जटिल नेगेटिव निकाले जाते हैं — वे समान लेकिन गलत उदाहरण, जिन पर मॉडल अंतर करना सीखता है। यह एक महत्वपूर्ण बिंदु है: जटिल नेगेटिव कॉर्पस से यादृच्छिक रूप से नहीं चुने जाते, उन्हें स्वयं संबंधों की संरचना सुझाती है। दूसरा, हाइपरग्राफ के माध्यम से बहु-कणिक अर्थशास्त्र का समन्वय होता है — संबंधों के स्तर पर भी, और हाइपरएज के स्तर पर भी। सरल शब्दों में, मॉडल न केवल अलग-अलग उत्पादों को, बल्कि पूरे अर्थ समूहों को भी आपस में संरेखित करता है।
द्वि-कणिक अनुमान तंत्र की आवश्यकता क्यों है
एक अलग विवरण — dual-granularity inference। आउटपुट पर सिस्टम विशेषता-संबंधी प्रमाणों को गतिशील रूप से इस तरह संयोजित करता है कि सूक्ष्म-कणिक और स्थूल-कणिक दोनों कार्यों के साथ समान आत्मविश्वास से काम कर सके। व्यावहारिक अर्थ यह है कि एक क्वेरी को सामान्य स्तर चाहिए ("स्नीकर्स दिखाओ"), और दूसरी को अत्यंत संकीर्ण ("मेम्ब्रेन और विशिष्ट प्रकार के तल वाले स्नीकर्स")। केवल विवरणों पर केंद्रित मॉडल विस्तार में हार जाता है; केवल सामान्य पर केंद्रित — सटीकता में। यहाँ माना गया है कि सिस्टम स्वयं तय करता है कि किस स्तर पर देखना है।
डेटासेट और सत्यापन
लेखक केवल आर्किटेक्चर तक सीमित नहीं रहे: उन्होंने एक व्यापक सूक्ष्म-कणिक ई-कॉमर्स डेटासेट जारी किया, ताकि कार्य के लिए भविष्य की तुलनाओं हेतु एक पुनरुत्पादनीय बेंचमार्क उपलब्ध हो। यह शायद कार्य का उतना ही मूल्यवान हिस्सा है — सार्वजनिक डेटासेट के बिना सूक्ष्म-कणिक विभेदन पर बहस निरर्थक है, हर कोई अपने ही डेटा पर मापता है।
प्रयोग नए डेटासेट और सार्वजनिक बेंचमार्क MAVE पर किए गए। परिणाम स्पष्ट रूप से दावा किया गया है: यह दृष्टिकोण मजबूत मल्टीमॉडल एन्कोडर, मल्टीमॉडल LLM और ई-कॉमर्स के लिए आधारभूत समाधानों को पीछे छोड़ देता है। विशिष्ट आंकड़े और तालिकाएँ स्वयं कार्य में हैं; यहाँ निष्कर्ष महत्वपूर्ण है कि प्रस्तुति का संरचनात्मक दृष्टिकोण ऐसा लाभ देता है जो मॉडल को केवल जटिल बनाकर प्राप्त नहीं किया जा सकता।
व्यवहार में यह कहाँ उपयोगी होगा
पहला और सबसे स्पष्ट — खोज और विकल्पों का चयन। जब खरीदार खराब हो चुकी वस्तु का प्रतिस्थापन खोजता है, तो उसे चित्र की सामान्य समानता नहीं, बल्कि विशेषताओं के अनुसार संगतता चाहिए। दूसरा — सिफ़ारिशें: वे तब लाभ देती हैं जब वे भिन्न सामग्री वाले विकल्प को उसी उत्पाद के भिन्न कॉन्फ़िगरेशन से अलग कर सकें। तीसरा — कैटलॉग की स्वच्छता: डुप्लिकेट और लगभग-डुप्लिकेट, जो अभी स्वचालित रूप से अनुमान लगाकर जोड़ दिए जाते हैं, सूक्ष्म-कणिक प्रस्तुति में अधिक अर्थपूर्ण ढंग से अलग हो जाते हैं।
एक कम स्पष्ट परत भी है — व्याख्येयता। हाइपरएज एक ऐसी संरचना बनाते हैं जिससे दिखता है कि उत्पाद एक-दूसरे के पास क्यों आए। उन टीमों के लिए जो रैंकिंग की त्रुटियों से जूझती हैं, यह अस्पष्ट प्रकृति के वेक्टर से अधिक उपयोगी है।
अभी क्या खुला रह जाता है
ग्राफ संरचना के साथ कोई भी कार्य लागत पर अटकता है: हाइपरग्राफ बनाना पड़ता है, और कैटलॉग अपडेट होने पर उसे अद्यतन बनाए रखना पड़ता है। लाखों कार्डों पर यह कितना सस्ता है और इसे कितनी बार पुनर्निर्मित करना पड़ेगा, यह लेखक एनोटेशन में नहीं बताते।
दूसरा प्रश्न — स्थानांतरणीयता। डेटासेट एक ही विषय क्षेत्र में एकत्र किया गया है, और यह अज्ञात है कि हाइपरएज के व्यवहार की योजना, मान लीजिए, कपड़ों से इलेक्ट्रॉनिक्स की ओर जाने पर कितनी अच्छी तरह बनी रहेगी, जहाँ विशेषताएँ बिल्कुल अलग तरह से बनी होती हैं। तीसरा — यह दृष्टिकोण पहले से चल रहे प्रोडक्शन पाइपलाइनों के साथ कैसे तालमेल बिठाता है: प्रस्तुति का तरीका बदलने का अर्थ आमतौर पर पूरे सर्च इंडेक्स का पुनः-अनुक्रमण होता है।
जो भी हो, दिशा स्पष्ट रूप से चिह्नित है। बहस इस पर नहीं है कि किसका मॉडल बड़ा है, बल्कि इस पर कि उत्पाद का अर्थ सही ढंग से कैसे संग्रहित किया जाए: एक औसत बिंदु में या संबंधों के जाल में, जहाँ विवरण घुलते नहीं हैं।


