
तीन मॉडल, एक लाइसेंस और कोई शर्त नहीं
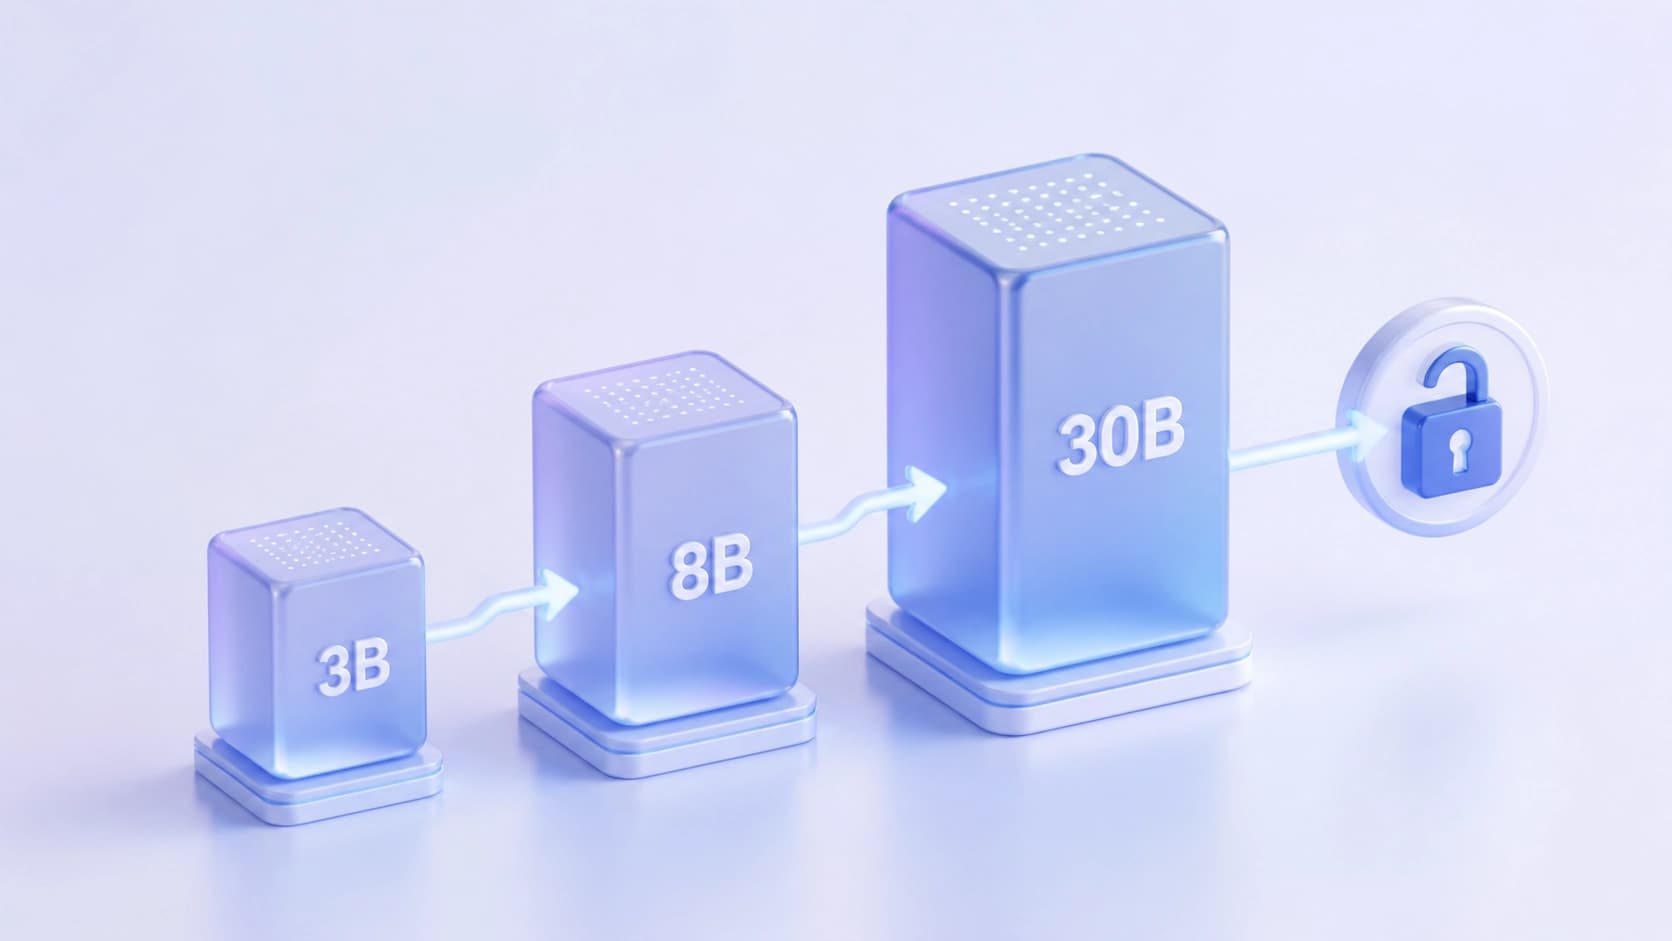
Granite 4.2 अब वह सहायक नहीं है जो पिछले रिलीज़ की तरह सिर्फ़ निर्देशों का पालन करने के लिए बना हो। IBM ने इस परिवार को स्पष्ट तर्क-प्रक्रिया के इर्द-गिर्द फिर से बनाया है: कोई भी मॉडल पहले चरणों की श्रृंखला बताता है, फिर जवाब तैयार करता है। इस रिलीज़ में तीन आकार हैं — 3B, 8B और 30B पैरामीटर।
बिज़नेस के लिए मुख्य खबर बेंचमार्क में नहीं, बल्कि लाइसेंस में है। तीनों मॉडल Apache 2.0 के तहत वितरित किए गए हैं: डाउनलोड करना, फ़ाइन-ट्यून करना और प्रोडक्शन में चलाना — इनमें न अतिरिक्त मंज़ूरी चाहिए, न व्यावसायिक उपयोग पर कोई प्रतिबंध। नियामकीय क्षेत्रों की कंपनियों के लिए, वेट्स को on-prem रखने की क्षमता अक्सर मेट्रिक्स की तालिकाओं की किसी भी पंक्ति से ज़्यादा मायने रखती है।
साथ ही दो स्पीच मॉडल Granite Speech 5.0 Turbo CTC भी जारी हुए हैं — प्रत्येक 470 मिलियन पैरामीटर के — इनके बारे में नीचे अलग से बात की गई है।
कार्य-मोड सीधे chat-टेम्पलेट में बदला जा सकता है। thinking है, non-thinking है, और इनके बीच — low-effort: सरल सवालों के लिए तर्क का छोटा बजट, ताकि जहाँ काम की ज़रूरत न हो वहाँ टोकन खर्च न हों। मूल रूप से, वही मॉडल दोनों काम करता है — "अच्छी तरह सोचो" और "जल्दी जवाब दो"।
किसके लिए कौन सा आकार
3B — अलग डेवलपर का लैपटॉप
सबसे छोटा मॉडल व्यक्तिगत डेवलपर्स और छोटे स्टार्टअप के लिए बनाया गया है। इसे Ollama या LM Studio के ज़रिए लोकली चलाया जा सकता है, जिसमें Q4_K_M तक के प्रकाशित GGUF-क्वांट भी शामिल हैं। यह परिदृश्य है "लैपटॉप पर इंस्टॉल किया और API बिल की चिंता के बिना प्रयोग किया"।
8B — एक टीम के लिए एक आधुनिक GPU
मध्यम आकार मिड-मार्केट टीमों के लिए है: एक आधुनिक ग्राफ़िक्स कार्ड ही मॉडल को कार्य-प्रवाह में बनाए रखने के लिए काफ़ी है।
30B — कॉर्पोरेट परिमंडल
सबसे बड़े वेरिएंट के लिए A100 या H100 स्तर की क्षमता चाहिए, साथ ही vLLM पर FP8 या NVFP4 में सर्विसिंग। लेकिन यह वह स्थिति है जहाँ मॉडल को परिमंडल के भीतर रखा जा सकता है और डेटा बाहर नहीं भेजना पड़ता।
IBM स्पष्ट रूप से जिन क्षेत्रों को निशाना बना रहा है: सॉफ़्टवेयर डेवलपमेंट और डेवलपर टूल्स, वित्तीय सेवाएँ, स्वास्थ्य सेवा, टेलीकॉम, सार्वजनिक क्षेत्र और कॉन्टैक्ट सेंटर — आख़िरी वाले ख़ास तौर पर नए स्पीच मॉडल के लिए। आम परिदृश्य हैं — कोड लिखने के लिए एजेंट, टर्मिनल और DevOps ऑटोमेशन, गहन शोध और खोज, लंबे दस्तावेज़ों पर RAG, संरचित टूल कॉलिंग और बड़े पैमाने पर ट्रांसक्रिप्शन।
आर्किटेक्चर: बिना किसी तरकीब के डेंस ट्रांसफ़ॉर्मर
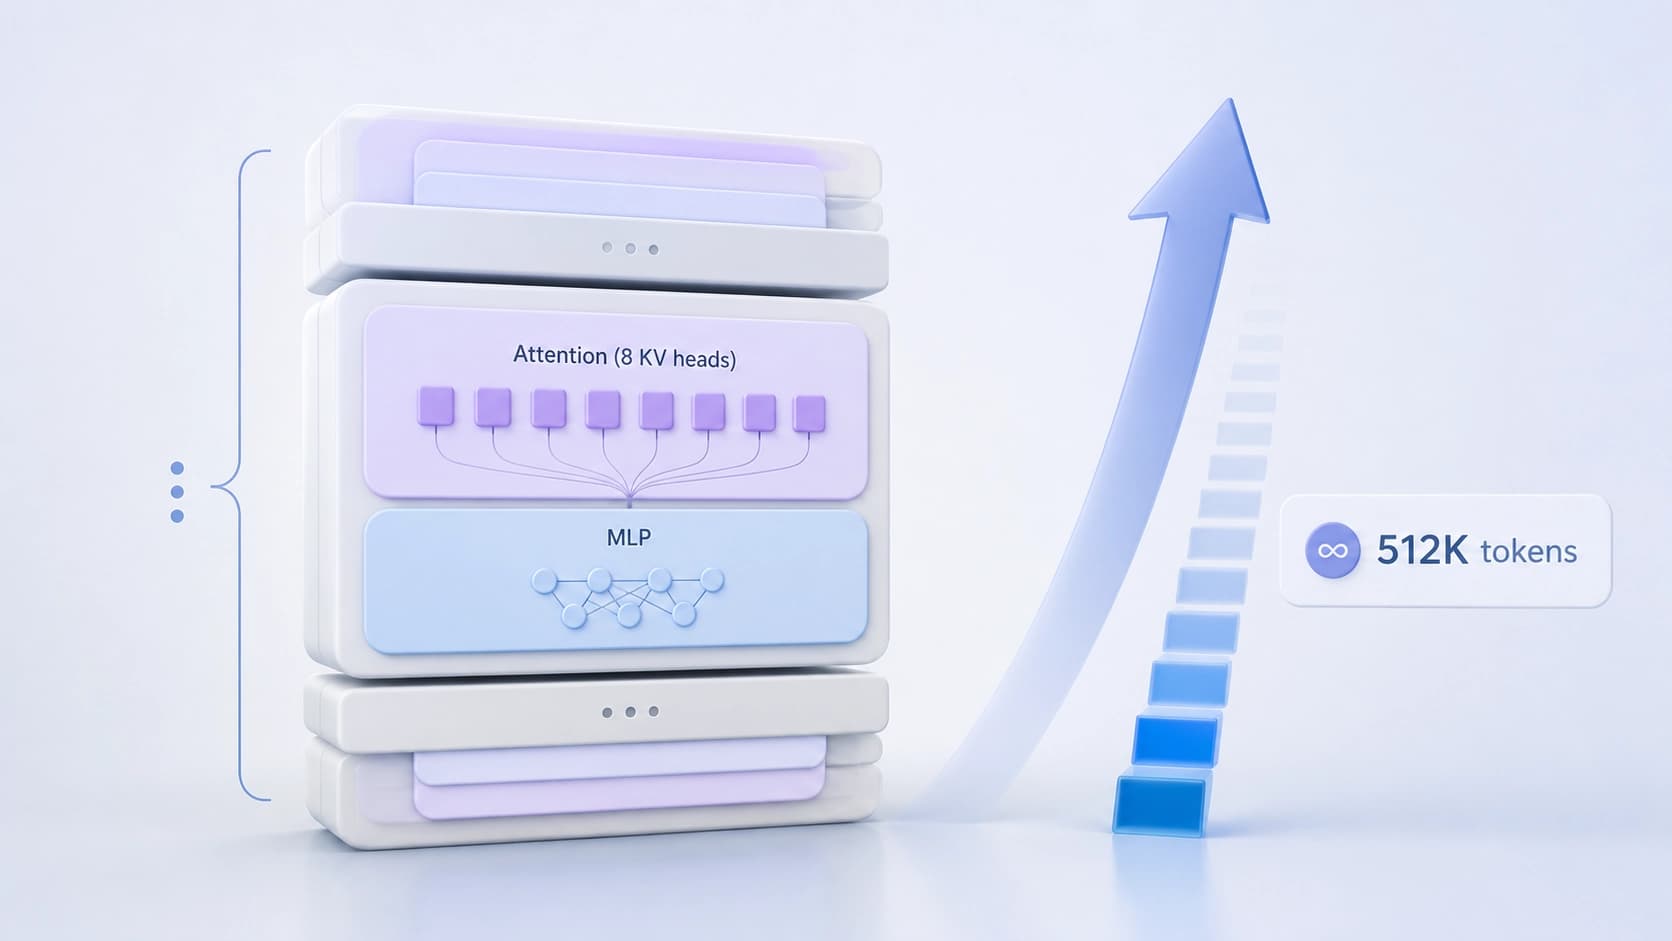
Granite 4.2 एक decoder-only डेंस ट्रांसफ़ॉर्मर है। कोई हाइब्रिडिटी नहीं, कोई mixture-of-experts नहीं: दांव व्यवहार की पूर्वानुमेयता और तैनाती की सरलता पर लगाया गया है, जो कॉर्पोरेट परिमंडल के लिए तर्कसंगत है।
तकनीकी ब्यौरों में से:
- 8 KV-हेड्स के साथ Grouped Query Attention;
- θ = 10 000 000 के साथ RoPE;
- MLP में SwiGLU;
- ε = 1e-5 के साथ RMSNorm;
- असंबद्ध इनपुट और आउटपुट एम्बेडिंग;
- bfloat16 परिशुद्धता।
आकार इस तरह भिन्न हैं: 3B में — 40 लेयर और 2560 की एम्बेडिंग, 8B में — वही 40 लेयर, लेकिन एम्बेडिंग 4096, 30B में — 64 लेयर और MLP का छिपा आकार 32 768।
प्रकाशित आर्किटेक्चर तालिका में अनुक्रम लंबाई 131 072 टोकन, यानी 128K, दर्शाई गई है। साथ ही प्री-ट्रेनिंग रन पाँच चरणों में था और इसमें 512K टोकन तक का लंबा-संदर्भ चरण शामिल था। शून्य से ट्रेनिंग लगभग 15 ट्रिलियन टोकन पर हुई।
ट्रेनिंग: SFT, फिर बहु-चरणीय RL
supervised fine-tuning चरण लगभग 7.2 मिलियन सैंपल्स पर आधारित था — करीब 100 बिलियन टोकन, जिनमें से लगभग 65 बिलियन प्रशिक्षण-योग्य। डेटा मिश्रण इस तरह वितरित है: 31.6% एजेंटिक उदाहरण बनाम 68.4% ग़ैर-एजेंटिक, और सॉफ़्टवेयर इंजीनियरिंग एजेंटिक हिस्से का 69% है।
ट्रैजेक्टरीज़ हार्नेस में एकत्र की गईं — इनमें OpenHands, SWE-agent, Terminus-2, MiniSWE, Codex और Goose शामिल हैं। गुणवत्ता दो तरह से फ़िल्टर की गई: निर्णायकों की भूमिका में GPT-OSS-120B और Gemma 4 थे, साथ ही tools और messages फ़ील्ड्स पर SHA-256 के आधार पर डीडुप्लीकेशन किया गया।
पोस्ट-ट्रेनिंग एक ही पास नहीं, बल्कि कई वातावरणों में RL की श्रृंखला है। हर चरण एक अलग अतुल्यकालिक GRPO रन है, जो पिछले चेकपॉइंट से warm-start होता है; value-नेटवर्क की जगह leave-one-out बेसलाइन इस्तेमाल होती है, और ट्रंकेटेड इम्पॉर्टेंस सैंपलिंग off-policy में ड्रिफ़्ट को सीमित करती है। क्रम इस प्रकार है: पहले RLVR, फिर skill boosters, फिर SWE, Terminal और Search, और अंत में RLHF।
यहीं रिलीज़ की सबसे अहम सीमा छिपी है: एजेंटिक RL ब्लॉक सिर्फ़ 8B और 30B पर लागू किया गया। सबसे छोटा 3B केवल बुनियादी RL और अलाइनमेंट से गुज़रता है — और आकारों के बीच क्षमता का अंतर काफ़ी हद तक इसी से समझाया जा सकता है। ट्रेनिंग NeMo-RL और NeMo-Gym पर NVIDIA GB200 NVL72 क्लस्टर पर हुई, जो CoreWeave में स्थित है। इसके अतिरिक्त पाइपलाइन में CodeAlchemy से 1 ट्रिलियन टोकन सिंथेटिक कोड और सर्विसिंग तेज़ करने के लिए स्पेक्युलेटिव डिकोडिंग की परत शामिल की गई।
IBM के मेट्रिक्स क्या दिखाते हैं
आँकड़े ख़ुद IBM ने बताए हैं, इसलिए इन्हें स्वतंत्र सत्यापन नहीं, बल्कि एक संकेत के रूप में पढ़ना चाहिए। मानों का क्रम — 3B / 8B / 30B:
- SWE-Bench Verified: 3B के लिए कोई स्कोर नहीं, 8B का — 47.6, 30B का — 57.00;
- Terminal-Bench 2.1: क्रमशः 20.56 और 29.24;
- τ³-bench: 50.99 / 66.34 / 68.05;
- BFCL v4: 52.41 / 50.29 / 61.39;
- AIME25: 78.33 / 86.67 / 89.17;
- GPQA: 54.80 / 64.14 / 66.41;
- MMLU-Pro: 67.84 / 74.04 / 77.60;
- RULER 128K: 55.30 / 71.41 / 81.38।
एक दिलचस्प ब्यौरा — फ़ंक्शन कॉलिंग टेस्ट में 8B, 3B से थोड़ा पीछे है (50.29 बनाम 52.41)। यह याद दिलाता है कि आकार अपने आप में हर अलग कौशल में बढ़त की गारंटी नहीं देता, और काम के हिसाब से मॉडल चुनना बड़े चेकपॉइंट के पीछे भागने से ज़्यादा ज़रूरी है।
स्पीच: LLM-बैकबोन के बिना 470 मिलियन पैरामीटर
Granite Speech 5.0 Turbo CTC स्पीच मॉडल भाषा-मॉडल आधारित पारंपरिक ASR सिस्टम से मूल रूप से अलग बने हैं: यहाँ LLM-बैकबोन बिल्कुल इस्तेमाल नहीं होता, और ऑडियो से टेक्स्ट रूपांतरण connectionist temporal classification के ज़रिए होता है। यही इसकी संक्षिप्तता का कारण है — 470 मिलियन पैरामीटर।
IBM एक H200 पर लगभग 12 600 का RTFx दावा करता है, जबकि Open ASR leaderboard में गति के मौजूदा अग्रणी करीब 6 000 दिखाते हैं। बड़ी मात्रा में रिकॉर्डिंग वाले कॉन्टैक्ट सेंटरों के लिए थ्रूपुट का यह अंतर सीधे पैसे में बदलता है। मॉडल को WebGPU पर एक डेमो में आज़माया जा सकता है।
कुल मिलाकर
IBM ने कॉर्पोरेट बाज़ार के लिए एक पूर्वानुमेय उत्पाद तैयार किया है: आर्किटेक्चर की विचित्रताओं के बिना डेंस मॉडल, खुला लाइसेंस, अपने हार्डवेयर पर तैनाती और अलग-अलग तरह के कामों के लिए तर्क-मोड। एजेंटिक क्षमताएँ 8B और 30B में केंद्रित हैं, इसलिए 3B को कम खर्चीला प्रवेश-बिंदु और सरल परिदृश्यों का मॉडल मानना तर्कसंगत है, न कि बिना किसी कमी वाला "छोटा भाई"। ब्यौरों की पुष्टि IBM Research के ब्लॉग, तकनीकी विवरण और GitHub रिपॉज़िटरी से करनी चाहिए, जिनके लिंक रिलीज़ के साथ दिए गए हैं।


