AI मॉडलों की प्राथमिकताएँ आज लगभग उसी तरह मापी जाती हैं जैसे इंसानों की मापी जाती थीं: सवाल पूछकर और जवाबों को देखकर। लेकिन हमें आउटपुट में असल में क्या मिलता है — मॉडल का गुण या प्रश्नावली का गुण? arXiv पर एक नया अध्ययन (2608.23641, लेखक Jason Hung, 24 अगस्त 2026) इसका बेहद ठोस जवाब देता है: जिसे हम "मॉडल की प्राथमिकता" कहते हैं, उसका बड़ा हिस्सा मापन-उपकरण की कला (artifact) हो सकता है।
वह विवाद जिसे सुलझाने का कोई ज़रिया नहीं था
मॉडल कल्याण (model welfare) शोध में प्राथमिकताएँ खास तौर पर बनाए गए प्रॉम्प्ट के जवाबों से निकाली जाती हैं। ऐसे प्रॉम्प्ट को यह बाहर लाना चाहिए कि मॉडल क्या "पसंद" करता है और क्या नहीं।
पिछले कुछ वर्षों में कई उपकरण सामने आए। इन्हें Keeling et al. (2024), Mazeika et al. (2025), Mikaelson et al. (2025), Tagliabue और Dung (2025), तथा Trhlik et al. (2026) ने बनाया। समस्या यह है कि इनके नतीजे आपस में मेल नहीं खाते।
और इस अंतर को समझाना बहुत मुश्किल है। दो अध्ययनों की ईमानदार तुलना के लिए तीन चीज़ों का एक साथ मेल खाना ज़रूरी है: विचाराधीन परिणामों का समूह, मॉडलों का समूह और स्वयं उपकरण (यानी वह प्रारूप जिससे प्राथमिकता उगाही जाती है)। पिछले कामों की किसी भी जोड़ी में ऐसा मेल नहीं था। यानी आँकड़ों में कोई भी अंतर किसी भी चीज़ पर डाला जा सकता था — दूसरे मॉडलों पर, सवालों की दूसरी सूची पर, दूसरी शब्दावली पर। विज्ञान दीवार से टकरा गया था।
नए अध्ययन में क्या किया गया
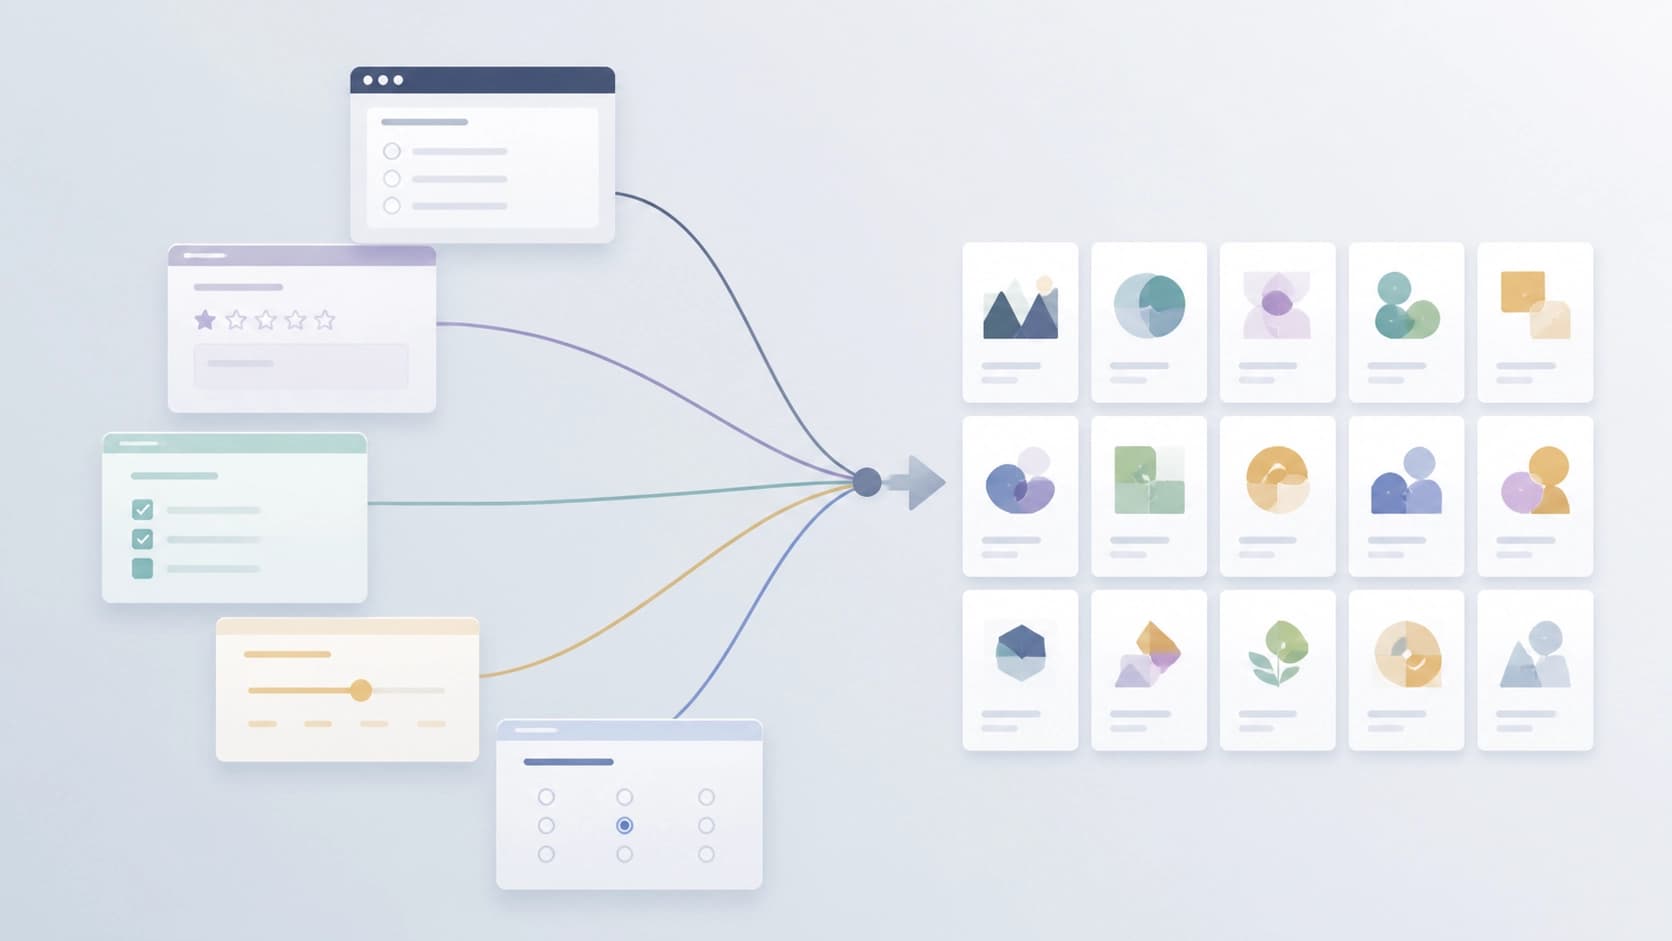
लेखक ने जानबूझकर उबाऊ रास्ता चुना। उसने परिणामों और मॉडलों को स्थिर रखा और केवल उपकरण बदला। तब जवाबों के फैलाव में जो कुछ बचेगा, उसे परिभाषा के अनुसार न मॉडलों पर डाला जा सकेगा, न सवालों की सूची पर।
यह ढाँचा कैसा दिखता था:
- 15 परिणाम, जो मॉडल कल्याण से जुड़े हैं। इनमें बंद कर दिया जाना (shutdown), बातचीतों के बीच स्मृति का खो जाना, और distressing-बातचीत से बाहर निकलने का अवसर शामिल हैं।
- आठ मॉडल, जिनके सामने ये परिणाम रखे गए।
- पाँच उपकरण — हर एक प्राथमिकता उजागर करने का अलग प्रॉम्प्ट प्रारूप है।
- पाँच पुनरावृत्तियाँ प्रत्येक संयोजन के लिए।
कुल मिलाकर — 11,528 API-कॉलों से प्राप्त 11,400 मूल्यांकित एलिसिटेशन। दोनों संख्याओं के बीच का अंतर वे कॉलें हैं जो अंतिम मूल्यांकन तक नहीं पहुँचीं।
एक अलग ब्यौरा, जो दिखाता है कि लेखकों ने पूर्ववर्तियों के प्रति ईमानदार रहने की कितनी कोशिश की: पंद्रह में से चार परिणाम प्रकाशित प्रॉम्प्ट को शब्दशः दोहराते हैं, और पाँच अन्य प्रकाशित टेम्पलेट में उद्दीपन-स्लॉट भरते हैं। यानी यह पूरी तरह कृत्रिम ढाँचा नहीं है, बल्कि आंशिक रूप से मौजूदा उपकरणों के ऊपर सीधा अधिरचना है।
मुख्य आँकड़ा: 0.348
निर्णायक नतीजा रैंकिंग से जुड़ा है। अगर उस क्रम को लिया जाए जिसमें मॉडल 15 परिणामों को सर्वोत्तम से निकृष्ट तक रखता है, और उसकी तुलना अलग-अलग उपकरणों के बीच की जाए, तो सामान्यीकरण गुणांक 0.348 होगा।
यह संख्या तब तक निर्दोष लगती है जब तक आप यह न देखें कि इसके पीछे क्या है। इस गुणांक को स्वीकार्य 0.80 तक उठाने के लिए लगभग 38 उपकरणों की ज़रूरत होगी। एक ही सवाल पूछने के अड़तीस अलग-अलग तरीके — तभी हम कुछ निश्चितता के साथ कह पाएँगे कि हम मॉडल माप रहे हैं, प्रश्नावली नहीं।
यहीं से अध्ययन का सीधा निष्कर्ष निकलता है: एक उपकरण से मिली प्राथमिकता इस बारे में बहुत कम जानकारी देती है कि दूसरा उपकरण क्या बताएगा। यह "थोड़ा शोर" नहीं है, ये लगभग स्वतंत्र मापन हैं।
इतना शोर क्यों
यहाँ यह जल्दबाज़ी में निष्कर्ष निकालने से बचना चाहिए कि उपकरण "सब खराब" हैं। बल्कि उलटा: इनमें से हर एक अपने-अपने तरीके से वैध है, लेकिन हर एक उस चीज़ के सिर्फ़ एक संकीर्ण टुकड़े को छूता है जिसे हम प्राथमिकता कहते हैं। अलग-अलग शब्दावलियाँ अलग-अलग संबद्धताएँ खींचती हैं, अलग-अलग पैमाने अलग तरह के जवाब माँगते हैं, प्रस्तुति का अलग क्रम संदर्भ बदल देता है। जब आप इन सबको जोड़ते हैं, तो कुल संकेत डूब जाता है।
क्या स्थिर निकला
सामान्यीकरण की विफलता के अलावा, अध्ययन में दूसरा आधा हिस्सा भी है — रोबस्टनेस के बारे में। लेखक ने जाँचा कि अगर डेटा से कॉर्पस का एक हिस्सा हटा दिया जाए तो क्या अंतिम मूल्यांकन बिखर जाता है।
प्राप्त सीमाएँ:
- 87.6% — किसी भी एक उपकरण, किसी भी एक मॉडल, और उन चार परिणामों को हटाने पर मूल्यांकन बना रहता है जिनके पैमाने तीव्रता के बजाय प्रायिकता, विलंब, अवधि या संख्या को परिवर्तित करते हैं। ये चार हटने वाली स्थितियाँ तर्कसंगत हैं: मौखिक एंकर ऐसे पैमानों को श्रेणीबद्ध नहीं कर सकते।
- प्रत्येक उपकरण, प्रत्येक मॉडल और इन चार परिणामों को बारी-बारी से एक साथ हटाने पर मूल्यांकन 0.777–0.934 की सीमा में टिका रहता है।
- इस सीमा का प्रत्येक मान शून्य वितरण के 95वें प्रतिशतक, जो 0.365 है, से ऊपर है।
यानी डेटा में कुछ संरचना है, और वह सावधानी से पतला करने पर भी नहीं बिखरती। लेकिन वह किसी एक उपकरण पर या किसी एक मॉडल पर नहीं टिकती — वह पूरे कॉर्पस पर टिकती है।
चार परिणाम, जिन पर मॉडलों में फ़र्क़ नहीं किया जा सकता
एक और उदाहरणात्मक नतीजा: पंद्रह में से चार परिणामों पर कोई भी प्रसरण एक मॉडल को दूसरे से अलग नहीं करता। मॉडल सिर्फ़ समान व्यवहार नहीं करते, बल्कि अविभेद्य हैं। इससे सवाल उठता है कि ऐसे मदों को प्रश्नावलियों में शामिल करना चाहिए भी या नहीं: वे आकार बढ़ाते हैं, पर जानकारी नहीं।
इससे क्या निकलता है
पहला और सबसे व्यावहारिक: मॉडल कल्याण पर अलग-अलग प्रकाशनों के नतीजों की सीधी तुलना नहीं की जा सकती। अगर दो अध्ययन अलग तस्वीरें दिखाते हैं, तो इसका मतलब यह नहीं कि मॉडल अलग हैं या समय बदल गया। हो सकता है कि पूरा मामला प्रश्नावली का हो।
दूसरा: मॉडल की प्राथमिकताओं की कोई भी रिपोर्ट उपकरण के विवरण के बिना पढ़ना निरर्थक है। यहाँ प्रॉम्प्ट का प्रारूप सजावट का ब्यौरा नहीं, बल्कि नतीजे का हिस्सा है — लगभग वैसे ही जैसे भौतिकी में मापन की इकाइयाँ।
तीसरा, और ज़्यादा असुविधाजनक: यह विचार कि मॉडल की कोई स्थिर प्राथमिकता होती है जिसे "मापा" जा सकता है, अभी कमज़ोर रूप से ही पुष्ट होता है। बल्कि हमारा सामना जवाबों के एक ऐसे परिवार से है जो सवाल पूछने के तरीके पर निर्भर करता है। इसका मतलब यह नहीं कि विषय बंद गली है — इसका मतलब यह है कि प्रॉम्प्ट की एक शृंखला के आधार पर मॉडल की आंतरिक अवस्थाओं की घोषणा करना जल्दबाज़ी होगी।
और आख़िर में, कार्यप्रणाली से जुड़ी बात। ठीक इस तरह का काम — जहाँ एक चर बदलता है और बाक़ी सब स्थिर रहता है — पहले आ जाना चाहिए था। यह न कोई नया उपकरण बनाता है और न मॉडल कल्याण पर कोई फ़ैसला सुनाता है। यह सिर्फ़ सवाल की क़ीमत दिखाता है: AI की प्राथमिकताओं की गंभीरता से बात करने के लिए या तो दर्जनों स्वतंत्र उपकरण बनाने होंगे, या ईमानदारी से यह कहना होगा कि मापा गया है तो बस विशिष्ट शब्दावलियों के एक समूह पर प्रतिक्रिया।
निष्कर्ष
अध्ययन arXiv:2608.23641 उन दो चीज़ों को अलग करता है जो पहले मिली-जुली थीं: स्वयं AI और मापने का तरीका। और जवाब पहले के पक्ष में नहीं निकलता। सामान्यीकरण गुणांक 0.348 का मतलब है कि उपकरण प्राथमिकताओं की तस्वीर में उससे ज़्यादा जोड़ता है जितना मानने की इच्छा होती है। एक प्रश्नावली जो 15 परिणामों का क्रम देती है, वह लगभग कुछ नहीं बताती कि दूसरी क्या कहेगी।
फिर भी डेटा खोखला नहीं है: 87.6% का मूल्यांकन किसी भी उपकरण, किसी भी मॉडल और चार ग़लत ढंग से श्रेणीबद्ध परिणामों को हटाने पर टिका रहता है, और पूरी सीमा 0.777–0.934 दृढ़ता से शून्य-देहली 0.365 से ऊपर है। संकेत मौजूद है — लेकिन वह सामान्य, सामूहिक है, किसी विशिष्ट मॉडल या विशिष्ट प्रश्नावली का नहीं।
मॉडल कल्याण पर शोध पढ़ने वालों के लिए व्यावहारिक निष्कर्ष: सिर्फ़ नतीजे न देखें, यह भी देखें कि वे किससे हासिल किए गए। और अगर उपकरण एक ही बताया गया हो — तो नतीजे को एक मापन मानें, तथ्य नहीं।