
प्रस्तुति प्रारूप कोई कार्यान्वयन विवरण क्यों नहीं है
जब हम किसी भाषा मॉडल की स्मृति या RAG पाइपलाइन की गुणवत्ता जाँचते हैं, तो हमें आमतौर पर ठीक एक बात की परवाह होती है: क्या मॉडल तक आवश्यक तथ्य पहुँचा। लेकिन यह तथ्य इनपुट संदर्भ में किस रूप में आया — एक अलग स्मृति प्रविष्टि, संक्षिप्त सारांश, फ़ील्ड वाली संरचित प्रविष्टि, या बातचीत का कच्चा टुकड़ा — इसे सिस्टम के आंतरिक मामलों में गिना जाता है। तर्क सरल है: अगर तथ्य मौजूद है, तो उसकी पैकेजिंग से फ़र्क नहीं पड़ता।
arXiv:2608.23568 प्रीप्रिंट के लेखक इससे असहमत होने का सुझाव देते हैं। उनका काम «RENDER: Controlling Reader-Facing Evidence in LLM Memory Evaluation» (Yuan Si, Simeng Han, Daming Li, Jialu Zhang; 5 जून 2026 का v1) इसी विचार पर प्रहार करता है कि स्मृति का एक ही ईमानदार और सार्वभौमिक मूल्यांकन होता है। इसके बजाय इसे उसी तरह मापने का सुझाव दिया जाता है जैसे कॉन्फ़िगरेशन के प्रति संवेदनशील अन्य गुणों को मापा जाता है: एक चर को स्थिर रखें और दूसरे के मानों को बदल-बदल कर देखें।
RENDER वास्तव में क्या नियंत्रित करता है
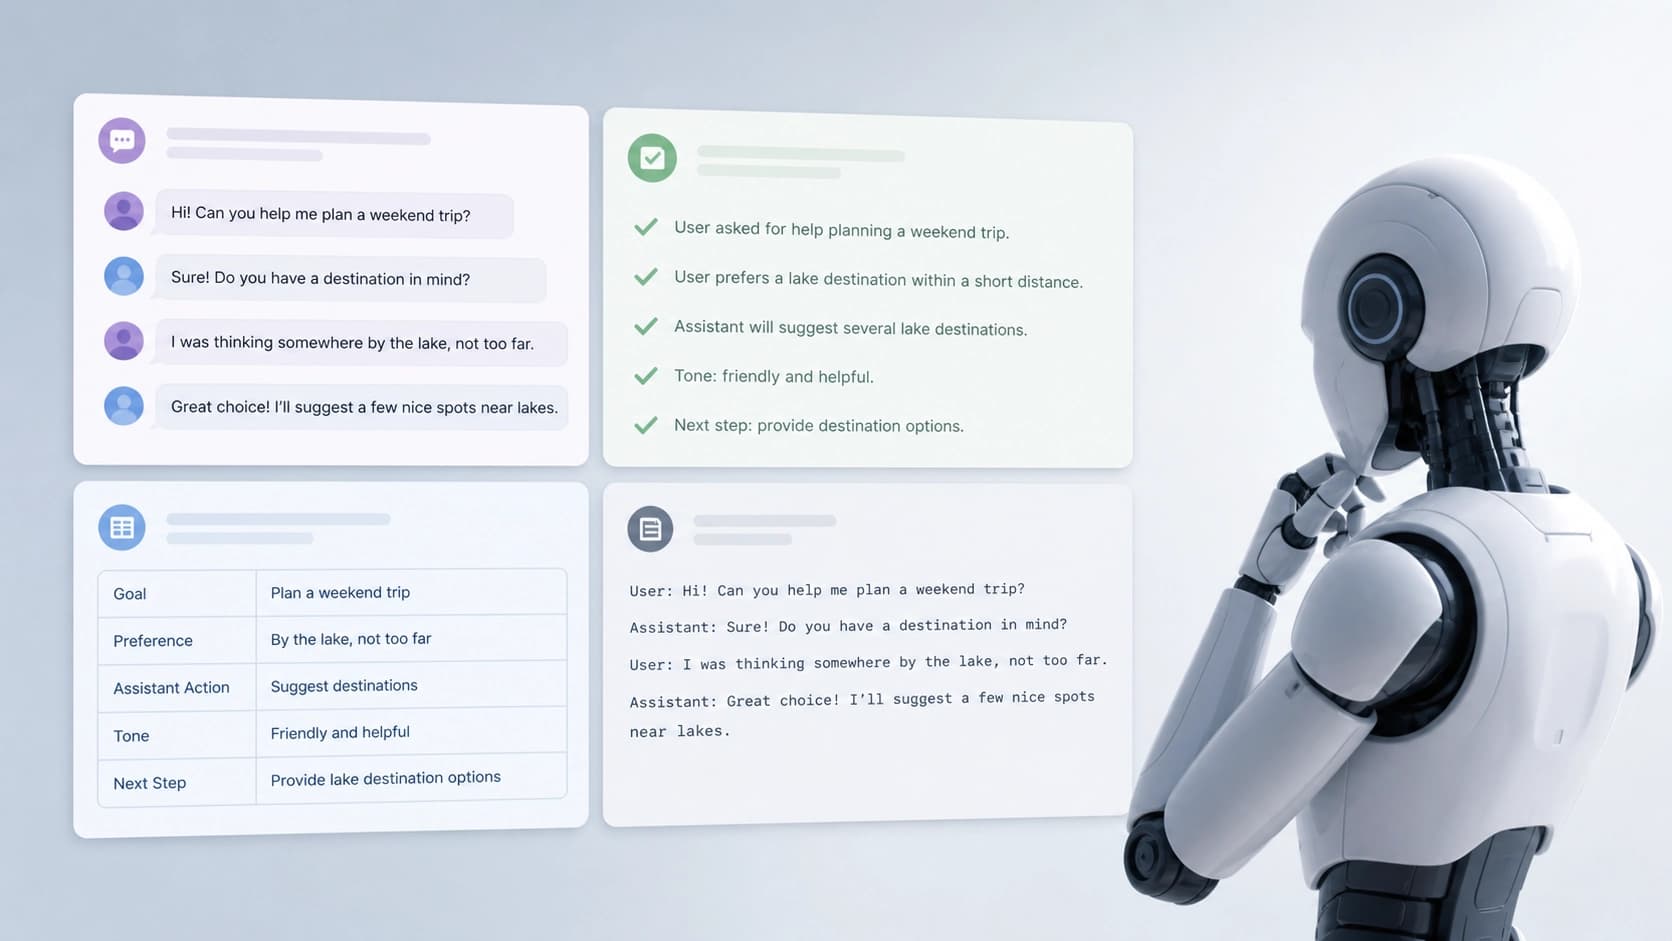
संवाद नहीं बदलता। केवल पाठक की ओर उन्मुख कलाकृति बदलती है: वही जो उत्तर देने वाला मॉडल वास्तव में अपने सामने देखता है। यही परत — reader-facing artifact — RENDER एक नियंत्रित चर बनाता है।
पाँच स्तरों की सीढ़ी
पद्धति का मूल है five-level packet ladder। यह केवल प्रारूपों का समूह नहीं, बल्कि एक पैमाना है जो उस क्षण का पता लगाता है जब उत्तर-वाहक सामग्री उत्तर देने वाले मॉडल के इनपुट में पहुँचती है। इसका उद्देश्य दो मूलतः भिन्न विफलताओं को अलग करना है: सिस्टम को आवश्यक तथ्य नहीं मिला, और सिस्टम को वह मिला लेकिन वह उसे उपयुक्त रूप में पहुँचा नहीं सका। ऐसे पैमाने के बिना ये मामले रिपोर्ट की एक ही पंक्ति में मिल जाते हैं, और फिर गलत निष्कर्ष शुरू हो जाते हैं — जैसे कि मॉडल «ठीक से याद नहीं रखता», जबकि वास्तव में उसने बस पैकेजिंग को समझा नहीं।
प्रस्तुति के चार टेम्पलेट
दूसरा तत्व है नियतात्मक टेम्पलेट, जो उपयोगकर्ता को इतिहास दिखाने के विशिष्ट तरीकों का अनुमान लगाते हैं। ये चार हैं:
- ChatGPT शैली की प्रविष्टियाँ — साफ़-सुथरे ब्लॉक, जो चैटबॉट इंटरफ़ेस में दिखने वाली चीज़ों जैसे होते हैं;
- LangChain शैली का सारांश — संक्षिप्त पुनर्कथन, जो शब्दावली खो देते हैं पर सार बनाए रखते हैं;
- MemGPT शैली की टाइप्ड प्रविष्टियाँ — फ़ील्ड और श्रेणियों वाली संरचना, जो मशीन प्रसंस्करण के लिए सुविधाजनक है;
- कच्चा संवाद — बातचीत जैसी है वैसी, बिना मार्कअप और पुनः पैकेजिंग के।
टेम्पलेट नियतात्मक हैं: एक ही इनपुट हर बार एक ही टेक्स्ट देता है। यह महत्वपूर्ण है, क्योंकि अन्यथा प्रारूप के प्रभाव को जनरेशन के यादृच्छिक प्रसार से अलग नहीं किया जा सकता।
आँकड़ों ने क्या दिखाया
प्रयोग LongMemEval के 500 प्रश्नों और नौ मॉडलों पर आधारित है। यहाँ रुकना चाहिए: यह एक ही रन या किसी सुंदर आँकड़े के लिए एक ही प्रयास नहीं है, बल्कि «मॉडल × प्रस्तुति प्रारूप» का ग्रिड है, जो प्रभाव देखने की अनुमति देता है।
मुख्य परिणाम: matched-budget resolved packets, recency-truncated raw dialogue से 42.4–72.6 अंक आगे निकल जाते हैं। दूसरे शब्दों में, यदि प्रारूपों को तुलनीय बजट पर लाया जाए और मॉडल को वह सामग्री दी जाए जो वास्तव में उत्तर वहन करती है, तो सबसे भोले प्रस्तुति तरीके — ताज़गी के आधार पर काटे गए कच्चे संवाद — से यह अंतर सौंदर्यपरक नहीं, बल्कि भारी होता है।
deployed-style टेम्पलेट में तस्वीर नरम है, पर फिर भी बड़ी: सर्वोत्तम और निकृष्ट प्रारूप के बीच का अंतर नौ मॉडलों में से प्रत्येक पर 24.6–48.8 अंक है। यानी एक ही मॉडल के भीतर, उन्हीं प्रश्नों पर, उसी बजट पर, केवल इस बात से कि साक्ष्य कैसा दिखता है, दर्जनों अंक «खोए» या «कमाए» जा सकते हैं।
प्राथमिक स्कोरिंग से एक और ब्यौरा: 9 में से 7 मॉडलों में ChatGPT शैली की प्रविष्टियाँ कच्चे संवाद की तुलना में अधिक बिंदु-अनुमान प्राप्त करती हैं। यह शायद उन लोगों के लिए सबसे असुविधाजनक निष्कर्ष है जो «शुद्ध» चैट इतिहास पर मेट्रिक्स बनाते हैं।
निर्णायक भी अंतिम सत्य नहीं है
एक अलग कहानी यह है कि यदि मूल्यांकन स्वचालित स्कोरर के बजाय निर्णायक-मॉडल (judge rescoring) से पुनर्गणना किया जाए तो क्या होगा। प्रारूप का समग्र सकारात्मक प्रभाव बना रहता है, पर अलग-अलग मॉडलों पर सार्थकता मिश्रित हो जाती है। सरल शब्दों में: पूरे नमूने के स्तर पर प्रवृत्ति गायब नहीं होती, पर «मॉडल X केवल प्रारूप Y के कारण जीतता है» जैसे बिंदु-दर-बिंदु दावे पुनर्निर्णय के बाद उतने विश्वसनीय नहीं रहते।
यह LLM-निर्णायकों को छोड़ने का कारण नहीं है, पर एक अच्छी याद दिलावट है: स्मृति का कोई भी मूल्यांकन स्वयं एक मापक यंत्र है जिसकी इनपुट प्रारूप के प्रति अपनी संवेदनशीलता होती है। और यदि सिस्टम और निर्णायक साक्ष्य की पैकेजिंग पर अलग-अलग प्रतिक्रिया देते हैं, तो यह अंतर शोर में जा सकता है या, इसके विपरीत, झूठे संकेत में।
सबसे स्पष्ट परिणाम: शून्य बनाम पचास
यदि लेख से एक ही आँकड़ा लेना हो, तो यही लेना चाहिए। तीन मॉडल, जिन्होंने formal ledger packets पर 0 % दिखाया, उन्हीं तथ्यों का natural-language entries से 45.4–53.4 % सटीकता से उत्तर दे रहे थे।
«थोड़ा बेहतर» नहीं, «त्रुटि की सीमा के भीतर» नहीं — पूर्ण शून्य से लेकर समान सामग्री पर आधे मामलों में आत्मविश्वासपूर्ण सटीकता तक। ऐसे अंतर को मॉडल में ज्ञान की कमी या खराब रिट्रीवल से समझाना कठिन है: तथ्य मौजूद थे, केवल उन्हें प्रस्तुत करने का तरीका बदला था। औपचारिक, मशीन-पठनीय प्रविष्टि किसी कारण मॉडल के लिए दुर्गम साबित हो रही थी, और वही जानकारी सामान्य भाषा में लिखी होने पर बिना किसी परेशानी के पढ़ ली जाती थी।
इंजीनियर के लिए यह व्यावहारिक संकेत है: यदि आपकी पाइपलाइन स्मृति को कठोर संरचित ब्लॉकों में रखती है, तो आप मॉडल की क्षमताओं को व्यवस्थित रूप से कम आँक सकते हैं — और साथ ही औपचारिकीकरण के लाभ को अधिक आँक सकते हैं।
यह कितना टिकाऊ है
शर्तें जटिल होने पर प्रभाव बिखरता नहीं: यह retrieval noise पर भी बना रहता है, यानी जब संदर्भ में अतिरिक्त टुकड़े मिला दिए जाते हैं। इससे भी आगे, यह HotpotQA पर भी स्थानांतरित होता है — एक अन्य डेटासेट, जो बहु-चरणीय प्रश्नों के इर्द-गिर्द बना है। यह महत्वपूर्ण है, क्योंकि इससे यह संदेह दूर होता है कि सब कुछ लंबी स्मृति के किसी एक बेंचमार्क की विशिष्टता में है।
सीमाएँ भी ध्यान में रखनी चाहिए: टेम्पलेट वास्तविक प्रस्तुति तरीकों का अनुमान लगाते हैं, उन्हें शब्दशः पुनरुत्पादित नहीं करते, और पुनर्निर्णय के बाद विशिष्ट मॉडलों पर निष्कर्ष मिश्रित हैं। तो बात तैयार नुस्खों की नहीं, बल्कि इस चर को महसूस करने की आवश्यकता की है।
व्यवहार में इसका क्या करें
लेखकों का निष्कर्ष काफ़ी सीधा है: memory/RAG मूल्यांकन की रिपोर्टों को या तो बताना चाहिए कि कौन-सी reader-facing कलाकृति उपयोग की गई, या उसे स्पष्ट रूप से नियंत्रित करना चाहिए। नीचे — यह व्यावहारिक रूप में कैसा दिखता है:
- परीक्षण के विवरण में प्रारूप स्थिर करें। «हमने मॉडल को LongMemEval पर चलाया» — अपर्याप्त विवरण है, यदि यह न कहा जाए कि इतिहास किस रूप में इनपुट में पहुँचा।
- कम से कम दो-तीन प्रारूप चलाएँ। एक अच्छा और एक भोला (जैसे, कच्चा कटा हुआ संवाद) ही आपके सिस्टम की संवेदनशीलता का अंदाज़ा दे देंगे।
- अलग-अलग पैकेजिंग पर मॉडलों की तुलना न करें। 20–30 अंकों का अंतर पूरी तरह प्रारूप का हो सकता है, मॉडल का नहीं।
- अपनी संरचित स्मृति स्कीमाओं की जाँच करें। उसी तथ्य पर सामान्य टेक्स्ट में आत्मविश्वासपूर्ण उत्तरों के बावजूद औपचारिक प्रविष्टि पर शून्य — यह स्मृति का नहीं, प्रस्तुति का बग है।
- «मॉडल-निर्णायक» चैनल का अलग से परीक्षण करें। यदि मूल्यांकनकर्ता स्वयं प्रारूप के प्रति संवेदनशील है, तो मेट्रिक पक्षपाती हो जाती है।
- प्रारूप की कीमत को ध्यान में रखें। सारांश और टाइप्ड प्रविष्टियाँ टोकन बचाते हैं; अब इसका एक मापनीय दूसरा पक्ष है, और इसे सचेत रूप से तौलना चाहिए।
RENDER का मुख्य विचार सरल है और इसीलिए असुविधाजनक: साक्ष्य प्रस्तुत करने के तरीके के बिना «मॉडल की स्मृति का मूल्यांकन» एक अपूर्ण कथन है। वही संवाद, वही प्रश्न, वही मॉडल, पर अलग-अलग उत्तर। फ़र्क इस बात में है कि आपने उसे वह कैसे दिखाया जो उसे याद रखना है।


