لماذا يُعدّ المسار وحدة قياس سيئة
تعمل أساليب الاستدلال الحديثة أثناء الاستنتاج وفق المخطط نفسه: لا يولّد النموذج إجابة واحدة، بل مجموعة كاملة من السلاسل المرشّحة، ثم تختار نموذج مكافأة خارجي أفضلها. المنطق بسيط — فكلما زاد عدد الخيارات، ارتفع احتمال أن يكون بينها خيار удачный.
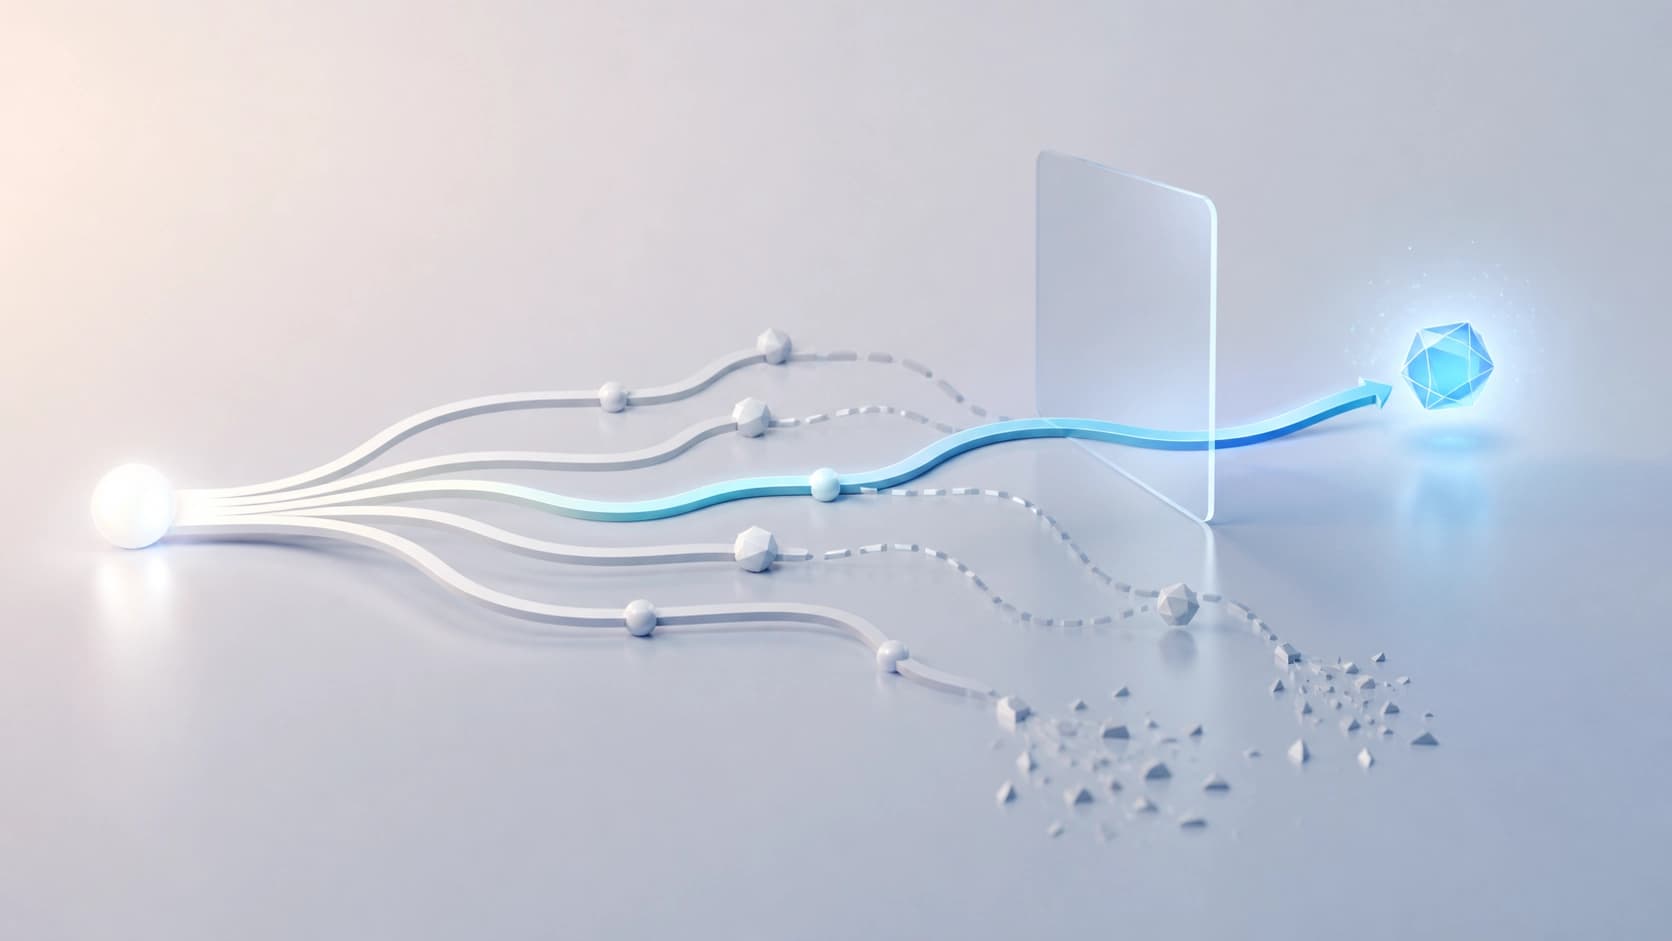
لكن موضع الضعف هنا في مكان آخر. يُنظر إلى كل مرشّح كوحدة غير قابلة للتجزئة: إما يُقبل بالكامل، أو يُرمى بالكامل. لكن الاستدلال الطويل نادراً ما يكون متجانساً. الصورة النمطية هي: بداية واثقة وصحيحة، وصياغة دقيقة للمسألة، واختيار صحيح للطريقة، ثم انهيار: خطأ حسابي، أو دوران في حلقة، أو استبدال للشرط. من الناحية الشكلية تُوسم السلسلة كلها بالفشل، مع أن نصفها الأول كان عملاً صالحاً تماماً.
والنتيجة — حسابات أُهدرت سدى. نحن ندفع ثمن توليد رموز كانت صحيحة، ثم نتخلص منها مع ذيلها الفاسد. إلى هذا القصور تحديداً يشير مؤلفو ورقة Selective Regenerative Decoding، المنشورة بمعرّف arXiv:2608.24338 (cs.AI) في 25 أغسطس 2026.
SRD: ثلاث شُعب بدلاً من اثنتين
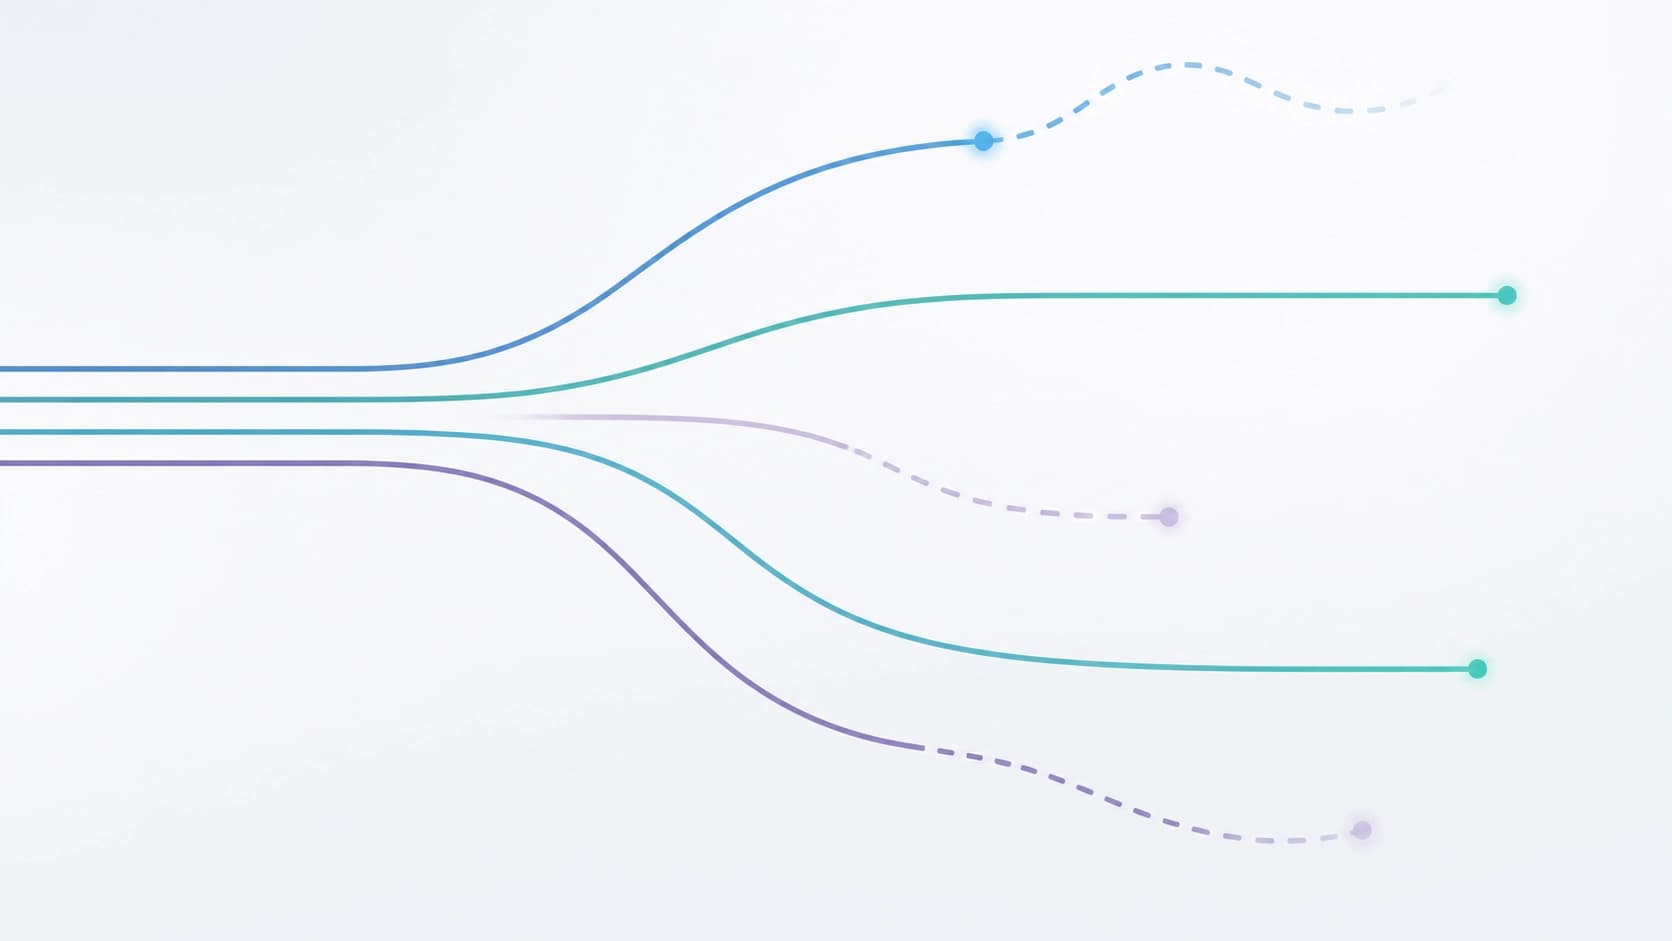
يقترح Selective Regenerative Decoding (SRD) التخلي عن الاختيار الثنائي. فبدلاً من «اقبل أو ارفض»، يُوجَّه كل مرشّح إلى واحدة من ثلاث شُعب:
- الرفض — إذا كانت السلسلة عديمة الفائدة من بدايتها إلى نهايتها؛
- الإبقاء — إذا اجتازت التحقق بالكامل؛
- الإعادة للمعالجة — إذا وُجد جزء مفيد، لكن اللاحقة تدهورت بوضوح.
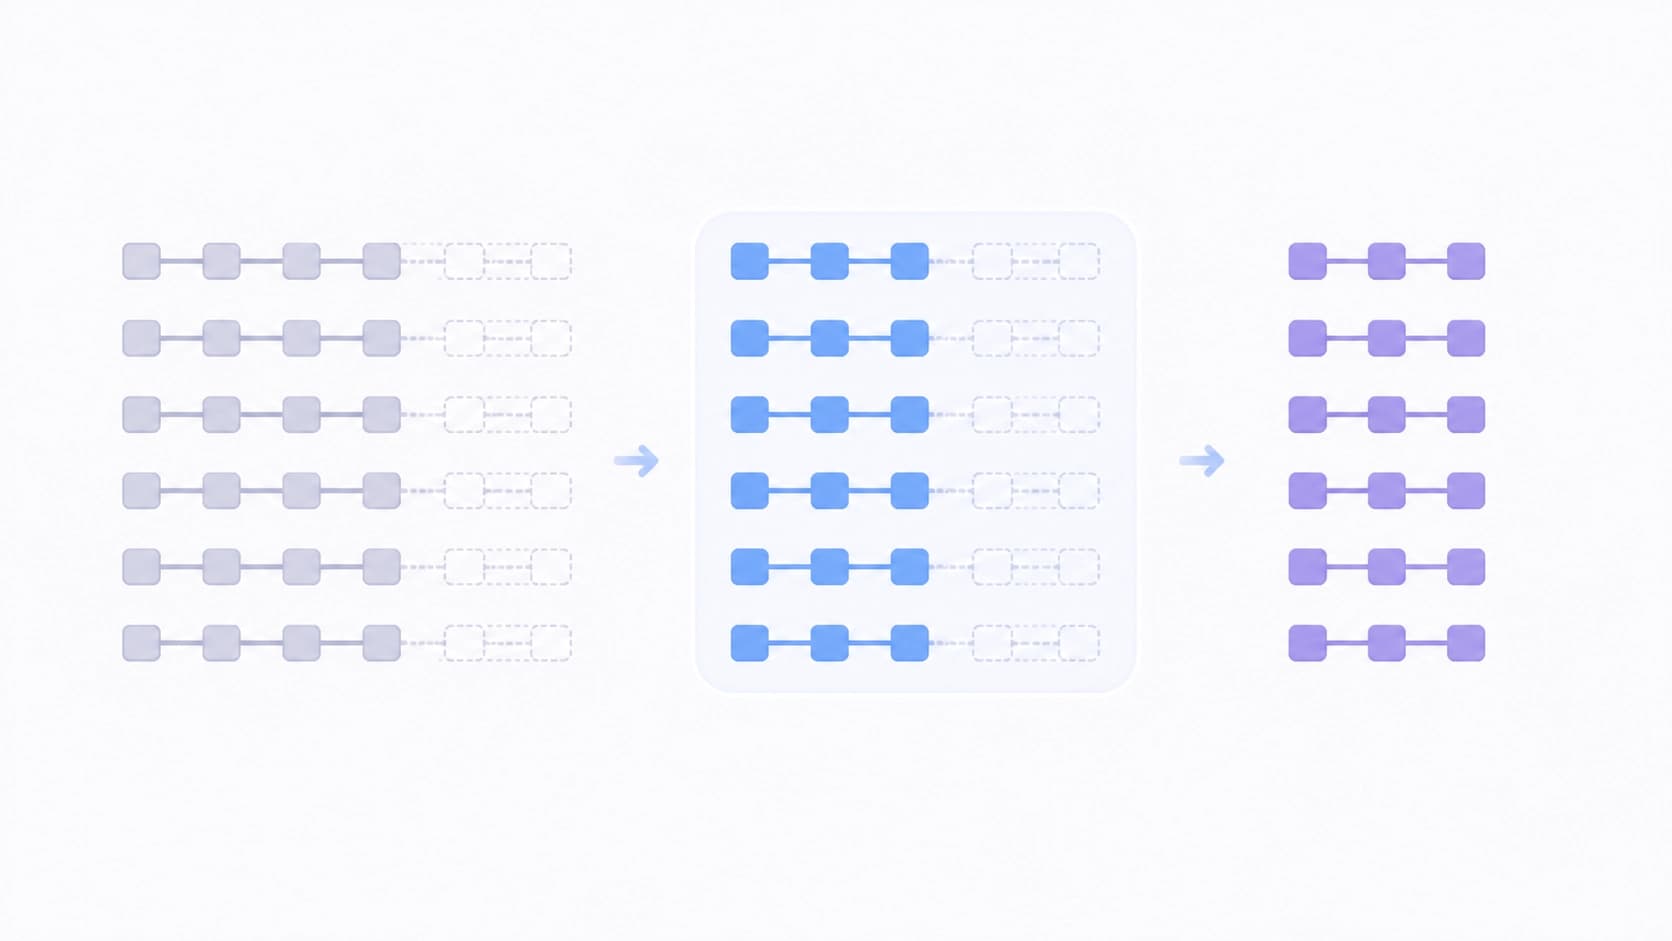
في الحالة الثالثة لا تعيد المنظومة كتابة الاستدلال من الصفر، بل تحتفظ بالبادئة الجيدة وتعيد توليد الجزء المتدهور فقط. وهذا أقرب إلى تحرير مسودة منه إلى كتابة نص جديد: فأنت لا ترمي مقدمة موفقة بسبب خاتمة فاشلة، بل تصحّح ما تعطّل.
ويشدّد المؤلفون بشكل منفصل على أن هذا التدخل لا يتطلب نموذجاً مانحاً أكبر حجماً. لا وجود لأي «معلّم ذكي» ينتشل تلميذاً ضعيفاً — فالعمل كله يجري ضمن الموارد الحسابية المتاحة أصلاً. وهذا تحديداً ما يجعل الطريقة تطبيقية لا تمريناً نظرياً.
من أين يأتي المكسب
أكثر ما يثير الاهتمام في الورقة ليس الاستدلال الاستكشافي، بل تبريره. ففي ظل افتراضات متسامحة، يمنح SRD نمواً قابلاً للإثبات في كفاءة العيّنة بمقدار 1.28–1.36 مرة مقارنة بأخذ العينات بالرفض الكلاسيكي، مع كون الجودة المتوقعة للمسار النهائي أعلى تماماً، لا مجرد «غير أسوأ».
والحدس هنا واضح دون معادلات. فالمرشّح الذي مرّ بإعادة توليد اللاحقة يحتوي أصلاً على حسابات مدفوعة الثمن — تلك الرموز في البادئة التي لا حاجة لتوليدها من جديد. وكلما زاد عدد هؤلاء المرشّحين الحدّيين الذين يمكن إنقاذهم، انخفضت نسبة النص المولَّد التي تذهب إلى سلة المهملات. ولأن عدد السلاسل «شبه الموفقة» ينمو مع زيادة مجموعة المرشّحين، فإن المكسب لا يبقى ثابتاً — بل يتوسّع مع ميزانية التوليد.
أين جرى اختبار ذلك
يغطي الجانب التجريبي أربعة أنواع مختلفة من الأعباء: MATH500 (مسائل رياضية)، وGPQA Diamond (أسئلة بمستوى علمي)، وHotpotQA (أسئلة متعددة الخطوات على الوثائق)، وAlpacaEval (اتباع التعليمات وتقييم التفضيلات). وأُجري الاختبار على عدة تركيبات من «مولّد + نموذج مكافأة»، حتى لا تعتمد النتيجة على زوج واحد موفّق.
النتائج المعلنة: يبلغ SRD دقة تُحصَّل عادةً بوضع Best-of-N، لكنه يستهلك رموزاً مولَّدة أقل بكثير. وفي السيناريوهات ذات الحسابات المحدودة يتجاوز الأسلوب speculative rejection — أي أنه يفوز تحديداً حيث يكون ثمن كل رمز إضافي باهظاً.
ما الذي يغيّره هذا جوهرياً
التحوّل الرئيسي الذي يرصده المؤلفون منهجي. فسابقاً كان الاختيار يحدث على مستوى المسار ككل: يضع نموذج المكافأة تقييماً ويقرّر مصير الاستدلال بأكمله. أما SRD فينقل التدخل إلى داخل المسار، إلى مستوى المقاطع، ويفتح بذلك مجالاً للتوفيق بين الدقة والحسابات لم يكن مدروساً تقريباً حتى الآن.
والخلاصة العملية لمن يبنون خطوط أنابيب الاستنتاج: جودة الاستدلال وكلفة الحصول عليه ليستا بالضرورة مرتبطتين ارتباطاً صارماً. يمكن استرداد جزء من الحسابات «الزائدة» إذا توقفنا عن التعامل مع مسودة النموذج ككتلة واحدة.
ما يبقى خارج الصورة
الأسئلة المفتوحة كثيرة. والسؤال المحوري هو كيف تُحدَّد بالضبط الحدود بين البادئة السليمة واللاحقة المتدهورة: فهذا المعيار يحدد كم مرشّحاً سيدخل الشُعبة الثالثة أصلاً. ثم هناك كلفة إعادة التوليد نفسها (فهي ليست مجانية)، والحساسية لاختيار نموذج المكافأة، وقابلية تعميم الاستنتاجات خارج المعايير الأربعة المستخدمة.
تبلغ الورقة 20 صفحة وقُدّمت إلى ARR، أي أنها حتى الآن نسخة أولى قيد المراجعة، لا نتيجة محكَّمة. لكن الاتجاه يبدو واعداً: فبدلاً من أن نولّد أكثر وننتقي بصرامة أكبر، يمكننا أن نتصرف بعناية أكبر بما فكّر فيه النموذج بالفعل.