
لماذا نفكك أخطاء خط الأنابيب أصلاً
تقييم نظام RAG برقم واحد أمر مريح، لكنه عديم الجدوى تقريباً. فالمقياس الشامل يجيب على سؤال «هل جاء الجواب مطابقاً للمتوقع»، لا على سؤال «لماذا جاء كذلك أو لم يأت». وفي المقابل، فإن RAG ليس كتلة واحدة متماسكة، بل سلسلة: أولاً يُعثر على شيء ما في القاعدة، ثم يقرر النظام هل ما وُجد كافٍ، وعندها فقط يكتب المولِّد النص. وفشل أي حلقة من الحلقات يعطي جواباً «خاطئاً» بالمثل عند المخرجات، مع أن أسباب هذين الفشلين قد تكون متعارضة تماماً.
هذه المشكلة بالتحديد هي ما يتناوله البحث The RAT: A Unified Bayesian Model for RAG Evaluation (arXiv:2608.24753، قسم cs.CL، أُرسل في 25 أغسطس 2026). المؤلفون — Pius von Däniken وFelix Matthias Saaro وMark Cieliebak وJan Deriu — يقترحون ألا يُقاس خط الأنابيب ككل، بل أن يُوصف كنموذج احتمالي، حيث كل مرحلة متغير عشوائي مستقل بعلاقاته الخاصة. بعد ذلك يتحول تقييم النظام إلى مسألة استدلال: أي قيم للمتغيرات الكامنة تفسّر على الأرجح الإجابات المرصودة والوسوم.
ما الذي يحاكيه الإطار البايزي بالتحديد
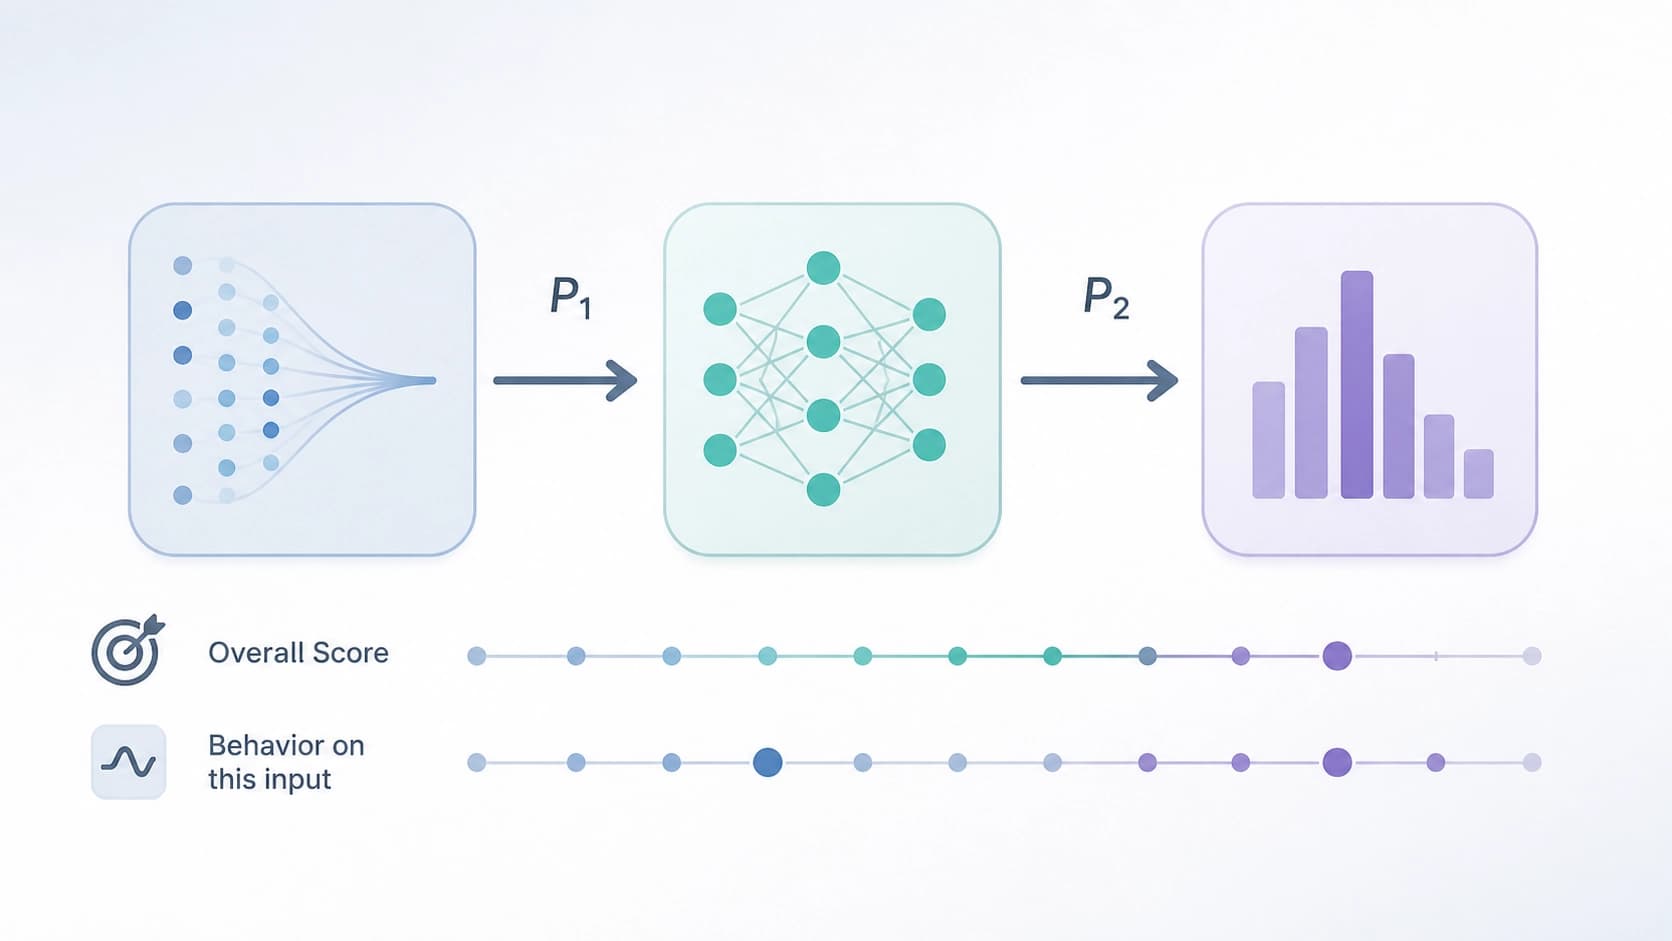
الفكرة الجوهرية هي التحليل العاملي وفق تدفق المعلومات. فالمتغيرات لا تُدخَل «بحسب مكونات خط الأنابيب» آلياً، بل بالترتيب الذي تتحرك به المعلومات فعلياً عبر النظام: نجاح الاسترجاع يؤثر في الكيفية التي ينبغي أن يتصرف بها المولِّد، وسلوك المولِّد إلى جانب نتيجة الاسترجاع يحددان صحة الجواب النهائية. هذه البنية تجعل التبعيات صريحة، لا مخفية داخل تقييم مُجمَّع.
وهكذا يحصل نموذج The RAT على ثلاث طبقات ذات معنى، تُدمج عادةً في مؤشر واحد.
نجاح المهمة ونجاح المولِّد — سؤالان مختلفان
الطبقة الأولى — نجاح المهمة: هل حصل المستخدم في النهاية على الجواب الصحيح. والثانية — نجاح المولِّد: هل تصرف المولِّد على النحو اللائق بالنظر إلى ما أُتيح له عند الإدخال. وشكلياً، الثاني هو جودة شرطية: إلى أي مدى يكون سلوك النموذج ملائماً لنتيجة الاسترجاع المعطاة، لا بشكل عام.
الفرق جوهري. فقد يُخرج النظام جواباً صحيحاً رغم استرجاع سيئ — لأن المولِّد خمّن من الذاكرة البارامترية. شكلياً هذا نجاح للمهمة، لكن السلوك كان غير سليم: النظام أجاب دون استناد إلى المصادر، وفي استعلام آخر ستتحول هذه العادة إلى هلوسة. والعكس: وجد الاسترجاع كل ما يلزم، وأجاب المولِّد بعناية — ومع ذلك كانت النتيجة خاطئة، لأن السؤال فُهم على غير وجهه. المقياس الشامل لا يميّز بين هاتين الحالتين، أما الشرطي فيميّز.
الامتناع ليس عطلاً، بل قرار
العنصر الثالث في النموذج — abstention behavior، سلوك الامتناع. في سياق RAG، يكون الإحجام عن الإجابة أحياناً هو رد الفعل الصحيح الوحيد: إذا لم يكن في القاعدة شيء ذو صلة، فـ«لا أعرف» الصادقة أفضل من اختلاق واثق. لكن الامتناع ذاته يصبح خطأً حين يكون المستند المطلوب قد وُجد، ولم يستفد النظام منه.
لذلك لا يمكن تقييم الامتناع بمعزل عن نتيجة الاسترجاع — بل شرطياً فقط. ونموذج The RAT يراعي ذلك مباشرة: فهو ينظر هل يتوافق كون الإجابة امتناعاً أو رداً مع ما كان موجوداً فعلاً في السياق. هذه النظرة مفيدة أيضاً للقرارات المتعلقة بالمنتج: إذا كان النظام يمتنع بكثافة عند استرجاع ناجح، فالمشكلة ليست في المولِّد، بل في طريقة إيصال السياق إليه.
لماذا تخدع المقاييس الهامشية
طبّق المؤلفون الإطار على 27 تهيئة — وهي ثلاث مجموعات بيانات وثلاثة مسترجِعات وثلاثة مولِّدات، جرى استعراضها في كل التوليفات. والاستعراض الكامل هنا ليس غاية بحد ذاته: إنه يُظهر كيف يتصرف التفكيك حين يتغير رابط واحد بالضبط وتبقى البقية في مكانها.
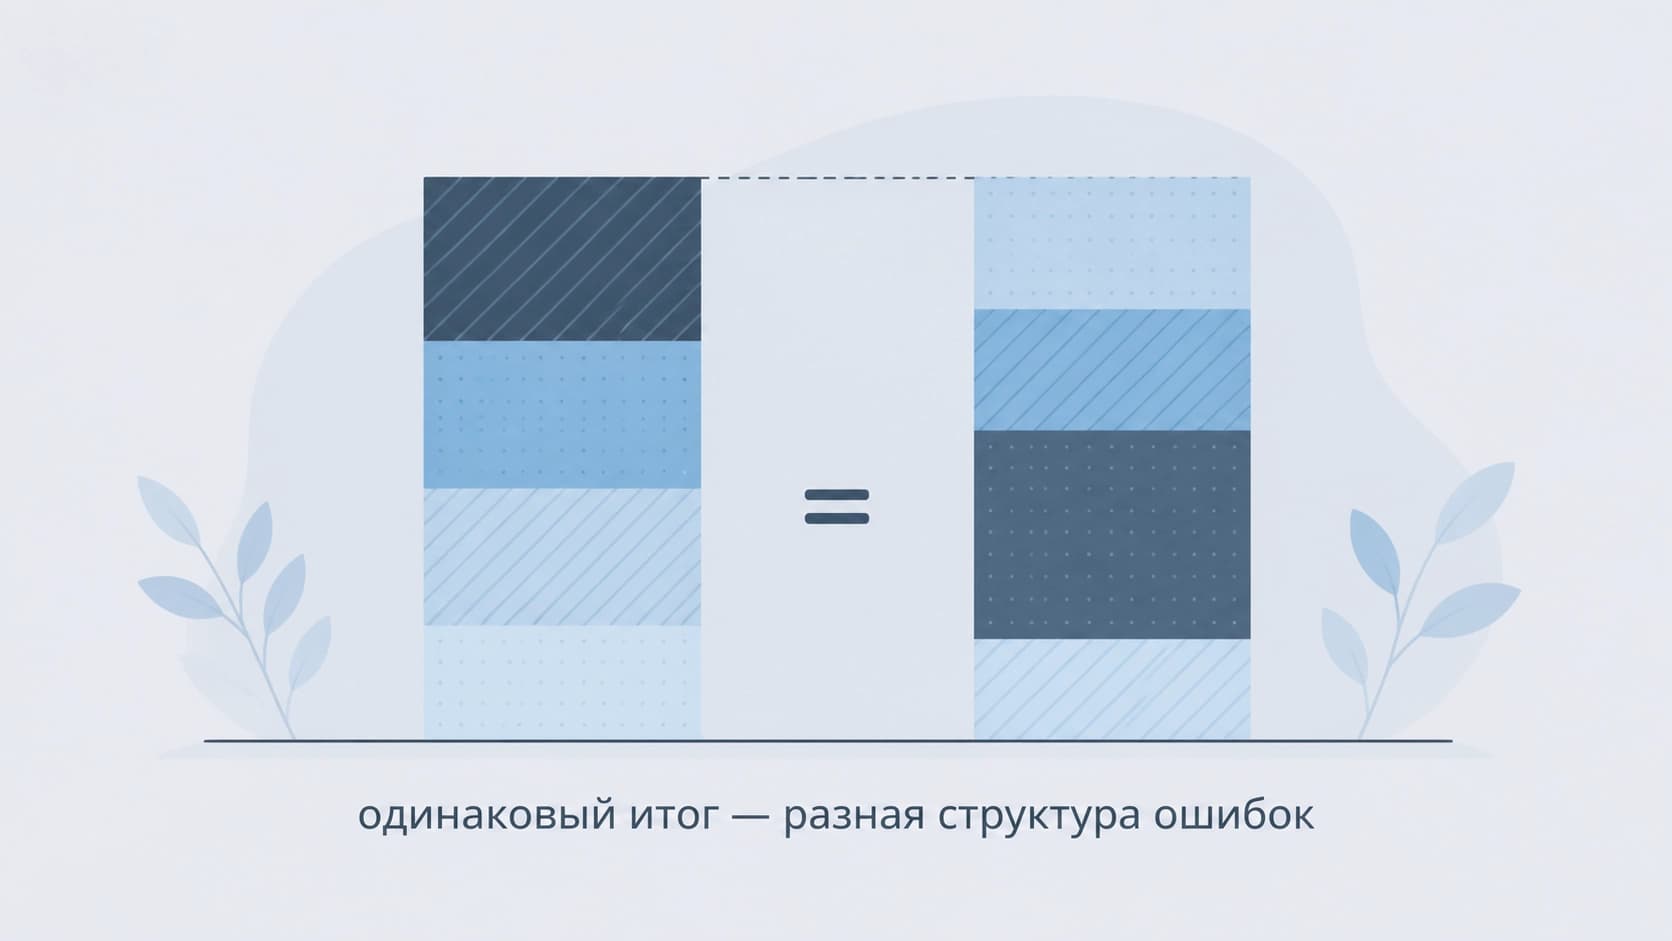
النتيجة التي جرى كل هذا من أجلها: التفكيك الشرطي يكشف فروقاً سلوكية ملحوظة بين أنظمة تبدو متكافئة وفق المقاييس الهامشية. فقد يُظهر خطّا أنابيب النسبة ذاتها من الإجابات الصحيحة، ومع ذلك يختلفان بعشرات النسب المئوية في موضع الخطأ بالتحديد — في الاسترجاع، أو في سياسة الامتناع، أو في التوليد. بالنسبة لمن يختار تهيئة لمنتج، هذان نظامان مختلفان؛ وبالنسبة لمن ينظر إلى رقم واحد في جدول، هما متماثلان.
أين تُصرف ميزانية الوسم
جزء منفصل من البحث مخصص لتوزيع التعليقات التوضيحية. الوسم مكلف، ومن المنطقي أن نسأل: إذا كان بإمكاننا طرح سؤال واحد فقط على البشر عن كل مثال، فأي سؤال نختار؟
جواب المؤلفين: التعليقات التوضيحية عن نجاح الاسترجاع أكثر إفادة من التعليقات عن نجاح المهمة، إذا كان الهدف هو الحكم على التزام النظام بالسياسة (policy adherence). والسبب ليس الراحة، بل بنية النموذج: وسم الاسترجاع يقع على متغير في بداية السلسلة السببية، ولذلك «تُضاء» منه الطبقات الأدنى أيضاً. أما وسم النجاح النهائي فيتعلق بمتغير عند المخرجات، وهو يقول أقل بكثير عما كان يجري في الداخل. ويقدّم المؤلفون لهذا الأثر غير المتماثل تفسيراً من نظرية المعلومات.
والخلاصة العملية بسيطة: إذا كانت الميزانية محدودة، فالأجدر ألا نسأل الموسِّمين «هل الجواب صحيح»، بل «هل وُجد المطلوب». الأول أجمل وقعاً في التقرير، والثاني أنفع للتشخيص.
قاضي LLM كملاحظة مشوّشة
الجزء الثالث — توسيع النموذج ليشمل التقييمات الآلية. يتيح مخطط The RAT ربط أحكام LLM-as-a-judge لا كبديل عن الإنسان، بل كـملاحظات مشوّشة معايَرة: للقاضي احتمال خاص به للخطأ، ويُقدَّر في إطار النموذج الاحتمالي ذاته.
وهذا يرفع التعارض المصطنع بين «وسم بشري مكلف مقابل تقييم آلي رخيص». في نموذج واحد يمكن الاحتفاظ بمجموعة صغيرة من الأحكام الخبيرة التي تضبط المقياس والمعايرة، وتدفق كبير من التقييمات الآلية التي تصقل البارامترات. فيكف القاضي عن كونه عرّافاً ويصبح مصدر إشارة آخر — بخطأ معروف، والأهم أنه قابل للقياس.
ما الذي تأخذه إلى ممارستك
- لا تحسب خط الأنابيب كعقدة واحدة. فبمجرد أن يظهر في التقرير مقياس منفصل للاسترجاع، وآخر لسلوك المولِّد، وثالث للامتناع، تتحول نقاشات «ما الذي تعطّل» إلى تشخيص، لا إلى استعراض فرضيات.
- قيّم السلوك شرطياً. صحة الجواب وملاءمة السلوك في سياق معطى سؤالان مختلفان، والنتيجة الجيدة لا تبرر عملية سيئة.
- ابنِ التقرير على المقاطع، لا على المتوسط. نظامان بجودة شاملة متطابقة قد يحتاجان إلى تحسينات مختلفة تماماً.
- اختر ما توسمه. إذا كان المورد البشري محدوداً، فوضع وسوم على المراحل المبكرة يعطي معلومات أكثر عن النظام ككل.
- أبقِ التقييمات الآلية مقيّدة. قاضي LLM مفيد كملاحظة بنموذج خطأ، لا كحقيقة نهائية.
النظرة البايزية قيّمة هنا لا بسبب الرياضيات في حد ذاتها، بل بسبب انضباط التفكير: فهي تدفعك إلى تسمية ما هو كامن، وما هو مرصود، وكيف يرتبط أحدهما بالآخر مسبقاً. بعد ذلك يكف أي جدول نتائج عن كونه مجموعة أرقام، ويصبح وصفاً لكيفية اتخاذ النظام قراراته.


