
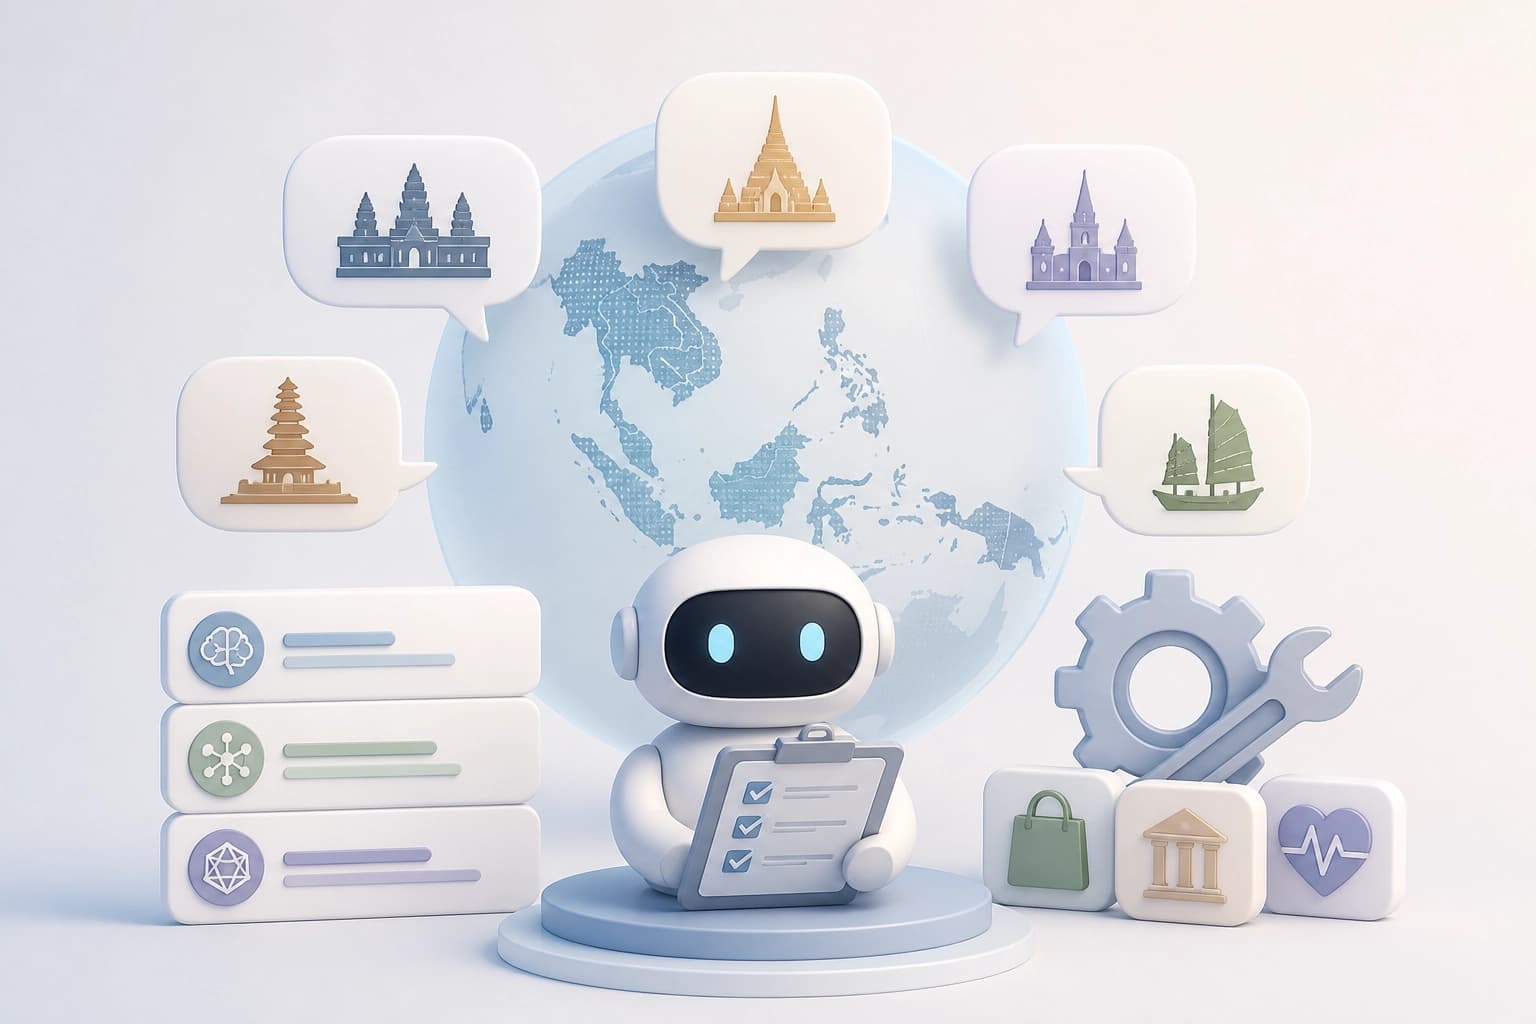
ما هو SEATauBench
SEATauBench هو أول نظام تقييم موجّه للوكلاء للذكاء الاصطناعي السيادي في جنوب شرق آسيا. وهو يكيّف Tau2-Bench لخمسة لغات: الصينية (الماندرين)، والفيتنامية، والتايلاندية، والإندونيسية، والفلبينية.
صُمّم المعيار لتقييم الوكلاء ضمن السياقات اللغوية والتخصصية في المنطقة. والمعيار العملي لتطبيقه هو مدى توافق اللغات التي يجري اختبارها مع الجمهور المستهدف.
ما الظروف التي تتغير أثناء التقييم
يعمل الباحثون على توطين سياق عمل الوكيل بصورة متدرجة. ويغيّرون ثلاثة عناصر:
- لغة التفاعل بين المستخدم والوكيل؛
- مواصفات الأدوات؛
- المجالات التخصصية للمهام.
يتيح هذا التصميم اختبار ما هو أبعد من مجرد تغيير لغة الحوار. فهو يشمل أيضًا التغييرات في الأدوات وموضوعات المهام.
ما الذي أظهرته النتائج
قيّمت الدراسة ثلاثة نماذج. وقارن المؤلفون كيفية تغير قدرات الوكلاء باختلاف مستويات التوطين.
| ظروف التقييم | النتيجة |
|---|---|
| تتغير لغة الحوار فقط | تنتقل القدرات باللغة الإنجليزية بصورة جيدة إلى حدٍّ معقول |
| يُوطَّن سياق إضافي | تنخفض الجودة والموثوقية بشكل حاد |
| يُكيَّف المجال التخصصي بالكامل | تُلاحظ أكبر الخسائر |
يشير المؤلفون إلى أن التقييم باللغة الإنجليزية فقط لا يتنبأ إلا بقدر محدود بقدرات الوكلاء بلغات جنوب شرق آسيا. لذلك، لا تحل نتائج الاختبار باللغة الإنجليزية محل الاختبار في ظروف موطَّنة.
ما الغرض من المعيار
يُقدَّم SEATauBench بوصفه معيارًا تشخيصيًا وخط أنابيب قابلًا لإعادة الاستخدام للتكييف. وهو مصمم لإنشاء وكلاء متعددي اللغات وموثوقين.
عند اختيار التقييم، من المهم مراعاة نطاق التوطين: لغة الحوار، ومواصفات الأدوات، والمجالات التخصصية. فاختبار تغيير اللغة وحده لا يعكس نتائج التكييف الكامل للسياق.
النشر والإصدارات
نُشرت الورقة في EMNLP Findings 2026. أُرسلت النسخة v1 في 27 يونيو 2026، وصدر آخر إصدار، v2، في 5 سبتمبر 2026.
معرّف الورقة: arXiv:2606.28715.


