
AffordanceWAM: إمكانات الفعل كوسيط بين التنبؤ بالمشهد والتحكم في الذراع الروبوتية
يصف العمل نموذجًا توليديًا يتنبأ في الوقت نفسه بمشاهدات RGB المستقبلية والحقول العددية والخرائط الحرارية لإمكانات التفاعل، وبأوامر الروبوت المستمرة، مستفيدًا من مقاطع الفيديو البشرية لزيادة تنوع التفاعلات دون الحاجة إلى تعليقات توضيحية للأفعال أو إعادة استهدافها. وفي RoboCasa وCALVIN ABC→D والمهام الواقعية، يحقق هذا النهج تحسنًا ثابتًا مقارنةً بالخطوط الأساسية المعتمدة على RGB فقط أو على بيانات الروبوت فقط.
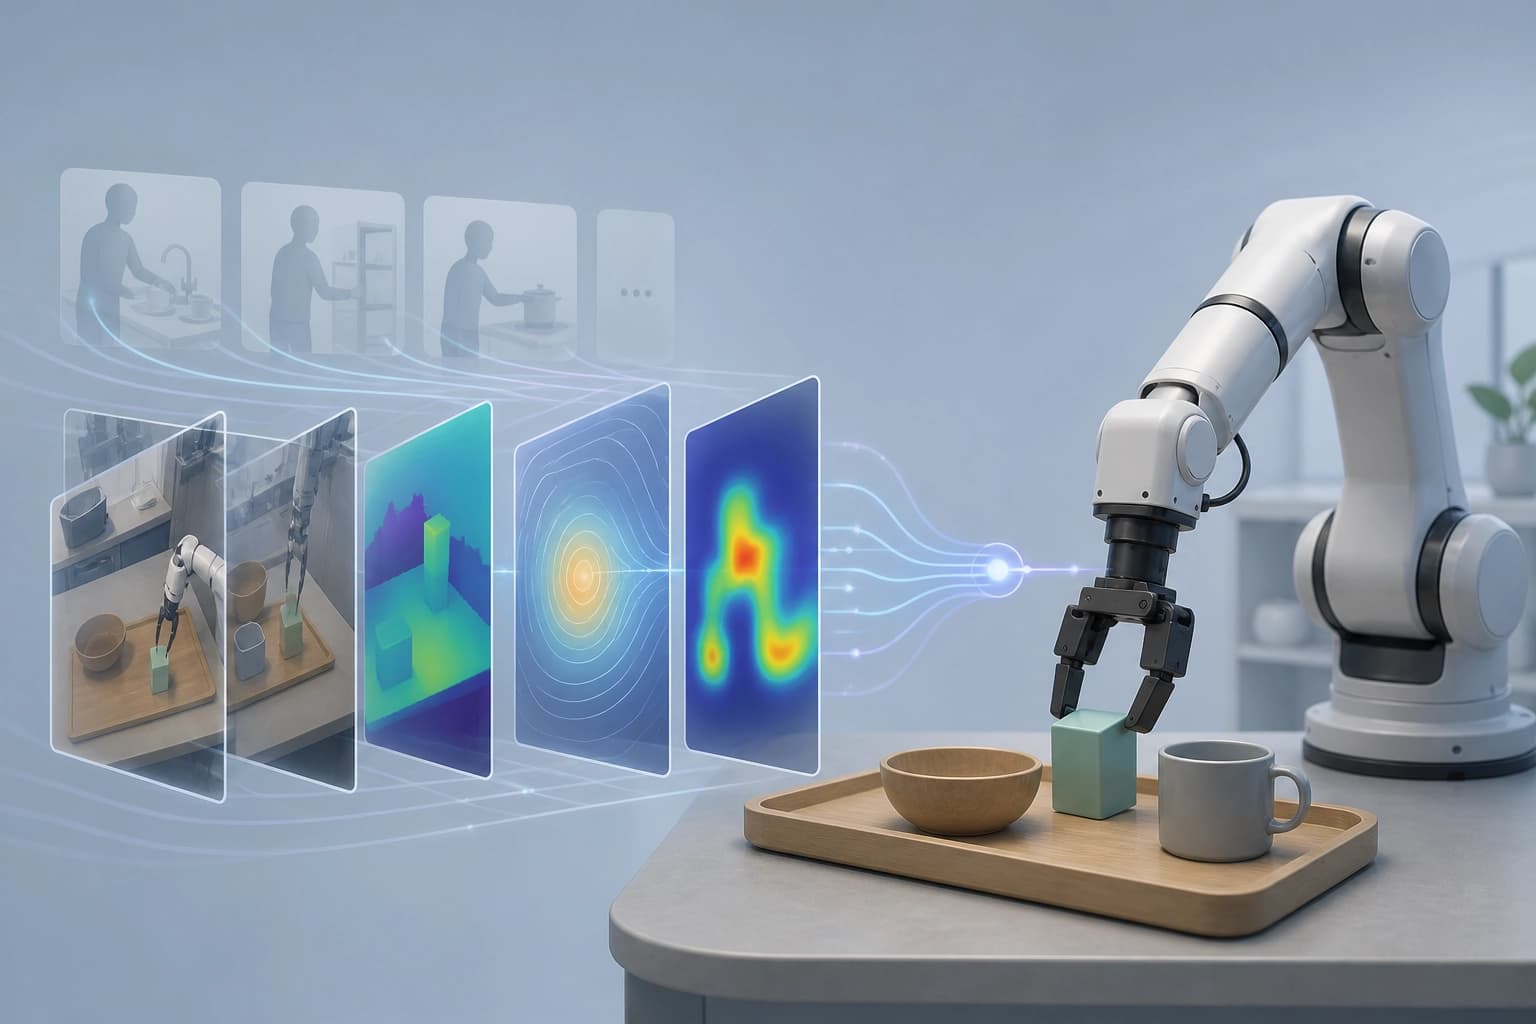
ما هي هذه النموذج
تقدّم ورقة arXiv:2609.22332 نموذج AffordanceWAM، وهو نموذج توليدي للعالم والفعل يراعي الإمكانات التفاعلية، ومصمم للتلاعب الروبوتي. قُدّمت النسخة الأولى في 16 سبتمبر 2026. وآخر نسخة مذكورة هي v3، المنقحة في 18 أكتوبر 2026. يمثّل النموذج الإمكانات التفاعلية المكانية والزمانية المتمحورة حول الأجسام. ويستخدم تنسيقين:
- الإمكانية التفاعلية القياسية (Scalar Affordance)؛
- الخريطة الحرارية للإمكانات التفاعلية (Affordance Heatmap).
توجد هذه التمثيلات داخل العالم المستقبلي الذي يجري توليده. وتربط الإمكانات التفاعلية التنبؤ البصري بالأجسام ومناطق التفاعل ذات الصلة بالمهمة. وهي تشكّل أساسًا مشتركًا للتفاعلات في مقاطع الفيديو التي تتضمن أشخاصًا وروبوتات. وهكذا تصبح الإمكانات التفاعلية وسيطًا بين التنبؤ بالمشهد والتحكم في الذراع الروبوتية.
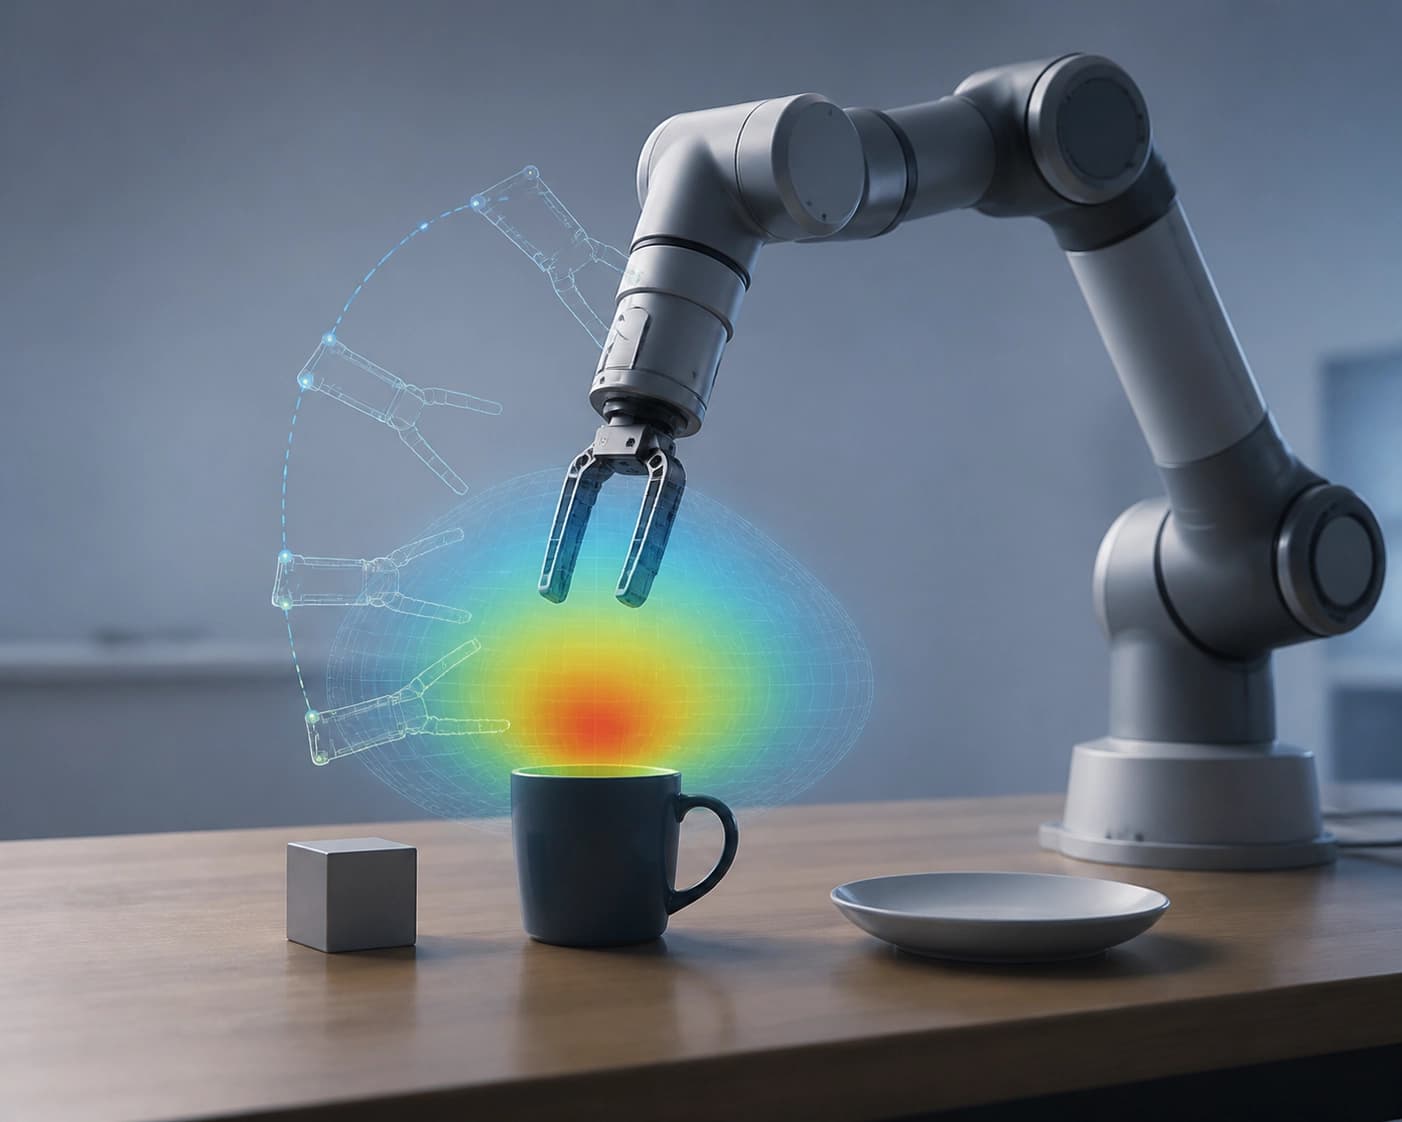
الخلاصة: يوفّر النموذج تنسيقًا صريحًا للأجسام ومناطق الفعل. ويربط هذا التنسيق التنبؤ بالمستقبل بالتحكم.
البنية: خبيران وهدف موحّد
يعتمد AffordanceWAM على Transformer مُدرَّب مسبقًا لانتشار الفيديو. ويستخدم النموذج خبيرًا للعالم وخبيرًا للفعل، لكل منهما معلمات مستقلة. ويربط بينهما الانتباه الذاتي المشترك المقنّع (Masked Joint Self-Attention).
| العنصر | الدور وفقًا لوصف الورقة |
|---|---|
| خبير العالم (World Expert) | خبير للعالم ذو معلمات مستقلة |
| خبير الفعل (Action Expert) | خبير للأفعال ذو معلمات مستقلة |
| الانتباه الذاتي المشترك المقنّع (Masked Joint Self-Attention) | يربط خبير العالم (World Expert) بخبير الفعل (Action Expert) |
| هدف موحّد لمطابقة التدفق | يجمع بين التنبؤ بـ RGB والإمكانات التفاعلية والأفعال |
يتنبأ النموذج معًا بملاحظات RGB المستقبلية، وحقول الإمكانية التفاعلية القياسية، والخرائط الحرارية للإمكانات التفاعلية، وأفعال الروبوت المستمرة. وتجمع هذه المخرجات كلها غاية واحدة لمطابقة التدفق. ولا تحول المعلمات المنفصلة للخبيرين دون التدريب المشترك. ويدعم الربط بينهما التنبؤ المشترك بالعالم والفعل.
الخلاصة: تفصل البنية بين معلمات العالم ومعلمات الأفعال. وفي الوقت نفسه، يحافظ الانتباه الذاتي المشترك المقنّع (Masked Joint Self-Attention) والهدف المشترك على التنبؤ المشترك.
التدريب على مقاطع فيديو لأشخاص ومسارات الروبوتات
يستخدم تدريب AffordanceWAM مقاطع فيديو لأشخاص في مسارات العالم المستقبلي الثلاثة كلها. وتوفر مسارات الروبوتات إشرافًا إضافيًا على الأفعال. ولا يتطلب النقل وجود تسميات لأفعال الأشخاص أو إعادة استهدافها.
| مصدر البيانات | ما يقدمه للتدريب |
|---|---|
| مقاطع فيديو لأشخاص | تدرّب مسارات العالم المستقبلي الثلاثة كلها |
| مسارات الروبوتات | توفر إشرافًا إضافيًا على الأفعال |
تشكل الإمكانات التفاعلية أساسًا مشتركًا للتفاعلات في مقاطع الفيديو التي تتضمن أشخاصًا وروبوتات. لذا يمكن استخدام مقاطع الفيديو التي تتضمن أشخاصًا من دون تسميات لأفعالهم. ويصف المؤلفون الإمكانية التفاعلية بأنها واجهة فعّالة للرؤية واللغة والفعل ونقل المهارات من الإنسان إلى الروبوت.
الخلاصة: توفر الإمكانات التفاعلية واجهة مشتركة لمقاطع الفيديو التي تتضمن أشخاصًا وروبوتات. وهذا يلغي الحاجة إلى تسميات لأفعال الأشخاص وإعادة استهدافها.
التجارب: التحسن والاعتماد على البيانات
اختبر المؤلفون AffordanceWAM على RoboCasa وCALVIN ABC→D وفي مهام التلاعب الواقعية. وتُظهر التجارب تحسنًا ثابتًا مقارنة بالطرق الأساسية. وتستخدم الطرق الأساسية بيانات RGB فقط أو بيانات الروبوتات فقط.
في RoboCasa، تتحسن النتائج باستمرار مع زيادة حجم مقاطع الفيديو التي تتضمن أشخاصًا والموسومة بالإمكانات التفاعلية. ويحدث ذلك مع تثبيت حجم الإشراف على الروبوتات. وتشير هذه النتيجة إلى إسهام الإمكانات التفاعلية في التدريب.
| الحالة | النتيجة وفقًا للورقة |
|---|---|
| خط أساس يعتمد على RGB فقط | تحسن ثابت مع AffordanceWAM |
| خط أساس يعتمد على بيانات الروبوتات فقط | تحسن ثابت مع AffordanceWAM |
| المزيد من مقاطع الفيديو التي تتضمن أشخاصًا والموسومة بالإمكانات التفاعلية، مع تثبيت الإشراف على الروبوتات | تحسن مستمر على RoboCasa |
المعيار العملي للاختيار هو حجم مقاطع الفيديو التي تتضمن أشخاصًا والمرفقة بتعليقات توضيحية للإمكانات التفاعلية. ومع تثبيت الإشراف على الروبوتات، تؤدي زيادة هذا الحجم إلى تحسن مستمر على RoboCasa.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
STAR: التطبيع التكيفي للسياق الزمني ومخطط الخدمات لإدارة الحوادث من البداية إلى النهاية
يُدرّب إطار STAR التمثيلات على المقاييس والسجلات وآثار التتبّع، مستخدمًا تطبيعًا قابلًا للتعلّم يراعي الديناميكيات الزمنية متعددة المقاييس وبنية التبعيات بين الخدمات. وعلى مجموعتي بيانات حقيقيتين، يحقق هذا النهج تحسنًا مستدامًا في جودة اكتشاف الحالات الشاذة وترتيب الأعطال وتحديد الأسباب الجذرية مقارنةً بأحدث الأساليب الأساسية.
10 نوفمبر 2026
ذاكرة خزان تشيرن-سايمونز: ديناميكيات الترابط الذاتية ونقل الكثافة
تتناول المقالة كيفية احتفاظ الخزان بتاريخ الإشارات الواردة في كلٍّ من توزيع الكثافة ودرجات الحرية الهندسية. وتُظهر مقارنة أربعة آليات أن التيار ينشئ مكوّنًا منفصلًا من مكوّنات الاتصال، يغيّر استجابة الكثافة لاحقًا، وأن أخذ جميع السمات المقاسة في الحسبان يحقق تحسنًا طفيفًا في فك ترميز ترتيب النبضات.
10 نوفمبر 2026
التحقق من المرشحين أغلى من توليدهم: طُعوم لمواجهة البحث عن الثغرات باستخدام النماذج اللغوية الكبيرة
يتناول العمل عدم التكافؤ في تكلفة البحث الوكيلي عن العيوب: فتوليد النسخ رخيص، بينما يتطلب تأكيدها عبر تحليل إمكانية الوصول والتنفيذ وإثبات المفهوم الجزء الأكبر من الميزانية، ما يجعل التحقق هدفًا دفاعيًا مستقلًا. وقد خفّض RedHerring المقترح — وهو طُعم قابل للتكيّف مع المستودع ومزوّد بشهادة مخفية — عدد الثغرات الحقيقية المكتشفة بنسبة 38,7–60,4% في 33 مشروعًا ضمن OSS-Fuzz، مع تساوي التكاليف؛ وحتى بعد تحذير الوكيل، ظل الانخفاض عند 37,2%.
9 نوفمبر 2026