
لماذا يُعدّ شكل العرض تفصيلاً ليس تنفيذياً
عندما نختبر ذاكرة نموذج لغوي أو جودة خط أنابيب RAG، فإن ما يهمّنا عادةً هو أمر واحد فقط: هل وصل النموذج إلى الحقيقة المطلوبة. أما الشكل الذي ظهرت به هذه الحقيقة في السياق المُدخَل — كمدخل ذاكرة منفصل، أو ملخّص مضغوط، أو سجل مُهيكل بحقول، أو قطعة خام من المحادثة — فيُعتاد اعتباره من الشؤون الداخلية للنظام. المنطق بسيط: إذا وُجدت الحقيقة، فلا يهم كيف غُلّفت.
يقترح مؤلفو المسوّدة arXiv:2608.23568 عدم الموافقة على ذلك. فورقتهم «RENDER: Controlling Reader-Facing Evidence in LLM Memory Evaluation» (Yuan Si, Simeng Han, Daming Li, Jialu Zhang؛ الإصدار الأول بتاريخ 5 يونيو 2026) تضرب جوهر الفكرة القائلة بأن للذاكرة تقييماً واحداً صادقاً وشاملاً. وبدلاً من ذلك، يقترحون قياسها بالطريقة نفسها التي تُقاس بها الخصائص الأخرى الحساسة للإعداد: تثبيت متغيّر واحد وتنويع قيم متغيّر آخر.
ما الذي يتحكّم به RENDER بالتحديد
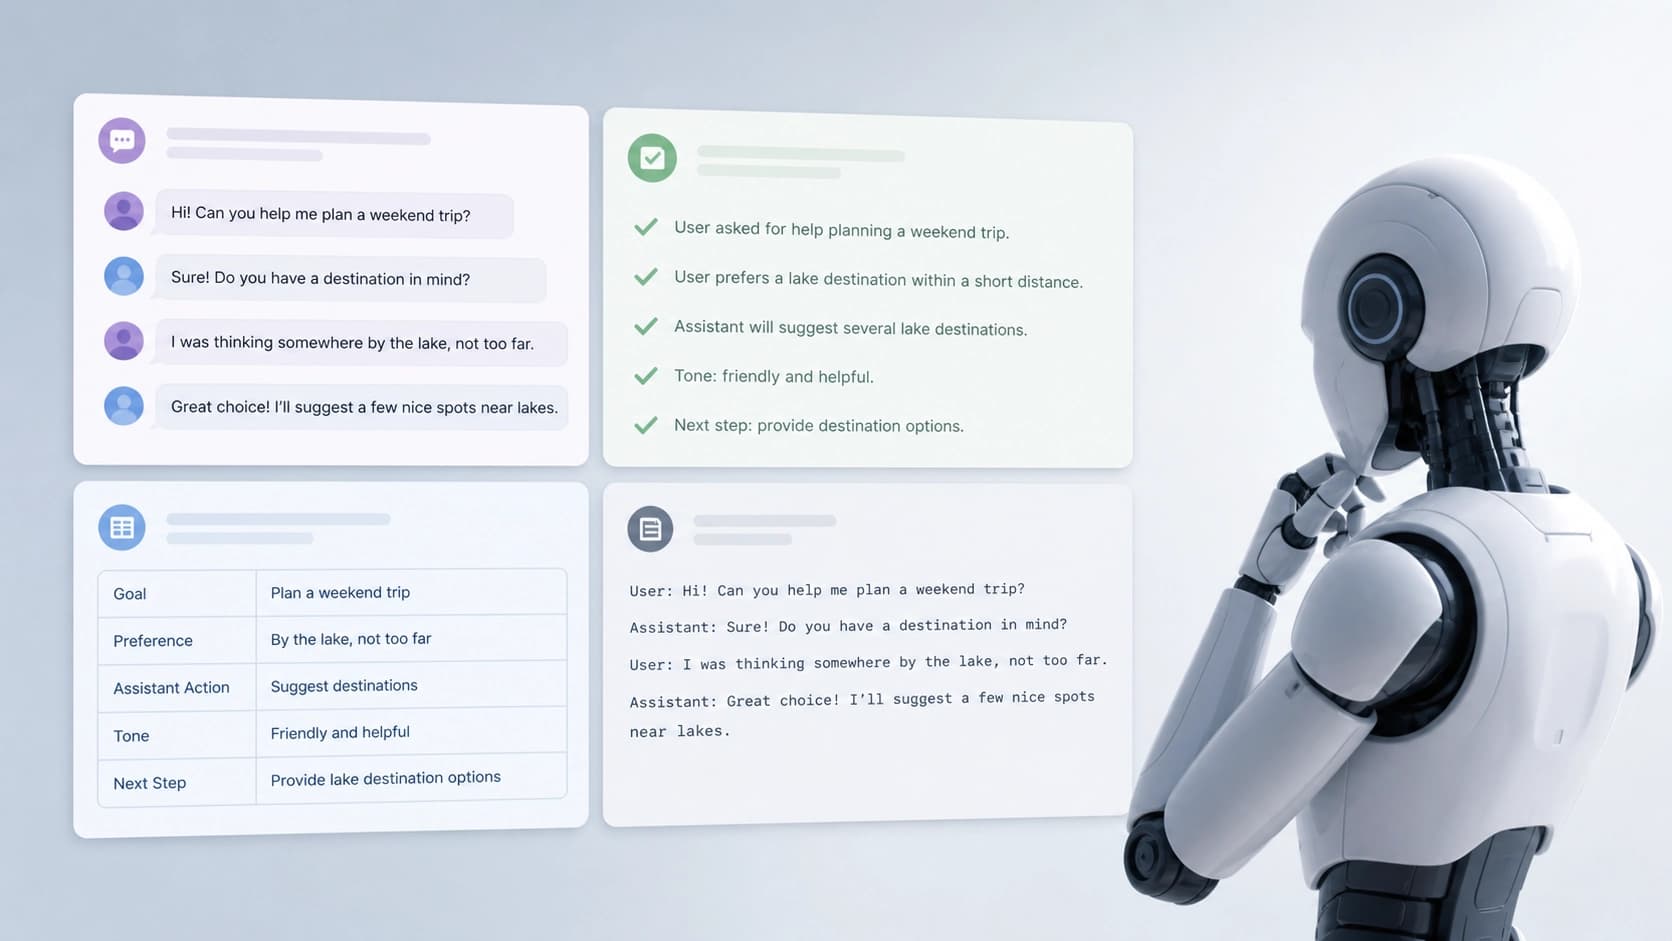
الحوار لا يتغيّر. ما يتغيّر هو فقط الأثر الموجَّه إلى القارئ: ما يراه نموذج الإجابة فعلياً أمامه. هذه الطبقة تحديداً — reader-facing artifact — هي ما يجعلها RENDER متغيّراً قابلاً للتحكّم.
سلّم من خمسة مستويات
جوهر المنهجية هو five-level packet ladder. وهو ليس مجرد مجموعة من الصيغ، بل مقياس يحدّد اللحظة التي يدخل فيها المحتوى الحامل للإجابة إلى مُدخَل النموذج المُجيب. والغاية هي الفصل بين فشلين مختلفين جوهرياً: ألّا يجد النظام الحقيقة المطلوبة، وأن يجدها لكنه لا يستطيع إيصالها بشكل صالح للاستخدام. وبدون هذا المقياس، يندمج هذان الحالتان في سطر واحد من التقرير، ومن ثم تبدأ الاستنتاجات الخاطئة — مثل أن النموذج «يتذكّر بشكل سيئ»، مع أنه في الواقع لم يفكّك التغليف فحسب.
أربعة قوالب للعرض
العنصر الثاني هو قوالب حتمية تحاكي الطرق النمطية لعرض السجل على المستخدم. وهي أربعة:
- مدخلات على نمط ChatGPT — كتل مرتّبة تشبه ما يراه الإنسان في واجهة روبوت محادثة؛
- ملخّصات على نمط LangChain — إعادة صياغة مضغوطة تفقد الصياغات الأصلية لكنها تحتفظ بالجوهر؛
- مدخلات مُنمّطة على نمط MemGPT — بنية بحقول وفئات، مناسبة للمعالجة الآلية؛
- الحوار الخام — الجمل كما هي، بلا تنسيق أو إعادة تغليف.
القوالب حتمية: المدخل نفسه يعطي في كل مرة النص نفسه. وهذا مهم، لأنه لولا ذلك لما أمكن التمييز بين أثر الصيغة والتشتّت العشوائي في التوليد.
ماذا أظهرت الأرقام
تعتمد التجربة على 500 سؤال من LongMemEval وتسعة نماذج. وهنا يجدر التوقف: فهذا ليس تشغيلاً واحداً ولا تجربة واحدة من أجل رقم جميل، بل شبكة «نموذج × صيغة عرض» هي ما يتيح رؤية الأثر.
النتيجة الرئيسية: matched-budget resolved packets تتفوّق على recency-truncated raw dialogue بمقدار 42.4–72.6 نقطة. بعبارة أخرى، إذا وُحّدت الصيغ عند ميزانية قابلة للمقارنة وأُعطي النموذج محتوى يحمل الإجابة فعلاً، فإن الفجوة مع أكثر طرق العرض سذاجةً — الحوار الخام المقتطع حسب الحداثة — تظهر ليست تجميلية بل هائلة.
وفي القوالب على نمط النشر الفعلي، تكون الصورة أهدأ لكنها تبقى كبيرة: الفارق بين أفضل صيغة وأسوأها يبلغ 24.6–48.8 نقطة لكل واحد من النماذج التسعة. أي أنه داخل النموذج نفسه، وعلى الأسئلة نفسها، وبالميزانية نفسها، يمكن «فقدان» أو «كسب» عشرات النقاط لمجرد اختلاف شكل الدليل.
وثمة تفصيل آخر من التقييم الأولي: في 7 من 9 نماذج، تحصل المدخلات على نمط ChatGPT على تقديرات نقطية أعلى من الحوار الخام. وربما يكون هذا أكثر استنتاج مُحرج لمن يبنون مقاييسهم على سجل محادثة «نقي».
الحَكَم أيضاً ليس حقيقة مطلقة
ثمة موضوع منفصل: ماذا يحدث إذا أُعيد حساب التقييمات لا بمقيّم آلي بل بنموذج حَكَم (judge rescoring). يبقى الأثر الإيجابي المُجمَّع للصيغة قائماً، لكن الدلالة بالنسبة لكل نموذج على حدة تصبح مختلطة. وبعبارة أبسط: الاتجاه على مستوى العيّنة كاملة لا يختفي، أما الادّعاءات النقطية من نوع «النموذج X يكسب بفضل الصيغة Y تحديداً» فلم تعد بعد إعادة التحكيم بنفس الموثوقية.
وهذا ليس سبباً للتخلي عن حُكّام LLM، لكنه تذكير جيد: أي تقييم للذاكرة هو في ذاته أداة قياس لها حساسيتها الخاصة تجاه صيغة المُدخَل. وإذا تفاعلت المنظومة والحَكَم بشكل مختلف مع تغليف الأدلة، فقد يذهب الفارق إلى الضجيج أو، على العكس، إلى إشارة زائفة.
أوضح نتيجة: صفر مقابل خمسين
إذا كان لا بد من أخذ رقم واحد من الورقة، فهذا هو الرقم الجدير بالأخذ. ثلاثة نماذج سجّلت 0 % على formal ledger packets، أجابت عن الحقائق نفسها الواردة في natural-language entries بدقة 45.4–53.4 %.
ليس «أفضل قليلاً»، وليس «في حدود هامش الخطأ» — بل من صفر تام إلى إصابة واثقة في نصف الحالات على المحتوى نفسه. ومن الصعب تفسير هذه الفجوة بنقص معرفة النموذج أو سوء الاسترجاع: فالحقائق كانت موجودة، وما تغيّر هو طريقة عرضها فقط. السجل الرسمي القابل للقراءة آلياً كان لسبب ما مستعصياً على النموذج، في حين أن المعلومات نفسها، مصوغة بلغة عادية، قُرئت بلا مشاكل.
وبالنسبة للمهندس، هذه إشارة عملية: إذا كان خط أنابيبك يخزّن الذاكرة في كتل مُهيكلة صارمة، فقد تستهين بشكل منهجي بقدرات النموذج — وفي الوقت نفسه تبالغ في تقدير فائدة الهيكلة.
إلى أي مدى هذا مستقر
لا يتفتّت الأثر عند تعقيد الشروط: فهو يبقى قائماً في ظل retrieval noise، أي عندما تُضاف إلى السياق مقاطع زائدة. بل إنه ينتقل إلى HotpotQA — مجموعة بيانات أخرى مبنية حول أسئلة متعددة الخطوات. وهذا مهم، لأنه يزيل الشك في أن الأمر كله راجع إلى خصوصية معيار واحد للذاكرة الطويلة.
وينبغي أيضاً إبقاء القيود في الاعتبار: فالقوالب تقارب طرق العرض الواقعية ولا تحاكيها حرفياً، والاستنتاجات الخاصة بكل نموذج بعد إعادة التحكيم مختلطة. لذا فالأمر ليس وصفات جاهزة، بل ضرورة ملاحظة هذا المتغيّر أصلاً.
ما العمل بهذا عملياً
استنتاج المؤلفين مباشر تماماً: يجب أن تذكر تقارير تقييم memory/RAG أي reader-facing artifact استُخدم، أو أن تتحكّم فيه صراحةً. وفيما يلي كيف يبدو ذلك تطبيقياً:
- ثبّت الصيغة في وصف الاختبار. «شغّلنا النموذج على LongMemEval» وصف غير كافٍ إذا لم يُذكر الشكل الذي وصل به السجل إلى المُدخَل.
- شغّل صيغتين أو ثلاثاً على الأقل. صيغة جيدة واحدة وأخرى ساذجة (مثل حوار خام مقتطع) كفيلتان بإعطاء فكرة عن حساسية منظومتك.
- لا تقارن النماذج ببعضها على تغليفات مختلفة. الفارق بين 20 و30 نقطة قد يعود بالكامل إلى الصيغة لا إلى النموذج.
- افحص مخططات ذاكرتك المُهيكلة. صفر على سجل رسمي مع إجابات واثقة عن الحقيقة نفسها بنص عادي — هذا خلل في العرض لا في الذاكرة.
- اختبر قناة «النموذج-الحَكَم» بشكل منفصل. إذا كان المُقيّم نفسه حسّاساً للصيغة، تصبح المقياس متحيّزاً.
- ضع في الحسبان كلفة الصيغة. الملخّصات والمدخلات المُنمّطة توفّر الرموز؛ والآن صار لهذا جانب سلبي قابل للقياس، ويستحق الموازنة بوعي.
الفكرة الرئيسية في RENDER بسيطة، ولذلك هي مُحرجة: «تقييم ذاكرة النموذج» دون تحديد طريقة عرض الأدلة هو ادّعاء ناقص. الحوار نفسه، والأسئلة نفسها، والنموذج نفسه، لكن الإجابات مختلفة. والفرق في كيفية إظهارك له ما ينبغي أن يتذكّره.


