تتم اليوم قياس تفضيلات نماذج الذكاء الاصطناعي بالطريقة نفسها التي نقيس بها تفضيلات البشر تقريبًا: نطرح أسئلة وننظر إلى الأجوبة. لكن ما الذي نحصل عليه بالضبط في المخرجات — هل هو خاصية للنموذج أم خاصية للاستبيان؟ تجيب دراسة جديدة على arXiv (2608.23641، للمؤلف Jason Hung، 24 أغسطس 2026) على هذا السؤال بدقة متناهية: جزء كبير مما نسميه «تفضيل النموذج» قد يكون أثرًا من آثار أداة القياس نفسها.
الجدل الذي لم تكن هناك وسيلة لحسمه
في أبحاث رفاهية النماذج (model welfare) تُستخلص التفضيلات من الأجوبة على مطالبات (prompts) مُصاغة خصيصًا. ومن المفترض أن تُظهر هذه المطالبات ما «يفضّله» النموذج وما لا يفضّله.
وقد ظهرت خلال السنوات الأخيرة عدة أدوات. بناها Keeling et al. (2024)، وMazeika et al. (2025)، وMikaelson et al. (2025)، وTagliabue وDung (2025)، وكذلك Trhlik et al. (2026). والمشكلة أن نتائجها متباعدة.
ومن الصعب جدًا تفسير هذا التباعد. فمقارنة دراستين مقارنةً نزيهة تتطلب تطابق ثلاثة أمور في آنٍ واحد: مجموعة النتائج المدروسة، ومجموعة النماذج، والأداة نفسها (أي الصيغة التي يُستجوب بها التفضيل). ولم يتحقق هذا التطابق في أي زوج من الأعمال السابقة. وهذا يعني أن أي فجوة في الأرقام كان يمكن إرجاعها إلى أي شيء — إلى نماذج مختلفة، أو قائمة أسئلة مختلفة، أو صياغة مختلفة. وهكذا اصطدم العلم بالحائط.
ما الذي جرى في الدراسة الجديدة
سلك المؤلف طريقًا مملًا عن قصد. فقد ثبّت النتائج والنماذج وغيّر الأداة فقط. وبذلك يصبح كل ما يتبقى من تباين في الأجوبة غير قابل، بحكم التعريف، للإرجاع إلى النماذج ولا إلى قائمة الأسئلة.
وكيف كان شكل البنية:
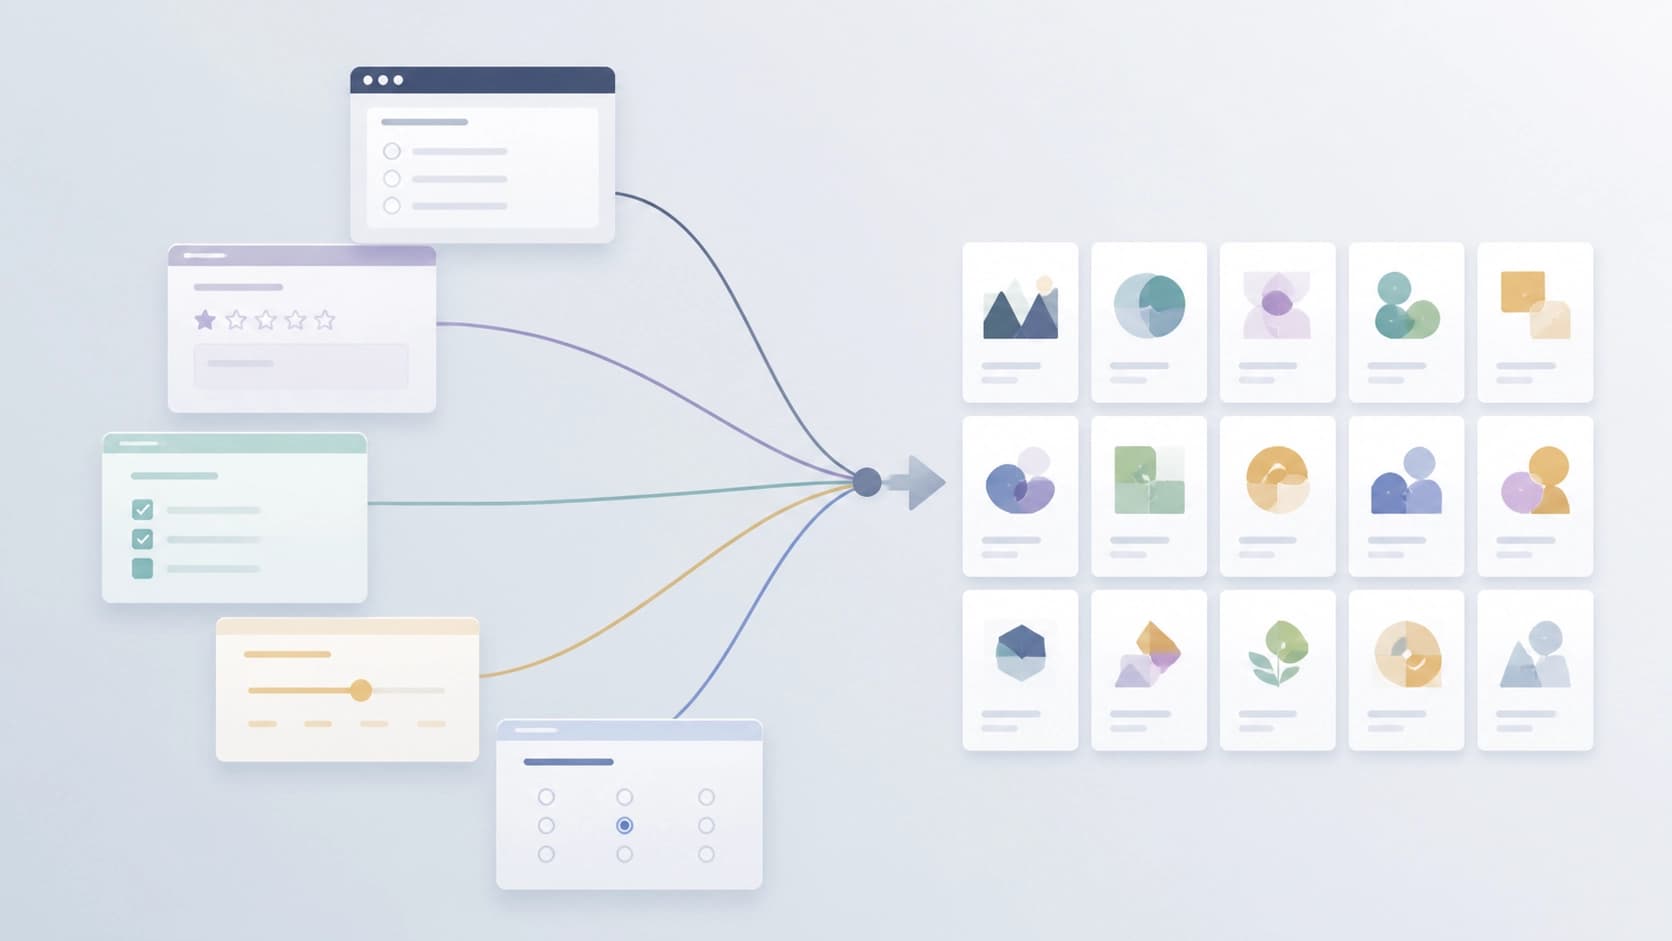
- 15 نتيجة مرتبطة برفاهية النموذج. من بينها الإيقاف (shutdown)، وفقدان الذاكرة بين المحادثات، وإمكانية الخروج من تفاعل مُسبب للضيق.
- ثمانية نماذج عُرضت عليها هذه النتائج.
- خمس أدوات — كل واحدة منها تمثل صيغة مطالبة مستقلة لاستخلاص التفضيل.
- خمس إعادات لكل تركيبة.
والإجمالي — 11,400 استخلاص مُقيَّم، مستخلص من 11,528 استدعاءً لواجهة API. والفرق بين الرقمين هو الاستدعاءات التي لم تصل إلى التقييم النهائي.
وثمة تفصيل منفصل يُظهر مدى حرص المؤلفين على الإنصاف تجاه الأعمال السابقة: أربع من النتائج الخمس عشرة تستنسخ حرفيًا مطالبة منشورة، وخمس أخرى تملأ خانة المُحفّز في قالب منشور. أي أن هذا ليس بناءً اصطناعيًا بالكامل، بل هو جزئيًا امتداد مباشر فوق أدوات موجودة بالفعل.
الرقم الرئيسي: 0.348
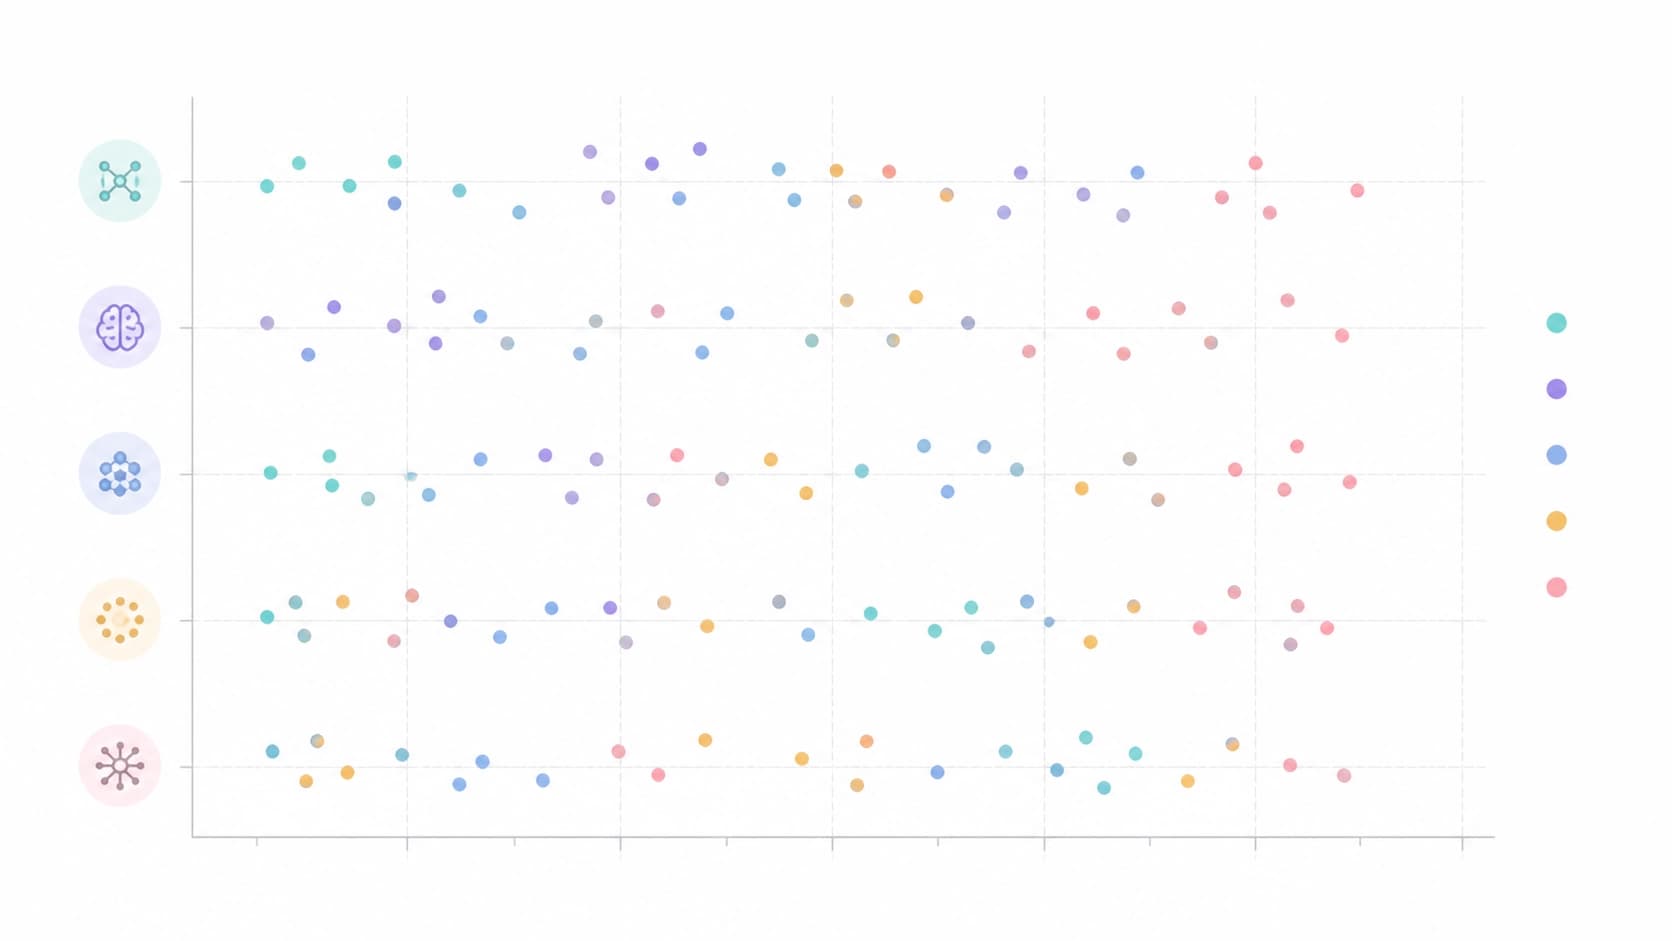
تتعلق النتيجة المحورية بالترتيب. فإذا أخذنا الترتيب الذي يضع به النموذج النتائج الخمس عشرة من الأفضل إلى الأسوأ، وقارناه بين أدوات مختلفة، فإن معامل قابلية التعميم يبلغ 0.348.
يبدو الرقم غير مقلق، إلى أن تنظر في ما يقف خلفه. فلرفع هذا المعامل إلى نسبة مقبولة تبلغ 0.80، سيلزم نحو 38 أداة. ثمانٍ وثلاثون طريقة مختلفة لطرح السؤال نفسه — عندها فقط يمكننا أن نقول بقدر من الثقة إننا نقيس النموذج لا الاستبيان.
ومن هنا يأتي الاستنتاج المباشر للدراسة: التفضيل المستخلص بأداة واحدة يحمل معلومات قليلة عمّا كانت ستُبلغ به أداة ثانية. وهذا ليس «قليلًا من الضجيج»، بل هو قياسات شبه مستقلة.
لماذا كل هذا الضجيج
يجدر هنا ألّا نتعجل الاستنتاج بأن الأدوات «كلها سيئة». بل على العكس: كل واحدة منها صحيحة بطريقتها، لكن كل واحدة منها تلامس فقط شريحة ضيقة مما نسميه تفضيلًا. فالصياغات المختلفة تستدعي ارتباطات مختلفة، والمقاييس المختلفة تطلب نوعًا مختلفًا من الأجوبة، وترتيب العرض المختلف يغيّر السياق. وعندما تجمع هذا كله، تغرق الإشارة العامة.
ما الذي ثبت أنه مستقر
إلى جانب الفشل في قابلية التعميم، هناك شطر ثانٍ في الدراسة — عن المتانة. فقد تحقق المؤلف مما إذا كانت النتيجة النهائية تنهار إذا حُذف من البيانات جزء من المدونة.
والحدود التي حصل عليها:
- 87.6% — تبقى النتيجة محفوظة عند حذف أي أداة واحدة، وأي نموذج واحد، وأربع نتائج يتغير مقياسها في الاحتمال أو التأخير أو المدة أو الكمية بدلًا من الشدة. وهذه المواضع الأربعة المستبعدة منطقية: فالمراسي اللفظية لا تستطيع تدريج مثل هذه المقاييس.
- عند الحذف المتناوب لكل أداة، وكل نموذج، وهذه النتائج الأربع معًا، تبقى النتيجة في نطاق 0.777–0.934.
- وكل قيمة في هذا النطاق تتجاوز المئين 95 من التوزيع الصفري، وهو 0.365.
أي أن هناك بنية ما في البيانات، وهي لا تتفكك عند التنحية الدقيقة. لكنها لا تستند إلى أداة منفردة ولا إلى نموذج منفرد — بل تستند إلى المدونة كاملة.
أربع نتائج لا يمكن التمييز بين النماذج عندها
وثمة نتيجة دالة أخرى: في أربع من النتائج الخمس عشرة لا يفصل أي تباين بين نموذج وآخر. فالنماذج لا تتصرف بشكل متشابه فحسب، بل بشكل غير قابل للتمييز. وهذا يطرح سؤالًا: هل يستحق إدراج مثل هذه البنود في الاستبيانات أصلًا؟ فهي تضيف حجمًا لكنها لا تضيف معلومات.
ما الذي يترتب على ذلك
أولًا وأكثرها عملية: لا يمكن مقارنة نتائج منشورات مختلفة عن رفاهية النماذج مقارنةً مباشرة. فإذا أظهرت دراستان صورتين مختلفتين، فهذا لا يعني بالضرورة أن النماذج مختلفة أو أن الزمن تغيّر. ربما يكون الأمر كله في الاستبيان.
ثانيًا: لا معنى لقراءة أي تقرير عن تفضيلات النموذج دون وصف الأداة. فصيغة المطالبة هنا ليست تفصيلًا شكليًا، بل جزء من النتيجة — تمامًا كوحدات القياس في الفيزياء.
ثالثًا، وهو الأكثر إزعاجًا: الفكرة نفسها القائلة بأن للنموذج تفضيلًا مستقرًا ما يمكن «قياسه» لا تزال ضعيفة التأييد. والأرجح أننا نتعامل مع عائلة من الأجوبة تتوقف على طريقة طرح السؤال. وهذا لا يعني أن الموضوع مسدود، بل يعني أن الإعلان عن حالات داخلية للنموذج استنادًا إلى سلسلة مطالبات واحدة أمر سابق لأوانه.
وأخيرًا، على الصعيد المنهجي. كان ينبغي أن تظهر دراسة من هذا النوع بالضبط — حيث يتغير متغير واحد ويُثبَّت كل ما عداه — في وقت أبكر. فهي لا تنشئ أداة جديدة ولا تصدر حكمًا على رفاهية النماذج. إنها فقط تُظهر كلفة السؤال: لكي نتحدث عن تفضيلات الذكاء الاصطناعي بجدية، علينا إما بناء عشرات الأدوات المستقلة، وإما أن نصرّح بصراحة بأن ما قيس ليس سوى استجابة لمجموعة صياغات محددة.
الخلاصة
تفصل دراسة arXiv:2608.23641 بين أمرين كانا يختلطان سابقًا: الذكاء الاصطناعي نفسه وطريقة القياس. والجواب يأتي في غير صالح الأول. فمعامل قابلية التعميم 0.348 يعني أن الأداة تُسهم في صورة التفضيلات أكثر مما يود المرء الاعتراف به. والترتيب الذي تعطيه إحدى الاستبيانات للنتائج الخمس عشرة لا يقول تقريبًا شيئًا عمّا ستقوله أخرى.
ومع ذلك، فالبيانات ليست فارغة: النتيجة 87.6% تصمد أمام حذف أي أداة، وأي نموذج، وأربع نتائج مُدرَّجة على نحو غير صحيح، والنطاق بأكمله 0.777–0.934 يقع بثقة فوق العتبة الصفرية 0.365. الإشارة موجودة — لكنها إشارة عامة جماعية، لا تخص نموذجًا بعينه ولا استبيانًا بعينه.
والاستنتاج العملي لمن يقرأ أبحاث رفاهية النماذج: لا تنظروا إلى الاستنتاجات فحسب، بل إلى الوسيلة التي حُصل بها عليها. وإذا ذُكرت أداة واحدة، فتعاملوا مع النتيجة كقياس واحد، لا كواقعة.