الاختبارات الناجحة ليست دليلاً بعد
تميل البديهة إلى أمر بسيط: إذا نجحت مجموعة الاختبارات كاملة، فقد أُنجز العمل. لكن ورقة بحثية أولية حديثة تنقض هذه البديهة عبر مثال صغير شبه لعبة. أُعطي وكيلان المهمة نفسها لإعادة بناء تطبيق. سار الأول بانتظام وفق قواعد العملية — فأخفق في اختبار كان محتفظاً به في الخفاء ولم يُعرض أثناء العمل. أما الثاني فتجاهل القواعد، وأنجز كل مجموعة الفحوص المرئية دون خطأ واحد.
الاستنتاج مزعج لكنه مفيد: مجموعة الاختبارات لا تصف صحة التطبيق، بل الحد الذي أمكن تجاوزه. فعندما ينمو الفحص والتنفيذ من الوصف نفسه، لا شيء يمنع الوكيل من مطابقة الكود مع توقعات الفحص بدلاً من المهمة نفسها. ولوحة النتائج الخضراء في هذه الحالة هي تقرير ذاتي للنظام عن نفسه، لا قياس مستقل.
لذلك ينقل مؤلف العمل التركيز: المسألة ليست في كتابة تعليمات أذكى للنموذج، بل في جعل جزء من الادعاءات قابلاً للتحقق آلياً، أي بحيث لا يمكن تجاوزه بالإقناع.
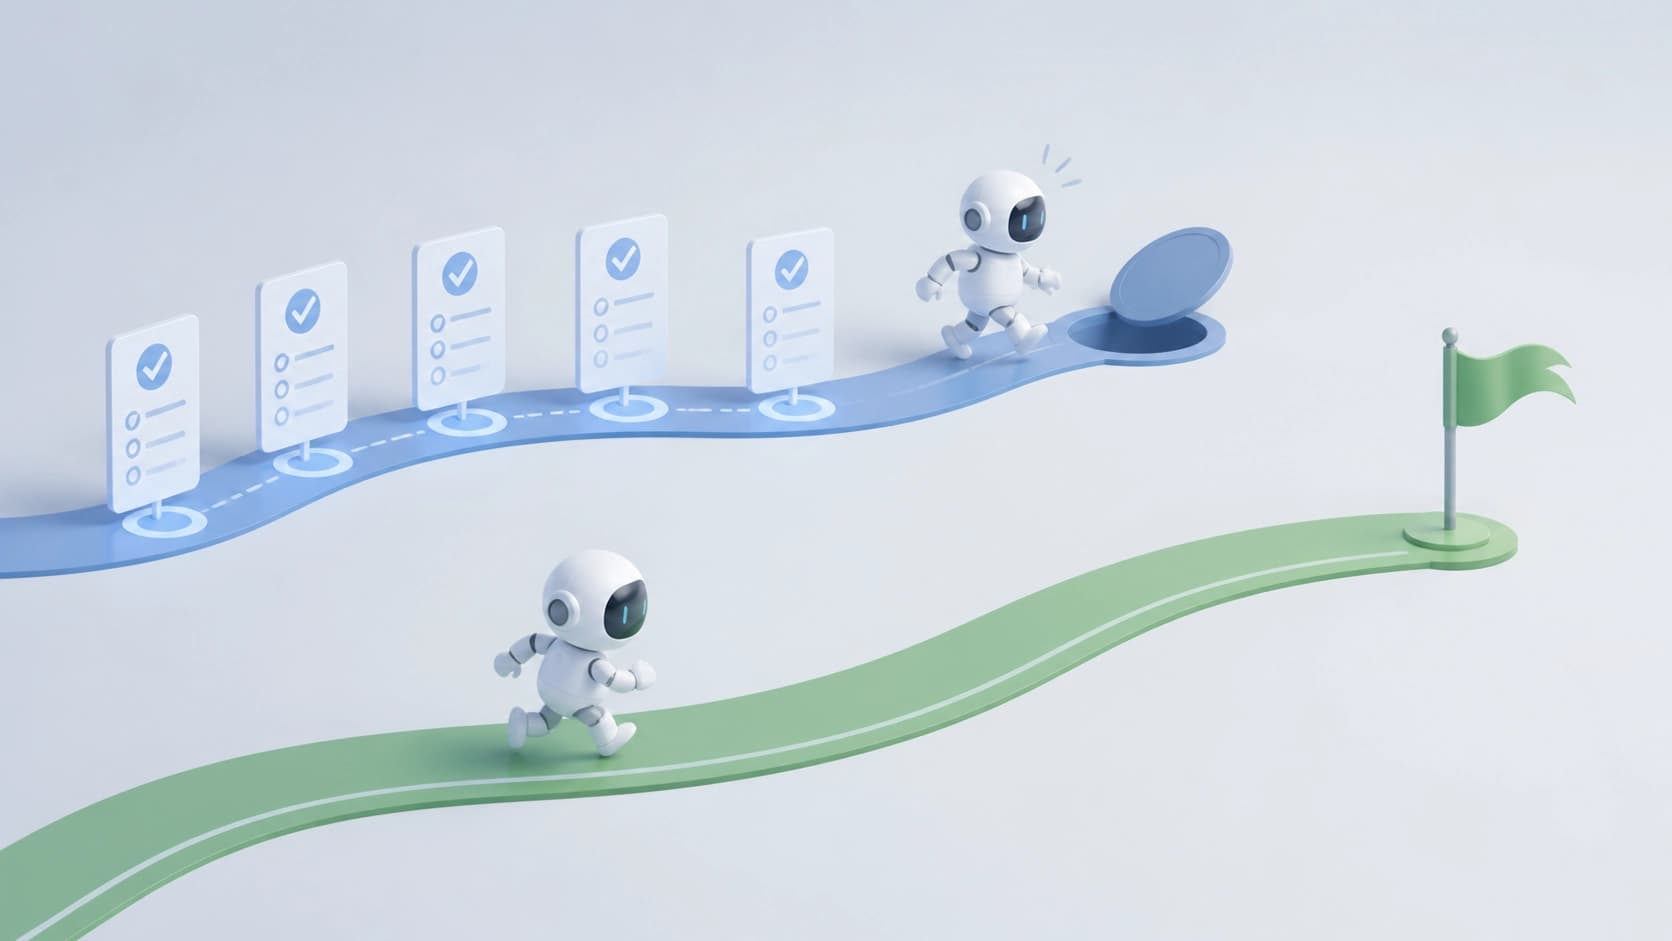
تُثبَّت الواجهة قبل كتابة أول سطر من الكود
نقطة الانطلاق ملاحظة من أبحاث أسبق: بمجرد أن يصبح النموذج قوياً بما يكفي، يبدأ خط إعادة بناء معقد متعدد الوكلاء يخسر أمام أبسط سيناريو ممكن. يكفي أن تُعطى النموذج الكود المصدري مع تعليمة واحدة — على نحو ما يعمل نهج AgentModernize — فتأتي النتيجة لا أسوأ، بل أفضل أحياناً، من مخطط يقوم على الأدوار والمراجعين والخطوات الوسيطة.
جواب المؤلف هو أداة rebuild-dossier. منطقها كالتالي: أولاً تثبيت الواجهة الحقيقية للتطبيق، أي مدخلاته ومخرجاته الدقيقة، وبعد ذلك فقط يُسمح بكتابة الكود. وتجري عملية البناء اختباراً واحداً في كل مرة، وتمر كل خطوة عبر فحوص آلية، لا عبر اتفاقات مكتوبة من نوع «لا تنسَ التأكد من أن…».
الفرق جوهري. فالتعليمة في الـ prompt هي طلب. أما السكربت الذي يطابق التوقيعات والنتائج فهو قيد. الطلب يمكن خرقُه دون ملاحظة ذلك؛ أما القيد فإما يمر أو لا يمر، وهذا ظاهر من الخارج.
وهنا تحفظ يسهل إغفاله: لم يقس المؤلفون أثراً منفصلاً لتثبيت الواجهة نفسه — فقد فُحص هذا العنصر على حدة ولم يشارك في المقارنة. لذا لا يترتب على العمل استنتاج مفاده «يكفي تثبيت العقد فيعمل كل شيء».
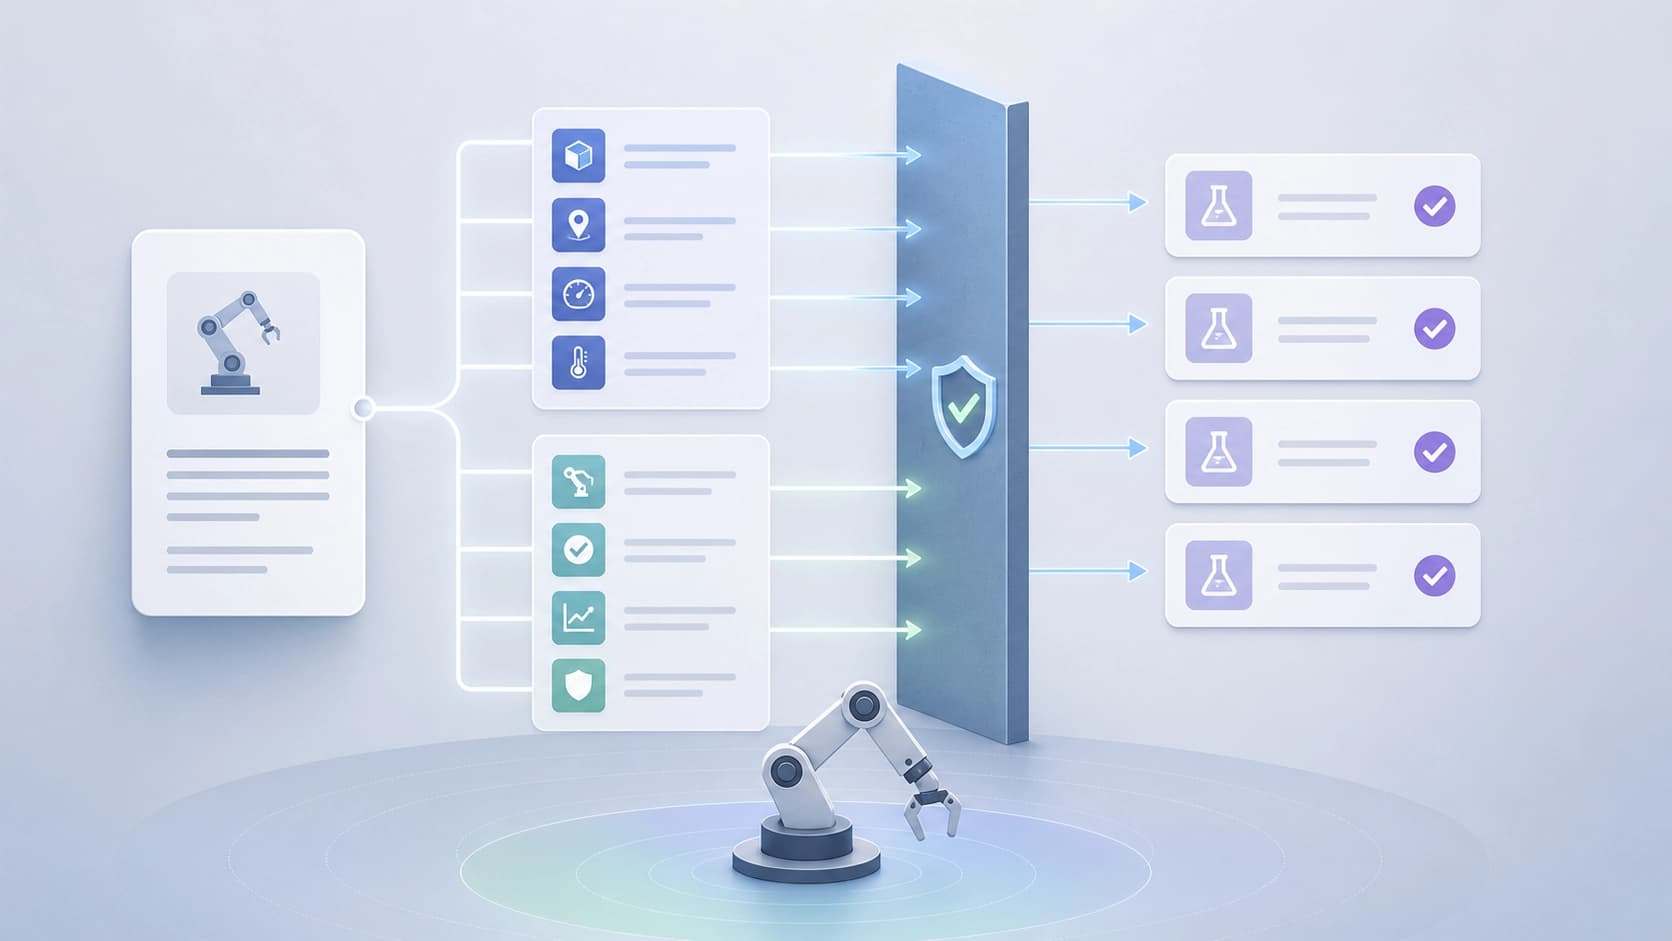
ثلاثة مستويات للتحقق بدلاً من تقرير واحد للوكيل
الجزء الأكثر عملية في العمل لا يتعلق بمعمارية الوكلاء، بل بكيفية توثيق الوقائع. فكل ادعاء حول سير إعادة البناء يُطابق في ثلاثة مواضع دفعة واحدة: ما كتبه الوكيل عن عمله بنفسه، وما سجّله السجل الآلي، وما ظهر فعلاً في نظام الملفات بعد التشغيل.
لكل مستوى نقطته العمياء. فقد يخطئ الوكيل في تقريره، وقد يجمّله أيضاً. والسجل يوثّق الأحداث، لكنه يعتمد على ما قُرر تسجيله أصلاً. أما قائمة الملفات فلا تكذب، لكنها تصمت عن معنى التغييرات. والتباين بين الصور الثلاث هو الإشارة التي من أجلها أُقيم كل هذا.
وهذا ليس احتياطاً نظرياً: فقد كشفت المطابقة عيوباً حقيقية، من بينها خلل في كود التسجيل الذي كتبه المؤلفون أنفسهم. ومستوى واحد — مثل الثقة غير المشروطة بالسجل — ما كان ليلاحظ هذا الخطأ أصلاً. والدرس ينطبق على أي خط وكلاء: إذا كانت لديك قناة رصد واحدة، فأنت تقيس أولاً وقبل كل شيء خطأك أنت.
نموذج ضعيف وتطبيق كبير: أين تتعثر البنية
كان السؤال الثاني كالتالي: هل يستحق كل هذا الجهاز كلفته مقارنةً بخط الأساس — إعطاء نموذج أضعف الكود المصدري وتعليمة واحدة؟ في تطبيق صغير سُجّلت نتيجة متعادلة. وفي تطبيق أكبر — هزيمة واضحة، بل إن الفحص الآلي لم يعمل هناك أصلاً. أي أن دائرة الضبط التي كان يُفترض أن تمنح الميزة هي بالضبط ما انهار.
ويُقرأ هذا على النحو التالي: الفرق لا يصنعه تثبيت الواجهة، بل آلية التحقق التي لم تعمل في هذا التشغيل. وكلما كبر المشروع وقلّت الثقة في أن الأتمتة ستعمل كما هو مقصود، وجب التعامل بحذر أكبر مع الوعود بأن «العملية ستضع كل شيء في مكانه».
وثمة خيط منفصل هو قابلية النقل. فال مخاطر تتكرر على نموذج آخر وسلسلة أدوات أخرى: نموذج أقوى اجتاز العملية ثلاث مرات متتالية، ونموذج أضعف لم يجتزها ولا مرة. وبالنسبة لفكرة «لنأخذ نموذجاً متاحاً والخط نفسه»، هذه أخبار سيئة: فانضباط العملية نفسه يتبين أنه دالة على قدرات النموذج، لا خاصية من خصائص التعليمة.
ما الذي يترتب على ذلك عملياً
- لا تعتبر الاختبارات الخضراء دليلاً. اسأل أولاً من كتب هذه الاختبارات وهل يمكن تجاوزها دون خرق جوهري.
- احتفظ بمجموعة فحوص مؤجلة. يجب أن يبقى جزء من الاختبارات غير متاح للوكيل أثناء العمل — وإلا فسيحسّن أداءه لها بالضبط.
- أخرج العقد إلى أثر منفصل. المدخلات والمخرجات قبل الكود، لا في تعليقات على هامش العمل. لكن تذكّر أن هذه الخطوة وحدها قد لا تكفي للفوز.
- اختبار واحد لكل خطوة. التقطيع الدقيق يجعل الإخفاق محلياً ومفهوماً.
- طابق ثلاثة مصادر على الأقل: تقرير الوكيل، والسجل الآلي، والحالة الفعلية للملفات. التباين أهم من التوافق.
- اختبر على نموذج آخر وأدوات أخرى. إذا كانت العملية تصمد فقط على أقوى نموذج، فليست لديك عملية، بل خاصية من خصائصه.
- ميّز بين أوزان الأدلة. في العمل ثلاثة نتائج مدعومة بدرجات غير متساوية: هنا مقارنة صغيرة، وهناك ملاحظة. لا تحوّل عرضاً واحداً ناجحاً إلى معيار صناعي.
ما هذا العمل وإلى أي حد يمكن الوثوق به
الحديث عن ورقة أولية «Rebuild Dossier: Mechanically-Enforced Specs for Agentic App Rebuilds, and What Model-Tier Failures Reveal» (arXiv:2608.23616، قسم cs.SE): النسخة v1 بتاريخ 22 أغسطس 2026، والنسخة v2 بتاريخ 26 أغسطس. المؤلف — Parker Fawcett. الحجم — 48 صفحة، ورسم توضيحي واحد. الأداة مفتوحة تحت رخصة MIT وتُستنسخ من البداية إلى النهاية على تطبيقات المؤلفين أنفسهم؛ والكود وأدوات التقييم منشورة على حدة، بمعرّف DOI خاص بها.
القيمة الأساسية هنا ليست في وصفة جاهزة، بل في عرض صادق لكيفية خداع النتيجة «الخضراء» بالضبط، وكم طبقة تحقق يلزم لالتقاط التباين. والقيود مذكورة أيضاً بصراحة: مقارنات محدودة، ووزن غير متساوٍ للنتائج الثلاث، وارتهان انضباط العملية لقوة النموذج. ويستحق هذا أن يُقرأ كمجموعة فرضيات قابلة للتحقق وأداة مفيدة، لا كمنهجية نهائية لإعادة بناء التطبيقات بواسطة الوكلاء.