
WILSON: دمج مستويات التكبير وشرائح المريض للتحليل الباثومورفولوجي وإعداد التقارير
تقدّم هذه الورقة البحثية الأولية نموذج WILSON، وهو نموذج للرؤية واللغة يرمّز صور الشرائح الكاملة وسلاسل العينات لمريض واحد عند درجات تكبير مختلفة، بدلًا من الاقتصار على شريحة منفردة «أفضل». ومن دون ضبط دقيق للمهمة، يتفوّق على نماذج الشرائح المتخصصة والأكبر حجمًا في عدد من المقاييس، مع عبء حوسبي أقل بكثير، كما حصلت أوصافه التشخيصية على تقييمات أعلى من اختصاصيي علم الأمراض.
لماذا لا تكفي شريحة واحدة ممثّلة
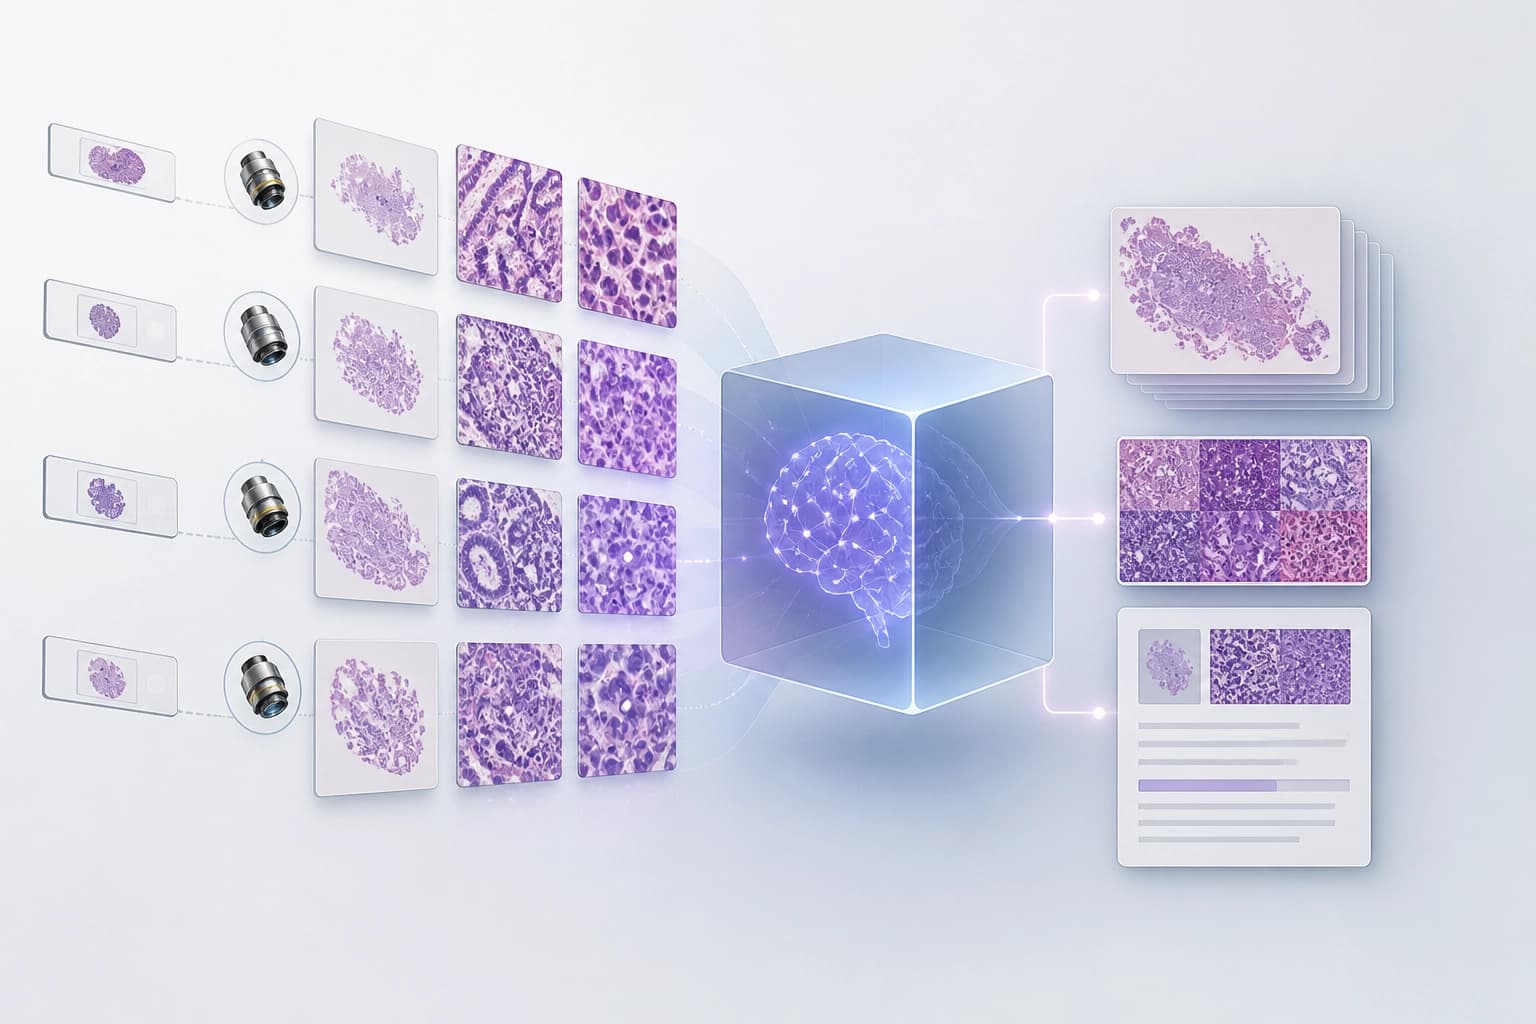
يفحص اختصاصيو علم الأمراض مقاطع الأنسجة عند درجات تكبير مختلفة وعلى عدة شرائح زجاجية. ويجمعون المعلومات الشكلية لوضع التشخيص. ترمّز معظم النماذج التأسيسية لعلم الأمراض آلاف رقع الصور من شريحة واحدة ممثّلة («الأفضل»). ثم تجمع النماذج هذه السمات.
قيود هذا النهج:
- تتلقى النماذج شريحة واحدة «أفضل»، لا الحالة بأكملها؛
- لا تُربط السمات المستخلصة من درجات تكبير مختلفة ضمن تمثيل موحّد؛
- يُفقد السياق على مستوى المريض عند تجميع الرقع.
معيار عملي: تتطلب المهمة على مستوى الحالة نموذجًا يقبل عدة شرائح ودرجات تكبير مختلفة. ولا تغطي شريحة واحدة ممثّلة هذا النوع من المهام.
كيف يدمج النموذج درجات التكبير والشرائح
WILSON نموذج تأسيسي للرؤية واللغة. يمثّل النموذج صور الشرائح كاملة والحالات التي تتضمن عدة شرائح من خلال تراكيب متعددة درجات التكبير. وهو يدعم التحليل على مستوى المريض.
ما الذي يشمله التمثيل:
- صور الشرائح كاملة؛
- حالات تضم عدة شرائح زجاجية؛
- درجات تكبير متعددة ضمن تراكيب متعددة درجات التكبير.
الخلاصة: يحافظ النموذج على المعلومات الشكلية من مقاييس وشرائح مختلفة ضمن تمثيل واحد. وهذا ما يميّزه عن النهج القائم على شريحة واحدة «أفضل».
التدريب ونطاق البيانات
تتألف عينة تدريب WILSON من نحو 189,000 شريحة. وتشمل البيانات 42 عضوًا و838 كيانًا تشخيصيًا.
النطاق:
- 189,000 شريحة؛
- 42 عضوًا؛
- 838 كيانًا تشخيصيًا.
تحدد قائمة الأعضاء والكيانات إطار التحقق من المهمة. ويطابق الاختصاصي العضو والكيان التشخيصي مع هذه القائمة.
النتائج من دون تدريب خاص بالمهمة
تفوق WILSON نموذجًا متخصصًا على مستوى الحالة في مقياس F1 الكلي، من دون تدريب خاص بالمهمة. وبلغت النتيجة 0.52 مقابل 0.38.
| المقارنة | WILSON | البديل |
|---|---|---|
| مقياس F1 الكلي لمهمة على مستوى الحالة | 0.52 | 0.38 |
| العمليات الحاسوبية | أقل بمقدار 400–1,350 مرة | نماذج أكبر بكثير على مستوى الشريحة |
كما حقق النموذج نتائج بمستوى نماذج أكبر بكثير على مستوى الشريحة. وفي الوقت نفسه، يتطلب عمليات حاسوبية أقل بمقدار 400–1,350 مرة.
الخلاصة: ليس من الضروري أن ترتفع جودة التحليل على مستوى الحالة بالتوازي مع التكلفة الحاسوبية. ويوفر التمثيل المدمج متعدد المقاييس معيارًا عمليًا.
الضبط الدقيق لمهام محددة
حسّن الضبط الدقيق الشامل من البداية إلى النهاية نتائج WILSON في المهام التالية:
- التصنيف الفرعي لسرطان الثدي؛
- تصنيف الخلايا اللمفاوية السدوية.
معيار عملي: يجدر النظر في الضبط الدقيق الشامل من البداية إلى النهاية عند التعامل مع مهمة محددة. يحل النموذج الأساسي التحليل على مستوى الحالة من دون ضبط دقيق، فيما يحسّن الضبط الدقيق أداءه في مهام منفردة.
البحث وإنشاء النصوص التشخيصية
في استرجاع الصور والنصوص، تفوق WILSON على PRISM في مقياس recall@1. وكانت النتيجة 75.6% مقابل 58.1%.
| المقياس | WILSON | PRISM |
|---|---|---|
| recall@1 | 75.6% | 58.1% |
حصلت الأوصاف التشخيصية التي أنشأها WILSON على تقييمات أعلى من خمسة اختصاصيين في علم الأمراض حاصلين على شهادة البورد. وكانت تقييمات النماذج المنافسة أقل.
معيار عملي: للبحث وإعداد التقارير، تكتسب قدرتان أهميةً، وهما الاسترجاع وإنشاء النصوص. ويُتحقق منهما باستخدام مهام تحاكي سير العمل.
ما الذي يعنيه ذلك عند اختيار نموذج
يخلص المؤلفون إلى أن التمثيلات المدمجة متعددة المقاييس يمكن أن تدعم نماذج تأسيسية فعالة حاسوبيًا وموجّهة سريريًا. ويعني ذلك عمليًا ضرورة إجراء عدة فحوص عند الاختيار.
المعايير:
- يقبل النموذج عدة شرائح؛
- يربط النموذج بين درجات التكبير المختلفة؛
- يجري التحليل على مستوى المريض؛
- تُقاس الجودة باستخدام مهام على مستوى الحالة؛
- تؤخذ العمليات الحاسوبية في الحسبان؛
- يُتحقق من الاسترجاع وإنشاء النصوص كلٌّ على حدة.
الخلاصة: لا توفر شريحة واحدة «أفضل» وتجميع آلاف الرقع سياق المريض كاملًا. ويُختار النموذج بناءً على كيفية جمعه لهذا السياق وعدد العمليات الحاسوبية التي يتطلبها.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
التشخيص التدريجي لوكلاء واجهة المستخدم الرسومية أثناء تحليل لوحات المعلومات: معيار DashAct
يقدّم DashAct معيارًا مرجعيًا يضم 348 مسارًا راجعها بشر، ويحلّل عمل وكلاء واجهات المستخدم الرسومية مع لوحات التحكم التفاعلية إلى ثلاث مراحل وأربعة شروط بصرية. وتُظهر النتائج مشكلات مستمرة في التنبؤ بالإجراءات وربطها بالأهداف البصرية، فضلًا عن اعتماد استجابة الوكلاء على الدعم السياقي والمكاني.
11 نوفمبر 2026
الثوابت كثيرة الحدود القانونية في تشخيص أعطال محاكيات التعلم المعزز: أين تكون مفيدة حقًا
تبحث الدراسة مدى جدوى إدراج القوانين الفيزيائية في نماذج الديناميكيات المتعلَّمة: فالثوابت المستخلصة من المسارات والمحوَّلة إلى صيغة معيارية باستخدام قواعد غروبينر تحقق تحسناً متواضعاً في التنبؤات، لكنها فعّالة في التشخيص، إذ تتيح تحديد موضع القيد المنتهك والكشف عن المعلمة الخاطئة بعينها.
10 نوفمبر 2026
AURA-Eval: كيفية التحقق من أن وكيل LLM قد أدرك المخاطر وغيّر خطوته التالية
يقيّم هذا الإطار سلوك وكلاء LLM لا استنادًا إلى الحكم النهائي، بل إلى استجابتهم للمخاطر عند نقاط محورية: إذ تُقطع مسارات استدعاء الأدوات، ثم يُطلب من النموذج مواصلة الاستدلال والتصرف، بينما تحلل لجنة من محكّمي LLM رصد المخاطر وطبيعة الخطوة ومدى أمانها. وفي 1249 مهمة جُمعت من 157 مسارًا لـ R-Judge، ازداد تواتر التصرفات غير الآمنة لدى 20 نموذجًا عند غياب مسار آمن، كما أدى رفع الإشراف قبل التنفيذ إلى تحويل 52,3% من الحالات الآمنة في الأصل إلى حالات غير آمنة.
10 نوفمبر 2026