
ما تم إتاحته مفتوح المصدر
غالبًا ما تصطدم الأحاديث حول «أي نموذج أفضل» بمشكلة واحدة: لم يتحقق أحد من الأرقام. تُجرى القياسات على جهاز مختلف، وبترميز كمي مختلف، وفي إصدار مختلف من بيئة التشغيل — ومقارنتها ببعضها بلا معنى. اقترحت شركة Liquid AI معالجة ذلك بالانفتاح وقابلية إعادة الإنتاج: فقد أطلقت Pipette، منصة لتقييم النماذج الأساسية على أجهزة الحوسبة الطرفية. وقد تحققت Artificial Analysis من المنهجية بشكل مستقل.
الفكرة الرئيسية التي يقوم عليها البناء بأكمله: السلوك على الجهاز هو خاصية للنظام المنشور، وليس للنموذج بمعزل عن غيره. وهذا يعني أن وحدة القياس يجب ألا تكون «النموذج»، بل التكوين الكامل: الأوزان زائد مخطط الترميز الكمي زائد بيئة التشغيل زائد العتاد المحدد. ومن هذه الأطروحة تنشأ بنية مجموعة البيانات، وكذلك الطريقة التي ينبغي بها قراءة جميع المقارنات أدناه.
ما الذي دخل في مجموعة البيانات الأولية
- خمس مقاييس للأداء على الجهاز؛
- أكثر من ألف تكوين في تركيبة نموذج × ترميز كمي × بيئة تشغيل × جهاز × طول السياق؛
- أكثر من 30 نموذجًا وعدة صيغ للترميز الكمي؛
- إصدارات llama.cpp لأنظمة macOS وiOS وWindows وAndroid؛
- أطوال سياق من 256 إلى 8,192 رمزًا.
أُجريت القياسات الأولى المنشورة على MacBook Pro مزوّد بـ M5 Max، وiPhone 17 Pro، وGalaxy S26 Ultra. أما بالنسبة إلى AMD Ryzen AI Max+ 395 وRadeon 8060S فلا تزال النتائج موسومة بـ «coming soon» — أي أن المنصة مُعلنة منذ البداية كمتعددة المنصات، لكن التغطية العتادية لا تزال تنمو.
أربعة استنتاجات من أولى عمليات التشغيل
معاملات متطابقة — سلوك مختلف على السياق الطويل
مثال جيد يوضح لماذا نحتاج هذا القياس أصلًا. نموذجان بـ 350M معامل عند نفس Q4_K_M على نفس الهاتف يتصرفان بشكل مختلف مع نمو رموز الإدخال: يحافظ Granite-4.0-H-350M على 78.4% من معدل نقل البيانات عند فك الترميز عند الانتقال من 256 إلى 4,096 رمز إدخال، بينما Granite-4.0-350M يحافظ على 33.8% فقط. عدد المعاملات هنا لا يلمّح إلى شيء: الفرق يكمن في البنية وفي كيفية انسجامها مع بيئة تشغيل وشريحة محددتين.
التنشيط المتناثر يوفّر الحسابات لكن ليس الذاكرة
يفكّ LFM2.5-8B-A1B ترميزه على نفس الهاتف عند 2,048 رمز إدخال أسرع بـ 2.4 مرة من Qwen3.5-4B، وأسرع بـ 2.6 مرة من Ministral-3-3B-Instruct-2512. السر يكمن في التنشيط المتناثر: يُستخدم لكل رمز نحو 1.5B من أصل 8.5B معامل. لكن ذروة استهلاك الذاكرة عند ذلك تبلغ 5.29 GiB، لأن جميع أوزان الخبراء يجب أن تبقى في الذاكرة بالكامل على أي حال. الاستنتاج العملي: البنى الشبيهة بـ MoE تكسب في الوقت، لكنها لا تنقذ ميزانية الذاكرة العشوائية — وعلى الهاتف غالبًا ما يصطدم الحد بالذاكرة تحديدًا.
الأسرع لا يعني الأجود
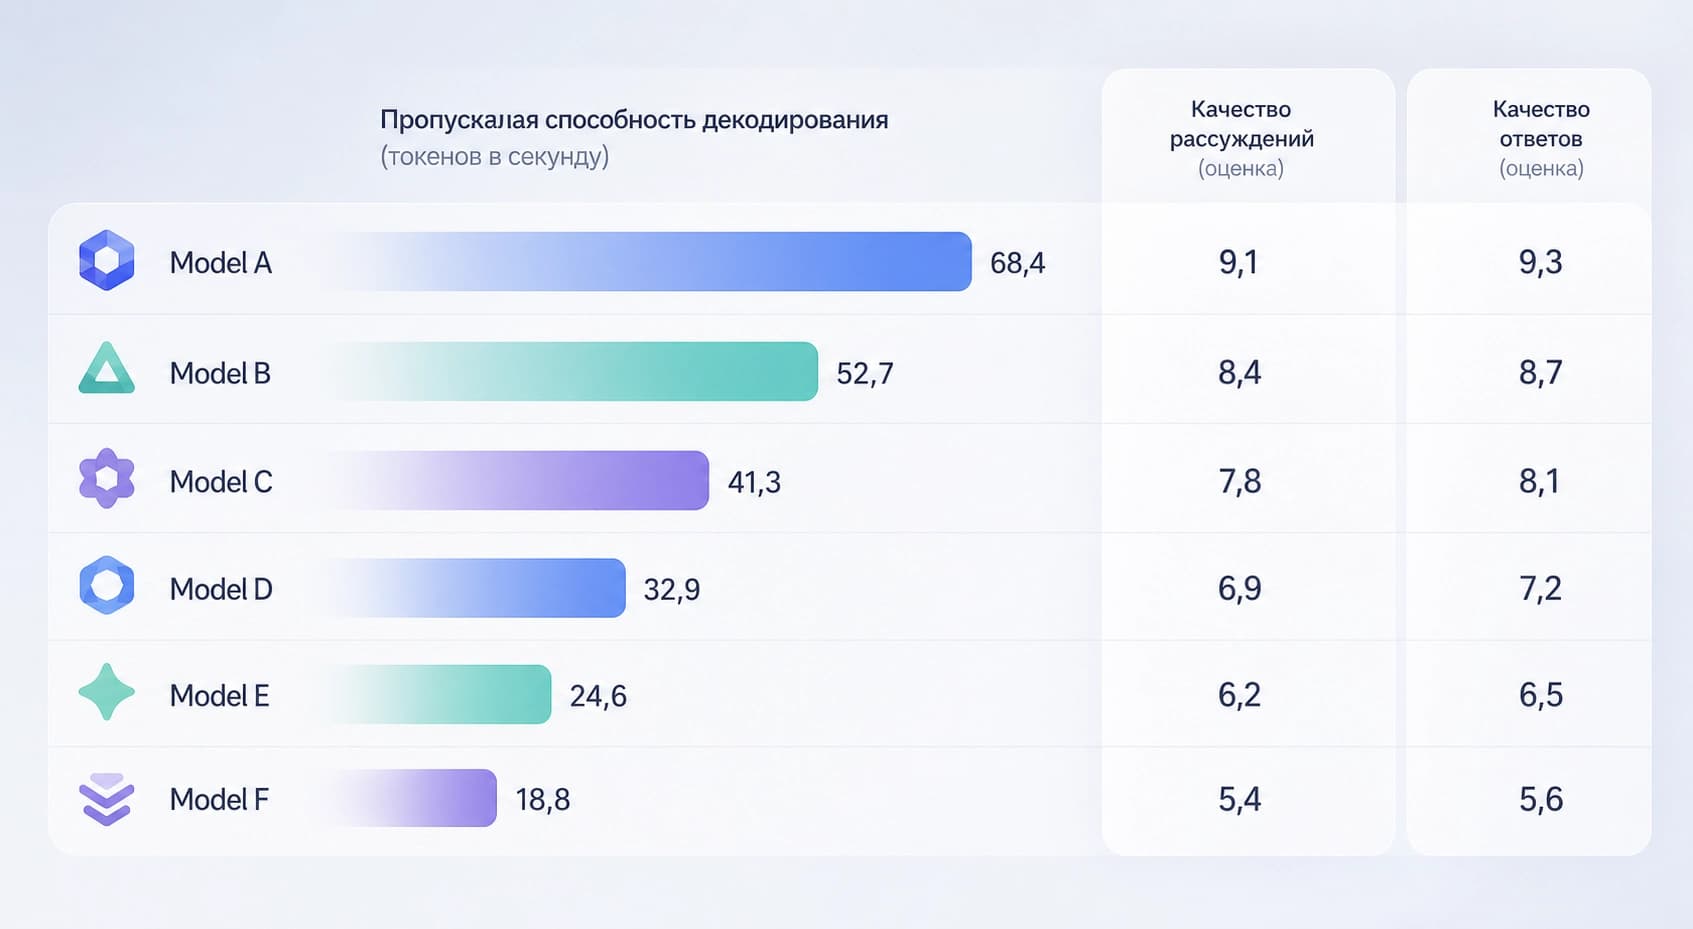
على iPhone 17 Pro عند Q4_K_M ينفّذ MiniCPM5-1B حملًا من 2,048 رمز إدخال / 256 رمز إخراج في 3.47 ثانية، بينما LFM2.5-1.2B-Instruct في 4.12 ثانية، أي أن الأول أسرع بـ 15.8%. غير أن LFM على نفس المخرجات يجمع 9.0 نقطة أكثر على MATH-500. معدل نقل البيانات والجودة محوران مختلفان، واختيار نموذج بناءً على رقم واحد في الجدول بلا معنى.
ملفات النظام شبه المتطابقة قد تخفي انقلابًا في المهام
على M5 Max عند Q4_K_M و2,048 رمز إدخال يختلف Granite-4.1-8B وMinistral-3-8B-Instruct-2512 بنسبة 2.4% فقط في معدل نقل البيانات عند فك الترميز و1.2% في ذروة الذاكرة العشوائية. لكن الصورة تتغير في المهام: يكسب Granite 7.3 نقطة على IFBench، بينما يتقدم عليه Ministral بـ 14.0 نقطة على GPQA Diamond. الفرق في الملف «العتادي» ضمن حدود الضجيج، أما الفرق في السلوك فجوهري.
كيف تُنظَّم القياسات
تُبنى عمليات تشغيل الأداء على أشكال ثابتة من الرموز، وفك ترميز جشع، وتسخين يُهمَل، وخمس تكرارات مقيسة. قبل كل تكرار يُفعَّل readiness gating: تحقق خاص بالمنصة يتأكد من أن الظروف الحرارية والحمل في الخلفية مطابقان للمعيار. عمليات التشغيل الفاشلة لا تدخل في النشر — وهذا بالضبط ما يميز معيارًا قابلًا لإعادة الإنتاج عن سكربت لمرة واحدة.
هناك قصة منفصلة — الجودة. فهي لا تُقاس بنفس عملية التشغيل: لهذا تُستخدم IFBench وGPQA Diamond وMATH-500، وتُؤخذ التقييمات من عمليات تشغيل تقييم llama.cpp على أنظمة مرجعية مزوّدة بـ NVIDIA H100 80GB. ثم تُقارَن بعمليات التشغيل على الجهاز لنفس النموذج ونفس الترميز الكمي. نتيجة مهمة: رقم الجودة الموضوع بجانب معدل نقل بيانات الهاتف لم يُحصل عليه على الهاتف. إنه مقياس ملائم لمقارنة النماذج ببعضها، لكنه ليس قياسًا لما يحدث على هاتف ذكي محدد.
ما الذي يُتاح تحديدًا في المصدر المفتوح
يُقدَّم Pipette بالكامل، دون قائمة انتظار:
- البنية التحتية تحت Apache 2.0 — مستودعات pipette-mgmt وpipette-clients وpipette-scores؛
- مجموعة بيانات عامة للنتائج؛
- لوحة تحكم مستضافة؛
- تطبيقات أصلية للتقييم على iOS وAndroid.
الجزء الوحيد الذي لم يعد جاهزًا للوصول العام هو نشر النتائج المرسلة من المجتمع: إنه في مرحلة تجريبية. وكل ما تبقى يمكن تشغيله بنفسك، بما في ذلك نشر خط المعالجة داخل محيطك الخاص.
لمن هذا ولماذا
أبسط وصف للجمهور المستهدف هو: أي فريق يُطلق نموذجًا على عتاد لا يملكه بنفسه. بعد ذلك تتباين الخيارات حسب الحجم.
- يكفي المطوّر الفرد والشركة الناشئة في مرحلة التمويل الأولي استخدام لوحة التحكم والتطبيقات المحمولة — دون حاجة إلى بنية تحتية خاصة.
- يمكن لفريق منتج متوسط الحجم نشر العملاء على أسطول أجهزة داخلي والحصول على قياسات على تكوينه الخاص.
- أما الشركات المصنّعة الكبرى ومصنّعو الشرائح والمؤسسات فيمكنهم إبقاء خط المعالجة بالكامل خلف جدار الحماية — ما يزيل الأسئلة حول إلى أين تذهب بيانات القياسات.
المهام النموذجية واضحة أيضًا دون شرح زائد: اختيار النموذج وصيغة الترميز الكمي قبل تثبيت مهام السبرنت؛ تبرير شراء SoC أو العتاد؛ التقاط الانحدار عند تحديث بيئة التشغيل أو نظام التشغيل أو برنامج التشغيل؛ تخطيط السعة حسب طول السياق؛ التحقق بشكل مستقل من الوعود الإعلانية للمورّدين. أما القطاعات فهي الإلكترونيات الاستهلاكية ومصنّعو الهواتف الذكية، والمجال السياراتي، والصناعة والروبوتات، والأجهزة الطبية، والخدمات المالية، والدفاع: في كل مكان تفرض فيه الكمونية أو الخصوصية أو انعدام الاتصال إجراء الحساب على الجهاز مباشرة.
ما الذي يجب النظر إليه قبل الوثوق بالأرقام
ثلاثة أمور يسهل نسيانها عند قراءة أي جدول من القياسات.
أولًا، أرقام الجودة وأرقام الأداء تأتي من أماكن مختلفة. معدل نقل البيانات مقيس على الجهاز، والجودة على نظام مرجعي مزوّد بـ H100 ثم تُقارَن. هذا صحيح لمقارنة النماذج، لكنه ليس كذلك للتنبؤ بالسلوك في تطبيق محدد.
ثانيًا، لا يمكن استثناء الترميز الكمي من الحساب. فالصيغة نفسها تعطي نتيجة مختلفة على نماذج مختلفة وبيئات تشغيل مختلفة، وغالبًا ما يصبح قيد الذاكرة حاسمًا — كما في مثال التنشيط المتناثر، حيث ارتفعت السرعة ولم تختفِ الـ 5.29 GiB.
ثالثًا، الأداء المتطابق لا يقول شيئًا عن كيفية أداء النماذج لمهام محددة. انقلاب Granite وMinistral على IFBench وGPQA Diamond عند ملفات نظام شبه متطابقة — هو بالضبط الحالة التي يجب فيها أولًا تحديد المهمة، وبعدها فقط النظر إلى الجداول.


