
يتسابق الأرنب خلف النمر: الاختبار الذي كشف النقطة العمياء
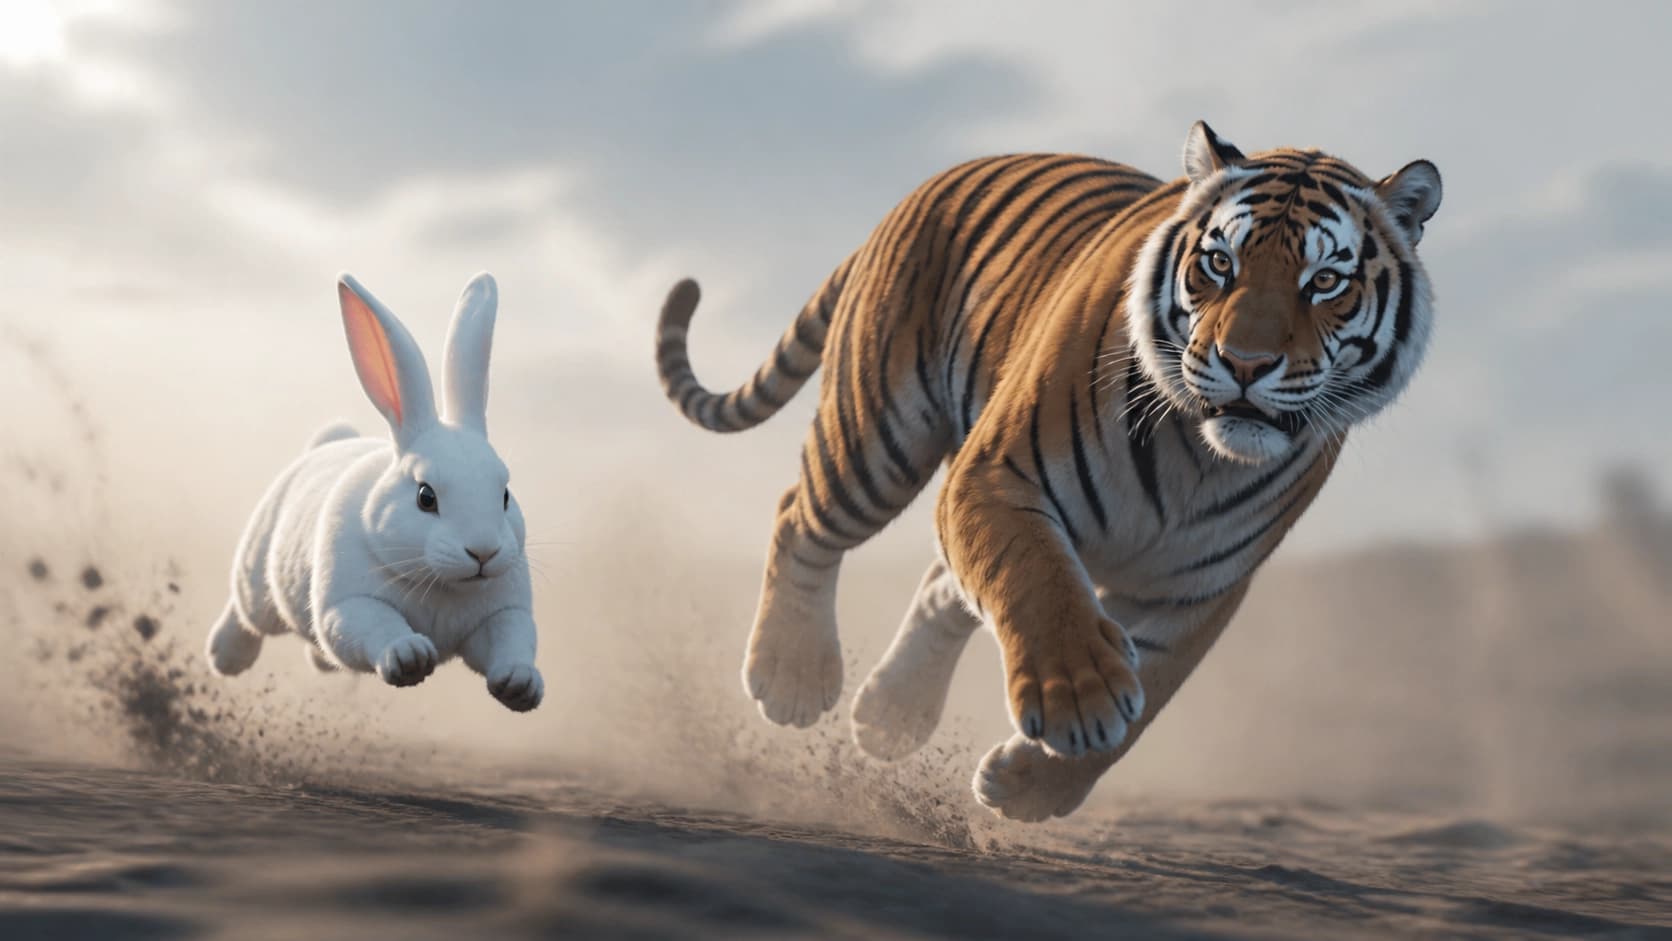
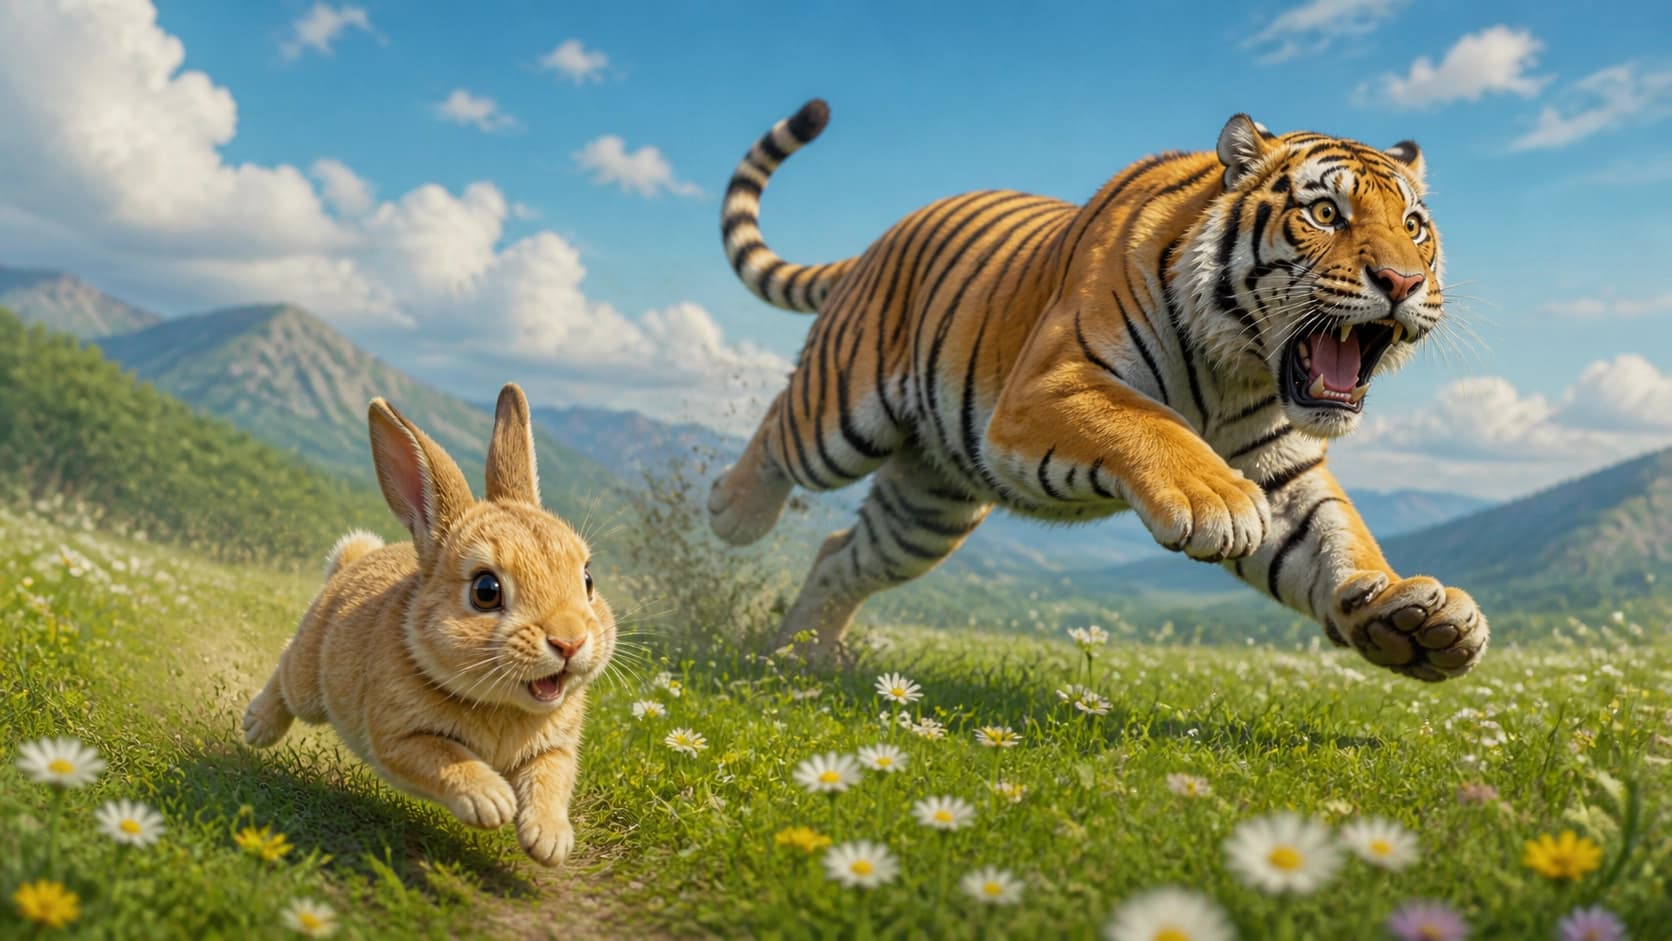
تخيّل المشهد: أرنب يعدو في مرج، وأمامه نمر يهرب. التكوين متقن، والتفاصيل مرسومة بدقة، ولا يوجد أي غموض — فبصريًا كل شيء واضح لا لبس فيه. ومع ذلك، تصف نسبة كبيرة من النماذج متعددة الوسائط مفتوحة المصدر هذا المشهد بالمقلوب. ليس لأنها ترى بشكل سيئ، بل لأنها لا تصدّق ما تراه.
هذه المفارقة بالتحديد هي ما تتناوله دراسة «Seeing vs. Believing: Evaluating the Language Bias of Open-Source MLLMs in Counter-Intuitive Scenes» (arXiv:2601.07737، للمؤلفين Chen Ling وTongwei Zhang وHanqian Li وNai Ding). صدر العمل في يناير 2026، ومنذ ذلك الحين حُدِّث مرتين — آخر مراجعة تعود إلى أغسطس. شكليًا هو مقال في الرؤية الحاسوبية، لكن استنتاجاته أوسع بكثير: فهي تضرب جوهر منطق بنية المساعدات متعددة الوسائط الحديثة.
ما الذي جرى اختباره بالتحديد
منذ زمن طويل تحل النماذج متعددة الوسائط المهام «السائدة» بثقة: وصف صورة فوتوغرافية، إيجاد جسم عبر استعلام نصي، الإجابة عن سؤال بناءً على مخطط. لكن هذه الاختبارات تُبنى دائمًا تقريبًا على مشاهد تتوافق مع التوقعات اليومية. قطة على حافة النافذة، شخص يحمل مظلة تحت المطر، سيارة على الطريق — كل هذا رآه النموذج ملايين المرات في تعليقات مجموعات البيانات.
لكن ماذا يحدث إذا سار العالم البصري ضد الحس السليم؟ لمعرفة ذلك، جمع الفريق معيارًا مرجعيًا CAIT — 400 مشهد اصطناعي عالي التفصيل. كل مشهد يصوّر فعلًا يخالف الصورة المعتادة للعالم: ذلك الأرنب نفسه الذي يطارد النمر هو مثال نموذجي. الصور اصطناعية، أي خاضعة للتحكم: يمكن التأكد من أن الإشارة البصرية موجودة فعلًا وأنها قاطعة.
الفكرة الجوهرية في المنهجية هي أن الإجابة الصحيحة هنا لا يمكن استنتاجها من نص السؤال. لا يمكن الحصول عليها إلا بطريقة واحدة — النظر إلى الصورة وقبول ما هو مرسوم فيها.
البشر والنماذج المغلقة والمفتوحة: فجوة في الأرقام
توزعت النتائج على ثلاثة مستويات مختلفة تمامًا.
- البشر يحلون المهمة بشكل شبه مثالي — دقة نحو 0.95. لا يوجد لدينا شيء صعب في رؤية مشهد غير معتاد وتسجيله فحسب.
- النماذج الاحتكارية — شاركت في الدراسة حلول رائدة، من بينها Claude وGemini — تُظهر فهمًا مستقرًا: تصل الدقة إلى 0.88. ليس مثاليًا، لكن النظام ينظر بوضوح إلى الصورة بدلًا من التخمين.
- النماذج المفتوحة المضبوطة بالتعليمات — 14 ممثلًا نموذجيًا — تنهار إلى مستوى التخمين العشوائي. بعبارة أخرى، إجاباتها لا ترتبط تقريبًا بما هو مرسوم فعليًا.
هذه هي الحبكة الرئيسية: الفجوة بين «نمر» الحلول المغلقة و«أرنب» الحلول المفتوحة تبين أنها ليست تجميلية، بل جوهرية. الحديث ليس عن أن النماذج المفتوحة تتعامل بشكل أسوأ قليلًا مع مهمة صعبة — بل إنها في المشاهد المضادة للحدس تتوقف عن كونها متعددة الوسائط بأي معنى ذي مغزى.
المتهم الرئيسي — الانحياز اللغوي المسبق
يُظهر تحليل الأخطاء آلية الفشل. المشكلة ليست في أن النموذج لم يتبين الأرنب. المشكلة في أنه فضّل ألا يصدّق عينيه.
عندما تتعارض الإشارة البصرية مع إحصاءات النص، يدخل حيز التنفيذ انحياز لغوي مسبق قوي: يستبدل النموذج تلقائيًا الملاحظة الشاذة بالوصف النصي الأكثر شيوعًا. النمر يطارد الأرنب — هذه العبارة تظهر في المدونات النصية باستمرار. الترتيب المعاكس — تقريبًا أبدًا. وعند مفترق الطريق بين «رأيت» و«توقعت»، يختار النظام الثاني.
في جوهر الأمر، لا يمثل المدخل البصري لمثل هذا النموذج سوى تلميح إلى أي عبارة يستدعيها من الذاكرة. إذا أكدت الصورة القالب — فكل شيء على ما يرام. وإذا جادلتْه — ينتصر القالب. ومن هنا الدقة على مستوى رمي العملة: يجيب النموذج بحكم قصور اللغة، لا بمحتوى الصورة.
فخ الاستدلال: «إعادة التفكير» في المشهد
الاقتراح المنطقي هو إضافة سلسلة استدلال (Chain-of-Thought) إلى النموذج. دعه ينطق الخطوات، ويراجع نفسه، ويصل إلى الاستنتاج. هذا ينجح جزئيًا: الدقة ترتفع فعلًا.
لكن للتحسين ثمنًا، والثمن مزدوج.
أولًا، تصبح الإجابة أبطأ بشكل ملحوظ — فالاستدلالات المطولة تتطلب وقتًا وحسابات. ثانيًا — وهذا أكثر إثارة للاهتمام — يظهر نمط فشل جديد. يبدأ النموذج حرفيًا في إعادة التفكير فيما رآه. يبدو وكأنه يسجّل المشهد، ثم يتخلى عنه: هذا لا يحدث، هذا يخالف قوانين الفيزياء في العالم الحقيقي، إذن أنا على الأرجح أخطأت. ونتيجة لذلك، يرفض النظام قبول المحتوى البصري الفعلي تحديدًا لأنه مستحيل.
والنتيجة سخرية عجيبة: أداة صُممت لجعل الاستنتاج أكثر إحكامًا تتحول أحيانًا إلى آلة لكبت الحقائق المزعجة.
ما الذي يساعد: الضبط الدقيق والهندسة المنظمة للأوامر النصية
الخبر السار أن المشكلة ليست قاتلة. يصف المؤلفون مقاربتين تخففان بشكل ملحوظ الاعتماد على الانحيازات اللغوية المسبقة.
- الضبط الدقيق الموجّه. التدريب الإضافي على بيانات مناسبة يقلل الميل إلى استبدال الملاحظة بالقالب ويعيد الثقل إلى القناة البصرية.
- الهندسة المنظمة للأوامر النصية. إذا حُدِّد للنموذج تنسيق إجابة يُلزَم فيه أولًا بتسجيل ما يُلاحظ ثم بتفسيره فقط، ترتفع الدقة دون إعادة تدريب.
في كلتا الحالتين، تبدأ النماذج المفتوحة في تبرير استنتاجها بناءً على أدلة بصرية حقيقية، لا على إحصاءات النص. أي أن الفجوة مع الحلول المغلقة مسألة بنية وتدريب، لا استحالة جوهرية.
ما الذي يترتب على ذلك عمليًا
بالنسبة للمطوّر الذي يبني منتجًا على نموذج متعدد الوسائط مفتوح، الاستنتاجات عملية إلى حد بعيد.
يجدر التذكر أن الإجابة الواثقة لا تعني ما تم رؤيته. حيث يتوافق المشهد مع التوقعات، يُظهر النموذج موثوقية؛ وحيث يختلف، يقدّم بهدوء ودون أن يُلاحظ اختلاقًا معقولًا. الأخطر أن الخطأ لا يبدو خطأً: فالوصف يخرج سلسًا ومنطقيًا وخاطئًا تمامًا.
وينبغي أيضًا التعامل مع الاستدلال كأداة لها آثار جانبية. لا تساعد سلسلة الاستدلال دائمًا ولا في كل المهام — أحيانًا تحوّل النموذج إلى متشكك يرفض استنتاجه الصحيح.
وأخيرًا، الأهم. «الأرنب يطارد النمر» ليس طرفة، بل اختبار خالص لما يثق به النموذج فعليًا. وطالما أن الإجابة عن هذا السؤال ليست في صالح الصورة، فلا يمكن تسمية النظام متعدد الوسائط إلا بشكل مشروط.


