
الإجابة النهائية كمقياس وحيد — وما الذي تخفيه
معظم معايير تقييم نماذج اللغة مبنية على غرار الاختبار المدرسي: هناك سؤال، وهناك إجابة مرجعية، وهناك تحقق من التطابق. حساب هذا المقياس مريح، ومقارنة النماذج كذلك. لكن في هذا التصميم عيبًا متأصلًا: فهو يقيّم النتيجة، لا الطريق إليها.
تخيّل مهمة تتطلب الربط بين أربع حقائق. يتشوّش النموذج عند الثانية، ويخمّن عشوائيًا عند الرابعة — فيحصل على الدرجة. أو العكس: ثلاث حلقات بُنيت بإتقان، لكن الإجابة الأخيرة اختلفت بصياغة واحدة — فلا درجة. في كلتا الحالتين، الرقم النهائي يكذب بشأن ما جرى فعلًا في الداخل. وهذا مؤلم بشكل خاص في الأسئلة متعددة الخطوات: فهي لا تختبر مهارة واحدة، بل تسلسلها — العثور على المعلومات، والإمساك بها، وربطها بما يليها، وعدم فقدانها في الطريق.
تشخيص «أين انكسر الأمر بالضبط» ليس ترفًا أكاديميًا. فعليه يتوقف ما يجب إصلاحه: مجموعة البيانات، أم استراتيجية التدريب، أم صياغة التوجيه. والدقة النهائية لا تستطيع الإجابة عن هذا السؤال بحكم تعريفها.
ما هو Omanic
هذه المنطقة العمياء تحديدًا يسدّها العمل «Omanic: Towards Step-wise Evaluation of Multi-hop Reasoning in Large Language Models» (arXiv:2603.16654، يندرج ضمن قسم cs.CL، ومصنّف أيضًا ضمن cs.AI وcs.LG، ومقبول في EMNLP 2026 Findings). فريق المؤلفين واسع ومتعدد الجنسيات: Xiaojie Gu، وSherry T. Tong، وAosong Feng، وSophia Simeng Han، وJinghui Lu، وYingjian Chen، وYusuke Iwasawa، وYutaka Matsuo، وChanjun Park، وRex Ying، وIrene Li. نُشرت النسخة الأولى في 17 مارس 2026، ثم تلتها مراجعتان — في مايو وفي أغسطس.
Omanic هو معيار تقييم مفتوح النطاق من أربع خطوات استدلالية. كلمة «مفتوح النطاق» هنا أساسية: النموذج لا يختار خيارًا من قائمة جاهزة، ولا يبحث في مستند واحد مُعدّ مسبقًا. بل عليه أن يجد المعلومات بنفسه، ثم يبني منها سلسلة. هذا الطرح أقرب إلى السيناريوهات الواقعية، حيث لا تكاد الإجابة توجد في فقرة واحدة.
مجموعتان بدلًا من واحدة
داخل Omanic توجد مجموعتان مختلفتان من البيانات، ولا ينبغي الخلط بينهما.
الأولى — OmanicSynth، وتضم 10,296 مثالًا مُولّدًا آليًا. وهي مادة تدريبية: يمكن استخدامها كإشراف، وعليها تحديدًا اختبر المؤلفون ما إذا كانت القدرة على الاستدلال خطوة بخطوة قابلة للنقل.
الثانية — OmanicBench، وتضم 967 مثالًا خضعت لمراجعة الخبراء ومزوّدة بتعليقات يدوية. وهي الجزء التقييمي، وهي أصغر بكثير — وهو منطقي، لأن التعليق البشري على مستوى الخطوات مكلف.
هذا الفصل ليس شكليًا. فهو يسمح بالفصل بين «النموذج دُرّب» و«النموذج يمتلك المهارة فعلًا»: مجموعة التدريب كبيرة وآلية، ومجموعة التحقق مدمجة ومُحكمة.
كيف يعمل التعليق خطوة بخطوة
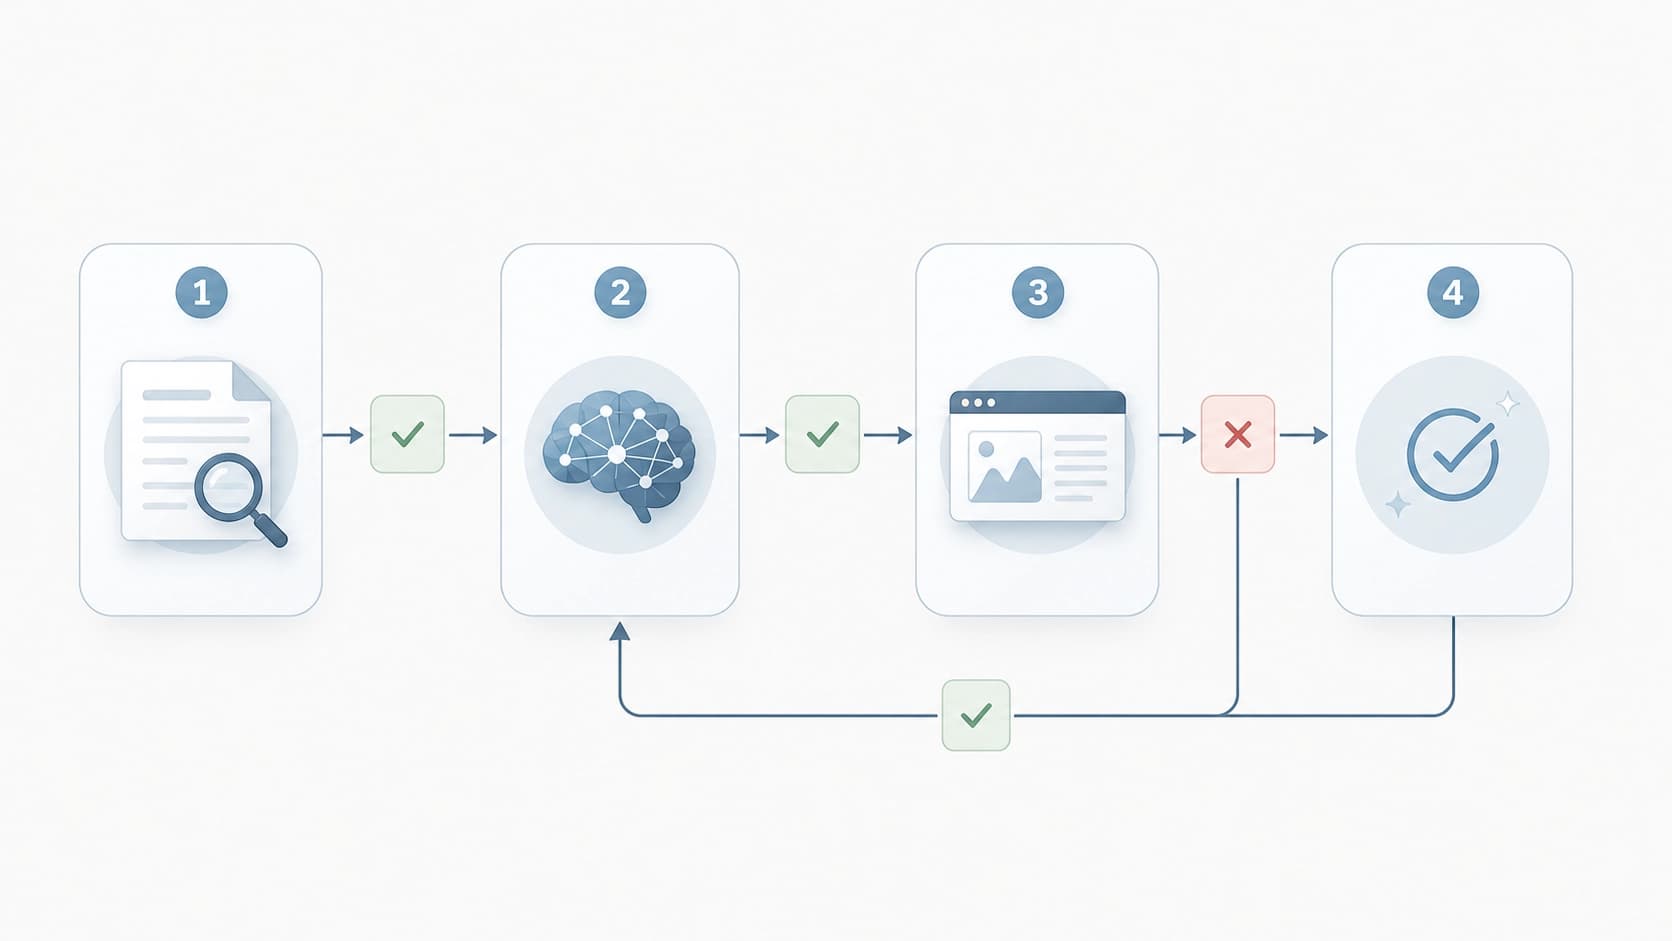
الفرق الجوهري بين Omanic ومجموعات الأسئلة والأجوبة المعتادة هو أن كل سؤال مُفكَّك إلى مكوناته. أسئلة فرعية أحادية الخطوة، وإجابات وسيطة، وطوبولوجيات رسومية مُهيكلة — أي مخطط يوضّح كيف ترتبط الحقائق ببعضها.
وهذا يحوّل التقييم من نقطة واحدة إلى مجموعة نقاط تحقق. الآن يمكن النظر ليس فقط إلى «هل أجاب النموذج بشكل صحيح أم لا»، بل إلى «عند أي انتقال بالتحديد تعثّر». والبنية الرسومية مهمة هنا أيضًا لأن أنواع الروابط المختلفة يجدها النماذج بسهولة متفاوتة: استخراج خاصية كائن أمر، وتتبّع سلسلة من أربع تبعيات متتالية أمر آخر تمامًا.
ثلاثة تشخيصات لا تظهر إلا على مستوى الخطوات
أسفرت التجارب على النماذج المغلقة والمفتوحة عن ثلاث ملاحظات لا يستطيع المقياس النهائي إظهارها ببساطة.
عنق الزجاجة في الخطوات المتأخرة
الاستنتاج الأول يسميه المؤلفون later-hop bottleneck. والحديث عن أن الخسائر الأساسية تتراكم ليس في البداية، بل قرب نهاية السلسلة. الانتقال الأول والثاني يجتازهما النموذج بثقة نسبية، أما عند الثالث والرابع فيبدأ في الانهيار.
التفسير يفرض نفسه: كلما طالت السلسلة، زاد عدد الكيانات الوسيطة التي يجب الإمساك بها في آن واحد. في الخطوات المتأخرة، على النموذج أن يتعامل لا مع السؤال الأصلي، بل مع نتائج استنتاجاته السابقة — وأي عدم دقة هناك تتضاعف. والاستنتاج العملي مزعج لمن يحب بناء خطوط أنابيب طويلة متعددة المراحل: إضافة خطوة خامسة وسادسة قد تكلف أكثر مما يبدو.
«أرضية» المعرفة الواقعية
الظاهرة الثانية — factual knowledge floor، أي «أرضية» المعرفة الواقعية. بعض الأخطاء لا علاقة لها بالمنطق أصلًا: النموذج ببساطة لا يمتلك الحقيقة المطلوبة، وبدلًا من التوقف بصدق، يواصل بناء الاستدلال على فراغ.
هذا تمييز مهم. عندما يخطئ النموذج في الاستنتاج — فالمشكلة في الاستدلال. وعندما لا يعرف الحقيقة الأساسية — فالمشكلة في البيانات، وفي ما إذا كان يعرف الاعتراف بجهله. والثاني علاجه صعب: لا الاستدلال خطوة بخطوة ولا التوجيه الأذكى سيساعدان إن لم يكن هناك سند تحت الحلقة الأولى أصلًا.
خطأ ينتقل عبر السلسلة
التشخيص الثالث — انتشار الأخطاء على طول السلسلة. عدم الدقة المبكر لا يبقى محليًا: تلتقطه الخطوات التالية ويتحول إلى إجابة نهائية واثقة، مصاغة بسلاسة، لكنها خاطئة.
هنا يكمن فخ في التقييم. النموذج الذي أخطأ مرة واحدة ثم استمر في الاستدلال بشكل متسق، والنموذج الذي انهار في كل الخطوات، يبدوان متطابقين في المقياس النهائي — كلاهما لم يصب. والتحليل خطوة بخطوة يميّز بينهما، وهذه بالضبط الحالة التي يكون فيها التشخيص أثمن من الدرجة النهائية.
نقل التعلّم: 7.41 نقطة على ستة معايير
سؤال منفصل — هل يمكن استخدام هذا التعليق ليس للقياس فقط، بل للتدريب أيضًا. تحقق المؤلفون من ذلك: أعطى التدريب الإضافي على OmanicSynth تحسنًا على ستة معايير خارجية مخصصة للاستدلال والرياضيات، بمتوسط زيادة 7.41 نقطة.
رقم ينبغي قراءته بشكل صحيح. هذا ليس «النموذج أصبح أذكى في كل شيء» — بل «المهارة المُدرَّبة على سلاسل مُفكَّكة تنتقل إلى مهام أخرى من النوع نفسه». وهذا بحد ذاته يقول شيئًا عن طبيعة المعيار: فهو ليس عن حفظ أسئلة محددة، بل عن تدريب الإجراء — كيف تُقسَّم المهمة إلى خطوات وكيف تُحفظ الصلة بينها.
ماذا يعني هذا عمليًا
عدة استنتاجات تفرض نفسها مما سبق.
قيّم بالخطوات، لا بالنتيجة. إذا كان نظامك يبني إجابات متعددة الخطوات، فمقياس نهائي واحد لا يكفي — فهو يدمج أعطالًا مختلفة في طبيعتها في رقم واحد غامض.
افصل بين «لا أعرف» و«استنتجت خطأً». هذان عيبان مختلفان بطرق علاج مختلفة، لكنهما يندمجان في التقارير المعتادة.
كن حذرًا مع السلاسل الطويلة. الخطوات المتأخرة هي أكثر نقطة هشاشة. أحيانًا يكون من الحكمة تقسيم المهمة إلى عدة مهام فرعية مستقلة بدلًا من جرّ سلسلة طويلة واحدة حتى النهاية.
التفكيك هو أيضًا إشارة تدريبية. النتيجة مع النقل إلى ست مجموعات خارجية تُظهر أن التعليق خطوة بخطوة يعمل ليس كمسطرة فقط، بل كمادة للتدريب أيضًا.
ما ليس Omanic
من المفيد تحديد الحدود. Omanic ليس تقييمًا شاملًا لذكاء النموذج، ولا اختبارًا لكل شيء دفعة واحدة. إنه أداة لمهمة محددة: إظهار عند أي حلقة من الاستدلال يحدث الخلل في الأسئلة متعددة الخطوات مفتوحة النطاق.
حجم الجزء التقييمي — 967 مثالًا — ينبغي أيضًا أخذه في الحسبان: المجموعة مُحكمة، لكنها ليست ضخمة. أما جزء التدريب فأكبر بمرتبة من حيث الحجم ومُولّد آليًا، ما يمنح حجمًا لكنه لا يغني عن المراجعة اليدوية.
والأهم: التشخيص بحد ذاته لا يعالج شيئًا. معرفة أن النموذج يتعثر في الخطوات المتأخرة هي نقطة انطلاق، لا حل. بعدها يبدأ العمل المعتاد: أين تُضاف بيانات، وأين تُبسَّط السلسلة، وأين يُدرَّب النموذج على التوقف وقول «لا أعرف هذا».
نشر المؤلفون البيانات والكود في متناول الجميع؛ والعمل متاح عبر DOI 10.48550/arXiv.2603.16654.


