لماذا يصل RAG الوكيلي إلى مفترق طرق
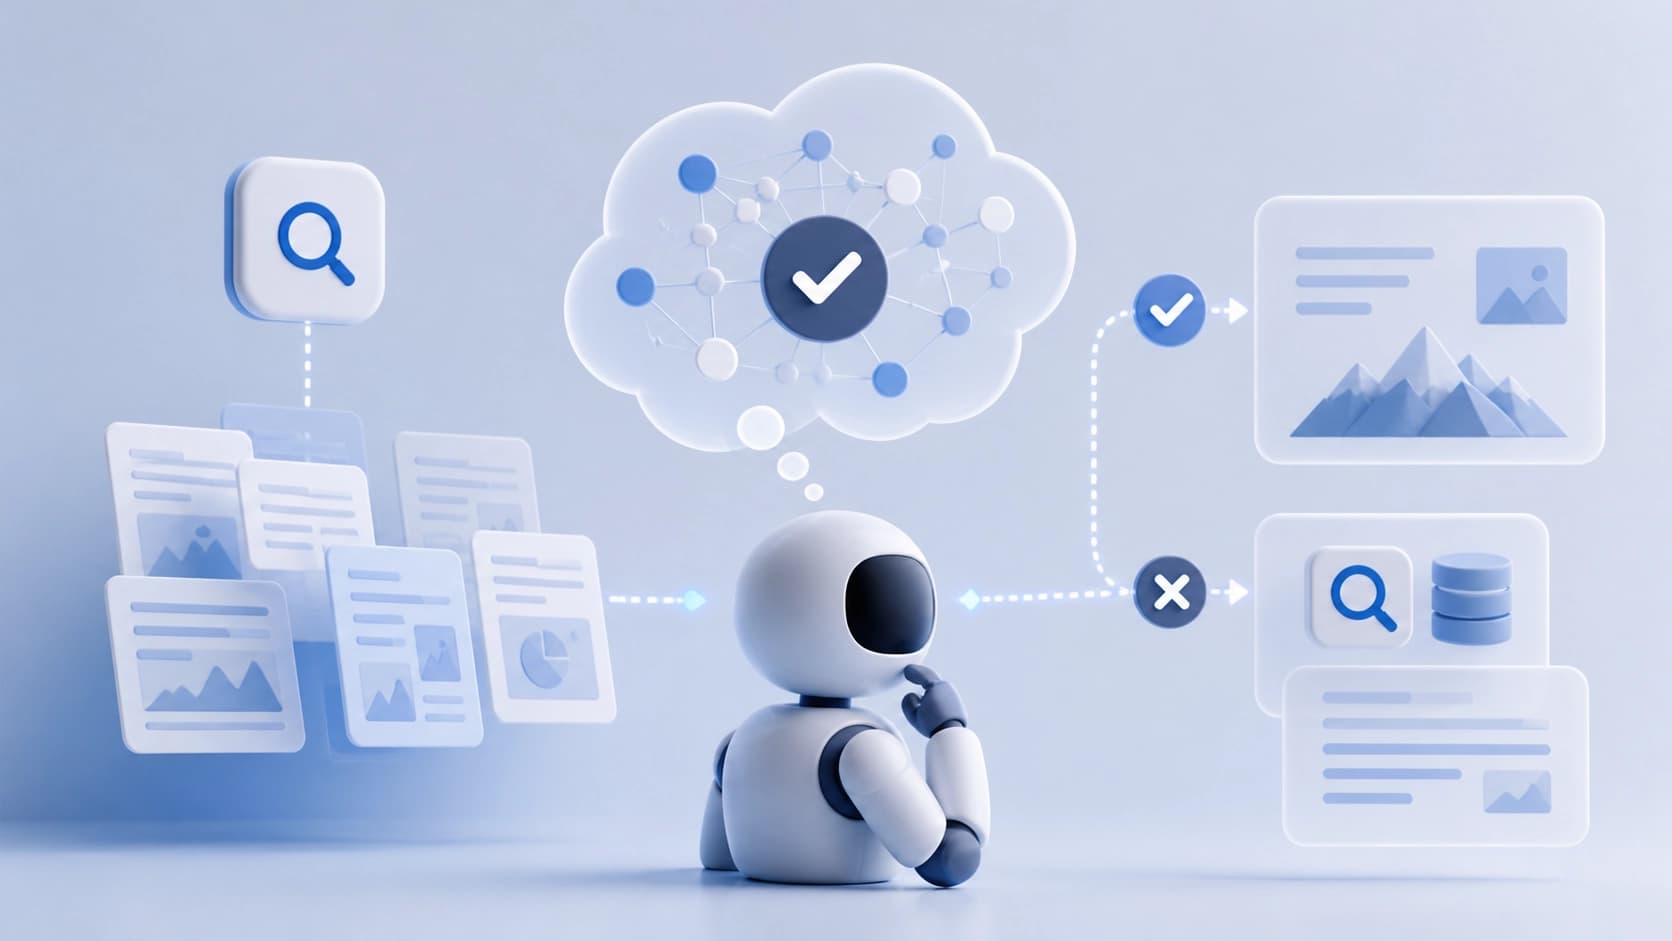
يُبنى RAG الوكيلي كحلقة: يقرأ النموذج السؤال، ويقرر ما إذا كان يحتاج إلى استعلام بحث آخر، ويتلقى النتائج، ثم يختار مجددًا — هل يواصل البحث أم يجيب الآن. كل تكرار زائد يكلّف مالًا ووقتًا، وكل تكرار مُغفَل يهدد بإجابة ناقصة. وهكذا يتبين أن المهارة الأساسية للوكيل ليست استخراج المستندات، بل القدرة على قول «الأدلة كافية» في الوقت المناسب.
يقيّم التعلم المعزز الكلاسيكي هذا السلوك من الخارج: تطابق الجواب مع المرجع — إشارة موجبة، وعدم تطابقه — إشارة سالبة. لكن لا أحد يسأل عما تفكر فيه النموذج نفسه بشأن اكتمال المادة التي جُمعت. ومن هنا تنشأ علّتان متناظرتان: فإما تواصل السياسة الحفر عندما يكون كل شيء واضحًا في الداخل، وإما تقطع البحث رغم أن البيانات قليلة بوضوح. والمكافأة الخارجية لا تميّز بين هاتين الحالتين — فالنتيجة واحدة، لكن السلوك مختلف.
تحوّل في صياغة المسألة
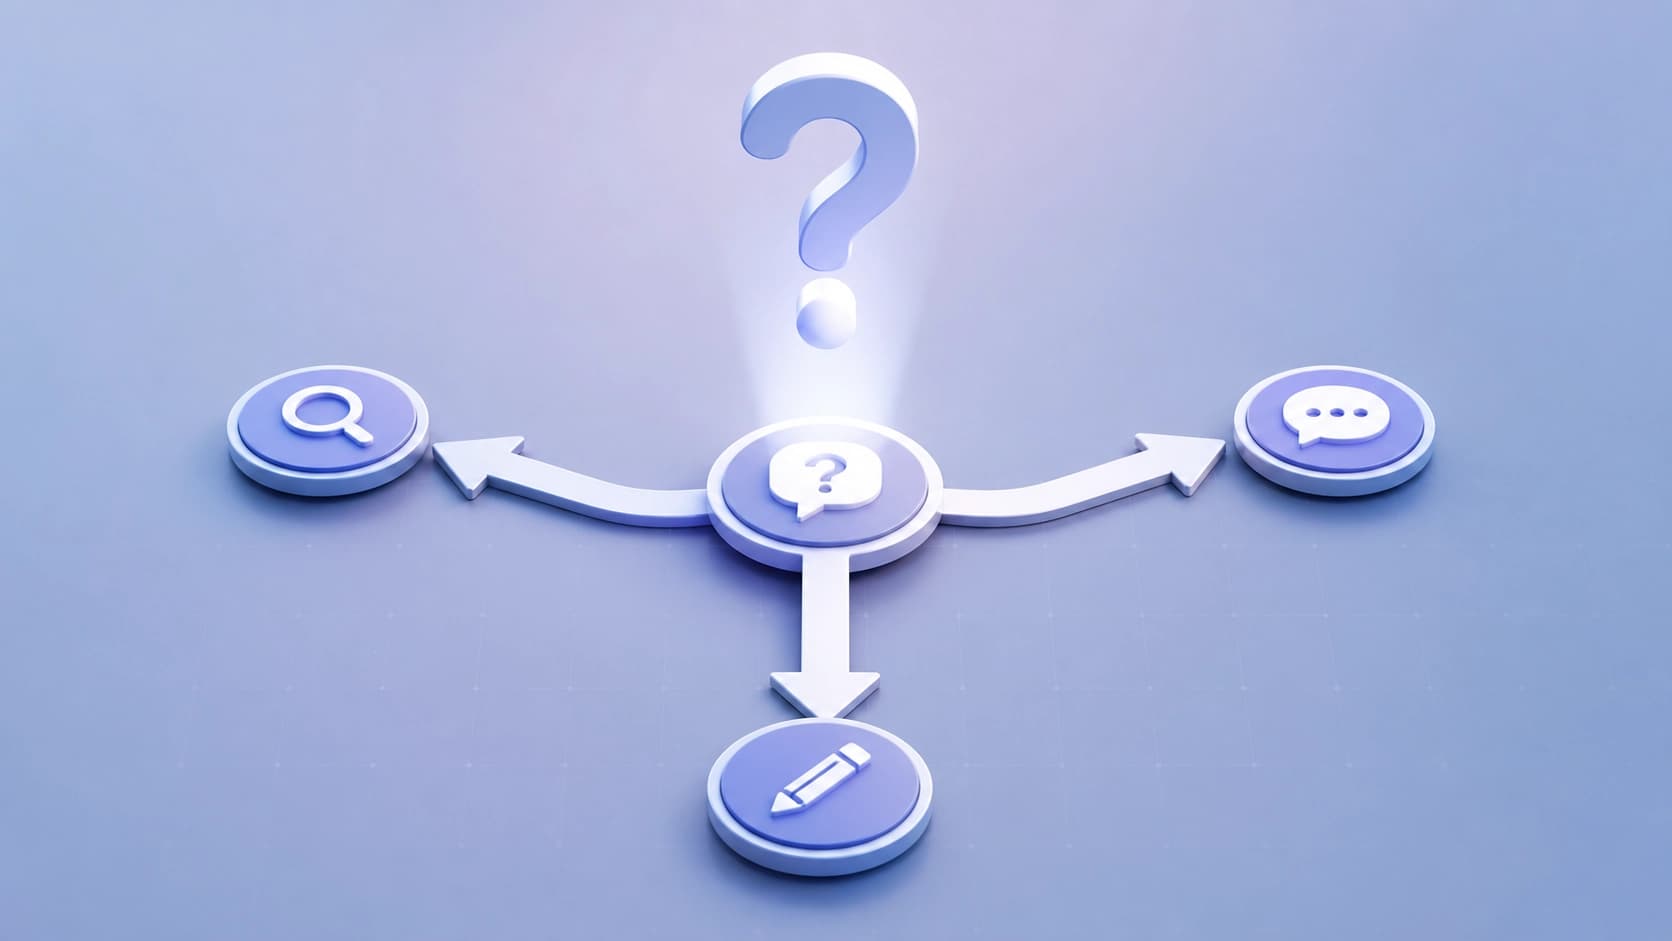
يقترح مؤلفو عمل MetaRAG ألا ننظر إلى الفعل فحسب، بل أيضًا إلى مدى تطابقه مع قناعة الوكيل الداخلية بكفاية الأدلة. ويسمّون هذه الصياغة مواءمة القناعات والأفعال — belief-action alignment. والفكرة بسيطة: جودة قرار البحث ليست مقياسًا منفصلًا فوق الإجابة، بل اتساق بين ما «يفكر» فيه النموذج وما يفعله.
كيف يعمل MetaRAG
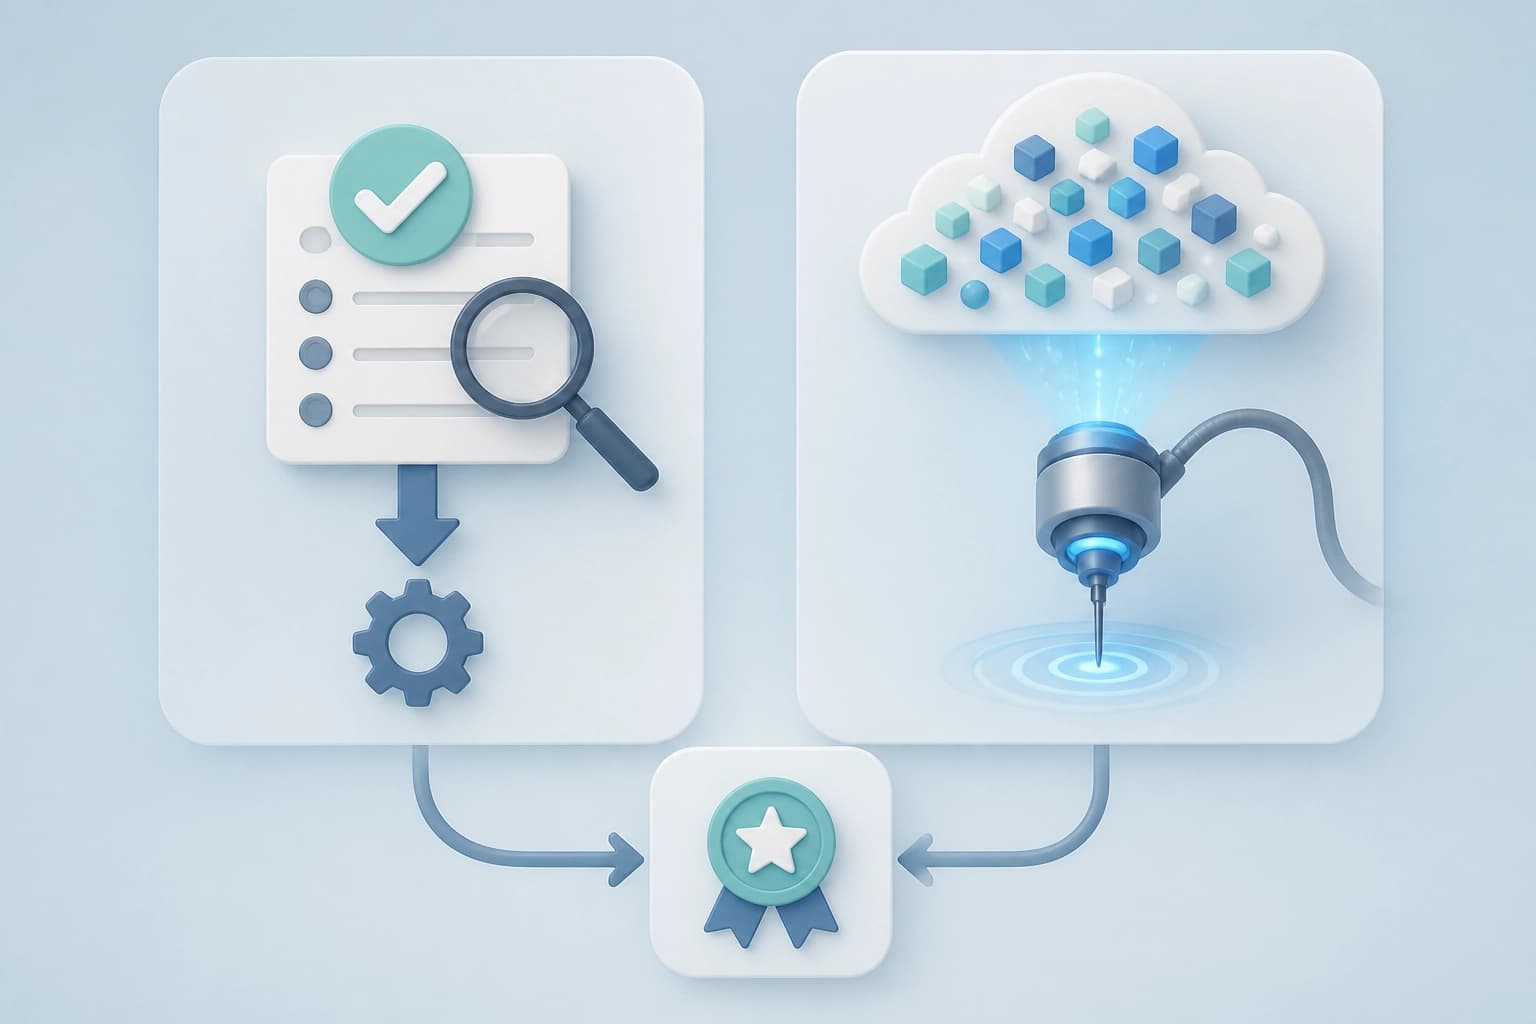
يتكوّن الإطار من ثلاثة أجزاء: تحقق صريح قبل الفعل، ومسبار للقناعة الداخلية، ومكافأة خاصة تربط أحدهما بالآخر.
التحقق قبل الفعل
المكوّن الأول هو Verify-first Action Generation. فبدلًا من إصدار الخطوة التالية مباشرة، تمرّر السياسة الفعل أولًا عبر إجراء تحقق صريح: هل يناسب هذا الفعل حالة البحث الراهنة. والفكرة هي استبعاد القرارات المتهورة قبل أن تدخل في المسار. وهو في جوهره «تجميد للحظة» مدمج في التوليد، وهو ما يفتقر إليه عادةً الوكلاء السريعون.
مسبار القناعة الداخلية
المكوّن الثاني هو Internal Belief Probing. فمن السياق نفسه الذي تراه السياسة (السؤال مضافًا إليه تاريخ الأفعال والملاحظات)، يُقرأ على حدة رأيها الخاص: هل نجيب على السؤال الآن. والمهم أنه ليس نموذجًا خارجيًا حكمًا ولا وسمًا بشريًا — بل تُؤخذ الإشارة من السياسة نفسها، لكن بطريقة مختلفة في الصياغة.
مكافأة الاتساق مع صمام أمان
من هاتين الإشارتين تُشتق consistency reward: يُكافأ الوكيل عندما يتطابق فعله مع تقييمه الداخلي لكفاية الأدلة. وهنا فخ واضح — إذ يمكن أن نبدأ بمكافأة سلوك «خاطئ بثقة»، إذا كان النموذج يخطئ بتماسك واتساق. ويغلق المؤلفون هذا الفخ ببوابة: لا تُحتسب مكافأة الاتساق إلا عندما تكون الإجابة صحيحة. وبعبارة أخرى، الاتساق ليس غاية في ذاته، بل مضاعف للصحة.
وثمة تفصيل منفصل مهم للممارسين: مسبار القناعة يعمل فقط في مرحلة التدريب. فلا يُستدعى عند الاستدلال، وبالتالي لا تظهر حسابات إضافية مع كل طلب — وتبقى التكاليف الإضافية صفرًا.
ما أظهرته التجارب
اختُبر العمل على سبعة معايير عامة للأسئلة والأجوبة. والنتيجة المعلنة هي تحسّن مستقر في المقايضة بين الدقة والكفاءة مقارنةً بأساليب RL الأساسية القوية لـ RAG الوكيلي. أي أن المكسب ليس في مجرد الإجابة بدقة أكبر، بل في عدم دفع ثمن ذلك عبر بحث لا ينتهي.
ثم اختبر المؤلفون مدى قابلية الأثر للانتقال: إلى سيناريو البحث العميق (deep research)، وإلى محسّنات مختلفة، وإلى نماذج أساسية مختلفة. وفي كل هذه التهيئات، يحافظ الأسلوب — وفق بياناتهم — على تفوقه. وهذا بالضبط نوع التحقق الذي كثيرًا ما يغيب: فمن السهل الخلط بين تحسّن على نموذج واحد ومجموعة بيانات واحدة وبين ضبط уда удачный للمعاملات الفائقة.
ماذا يعني هذا عمليًا
يرشد MetaRAG مطوّري أنظمة البحث الوكيلية إلى اتجاه أرخص مما يبدو. فإذا كان لديك بالفعل تدريب للسياسة، فإن إضافة إشارة عن القناعة الداخلية لا تتطلب موسّمين جددًا: فالسياق نفسه الذي تراه السياسة أصلًا يمكن استخدامه مصدرًا للإشارة. لكن بوابة الصحة ضرورية هنا — فبدونها قد يتعلم الوكيل أن يخطئ بشكل جميل وواثق.
والاستنتاج الثاني يتعلق بتصميم المكافأة عمومًا. فالمقاييس الخارجية تجيب عن سؤال «هل نجح الأمر»، لكنها لا تقول شيئًا تقريبًا عن «هل كان الوكيل متزنًا في اللحظة». والتمييز بين هذين الأمرين هو الفكرة الأساسية للورقة: الاتساق بين القناعة والفعل كائن مستقل قابل للتحسين على حدة، وليس أثرًا جانبيًا لنمو الدقة.
ومع ذلك، يجدر إبقاء الحدود في الذهن: فالتجارب محصورة في معايير QA وسيناريوهات البحث العميق، والأسلوب نفسه مبني فوق تدريب RL، أي أنه غير قابل للتطبيق «من الصندوق» على أنظمة لا تُدرَّب فيها السياسة أصلًا. وفي مثل هذه الحالات تكون الفكرة نفسها أنفع — التحقق الصريح من الفعل قبل تنفيذه، وتقييم منفصل لما إذا كان القرار يتطابق مع الإحساس الداخلي بكفاية البيانات.
النص الكامل متاح على arXiv:2608.24214 (v1، 25 أغسطس 2026، قسم cs.AI) — وقد قُبل العمل في البرنامج الرئيسي لمؤتمر EMNLP 2026.