
MAPLE: نقل ميزانية الخبراء الموجَّهين بين طبقات نموذج MoE دون تعديل الأوزان
تُظهر الدراسة أن العدد الموحّد للخبراء الموجَّهين عبر جميع الطبقات يخسر بشكل منهجي أمام التوزيع غير المتكافئ، وتقترح آلية قابلة للتوصيل تعتمد على تقييم حساسية الطبقات. وعلى أربع نماذج MoE، يتفوق هذا النهج عند ميزانية خبراء تبلغ 75% على كلٍّ من المخطط الموحّد وتقليص الخبراء، كما يقلل زمن استجابة الخدمة في SGLang بنسبة 32.2% ويرفع معدل النقل بنسبة 47.4%.
مشكلة الميزانية الموحّدة للخبراء
تثبّت محوّلات MoE ذات التنشيط المتناثر عددًا موحّدًا من الخبراء الموجَّهين في جميع الطبقات. وهذا يتجاهل التفاوت الموثّق في التكرار بين الطبقات.
MAPLE هو إطار عمل جاهز للاستخدام الفوري. يعيد توزيع ميزانية الخبراء الموجَّهين بين طبقات أي نموذج MoE LLM مُدرَّب مسبقًا. لا تغيّر الطريقة الأوزان ولا تتطلب إعادة تدريب.
الخصائص الرئيسية:
- توزيع غير متجانس للميزانية عبر الطبقات.
- عدم تعديل أوزان النموذج.
- عدم إعادة التدريب.
- قابلية التطبيق على نموذج MoE LLM مُدرَّب مسبقًا.
المعيار العملي: تكون الحاجة إلى هذا النهج عندما يُراد تغيير توزيع الخبراء دون تعديل الأوزان أو إعادة التدريب.
حساسية الطبقات والصيغة المغلقة
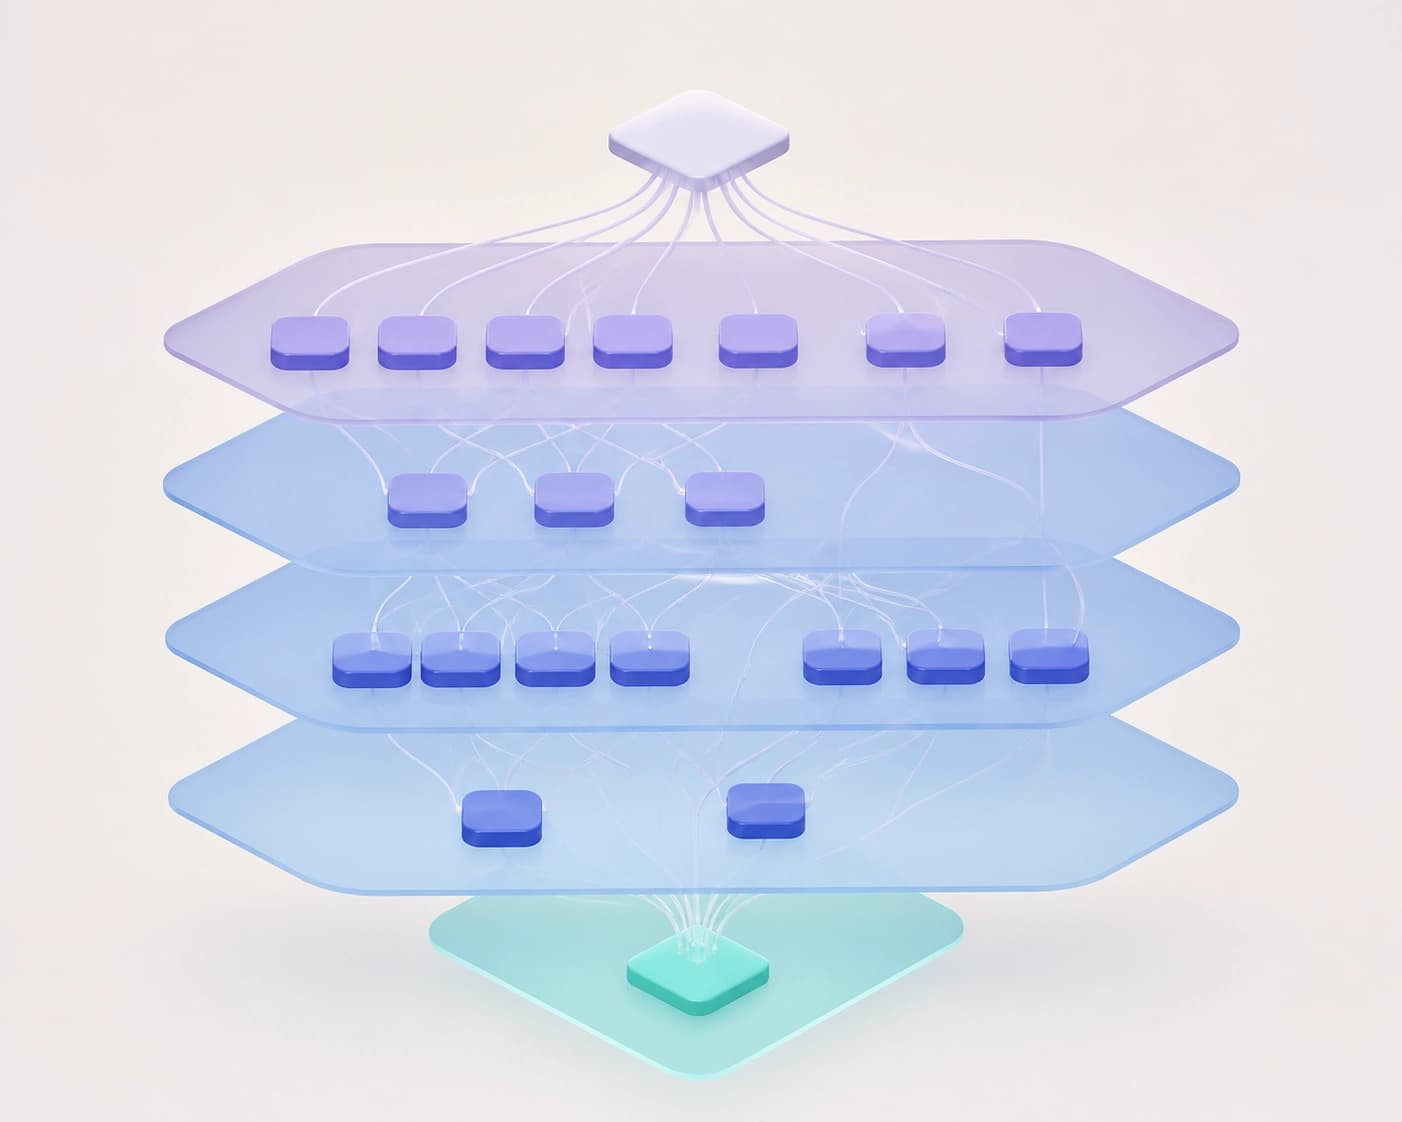
يستكشف MAPLE كل طبقة. تفحص الطريقة استجابة الطبقة لتغيير عدد الخبراء. تُقاس الحساسية كميًا بثلاثة مقاييس.
مراحل نقل الميزانية:
- استكشاف كل طبقة.
- تقييم الاستجابة لتغيير عدد الخبراء.
- القياس الكمي للحساسية بثلاثة مقاييس.
- استنتاج التوزيع الأمثل تحليليًا للميزانية.
- التحسين بالبحث الجيني مع قيد على الحساسية.
يوجّه التوزيع التحليلي السعة نحو الطبقات الحساسة. وفي الطبقات المكرّرة يُستوعَب تقليص الميزانية. يستخدم البحث الجيني حساسية كل طبقة كأولوية مسبقة. وهذا يمنح تقاربًا أسرع وجودة توزيع أفضل.
الخلاصة: يستند نقل الميزانية إلى حساسية قابلة للقياس، لا إلى قاعدة موحّدة.
المقارنة مع النهج الموحّد ونهج التقليم
يتفوّق MAPLE على الخطوط الأساسية الموحّدة والقائمة على التقليم في أربعة نماذج MoE مختلفة الحجم والبنية. تجري المقارنة عند ميزانية 75% من الخبراء الموجَّهين.
| البديل | ميزانية الخبراء الموجَّهين | النتيجة |
|---|---|---|
| الخط الأساسي الموحّد | 75% | أدنى من MAPLE |
| الخط الأساسي القائم على التقليم | 75% | أدنى من MAPLE |
| MAPLE | 75% | يتفوّق على كلا الخطين الأساسيين |
| الخط الأساسي الموحّد | 100% | أدنى من MAPLE بنسبة 75% على DeepSeek-MoE-16B في ARC-E وARC-C وBoolQ |
على DeepSeek-MoE-16B يستخدم MAPLE 75% فقط من الخبراء. ومع ذلك يتجاوز الخط الأساسي الأصلي الموحّد بنسبة 100% في ARC-E وARC-C وBoolQ.
نمو الدقة:
- ARC-E: من 65,09 إلى 71,40.
- ARC-C: من 48,49 إلى 51,50.
- BoolQ: من 80,03 إلى 82,38.
الخلاصة: قد يكون التوزيع غير المتجانس أكثر فعالية من مجرد تفعيل عدد أكبر من الخبراء.
الكفاءة عند الخدمة في SGLang
يقلّل تنفيذ MAPLE في SGLang زمن الاستجابة من الطرف إلى الطرف عند الخدمة على وحدة معالجة رسومات واحدة بنسبة 32,2%. وترتفع الإنتاجية بنسبة 47,4%.
لا تغيّر الطريقة الأوزان. لذلك يمكن دمجها في حزمة خدمة MoE القائمة. وهذا يجعل نقل الميزانية رافعة عملية للاستدلال.
المعيار العملي: بالنسبة للخدمة على وحدة معالجة رسومات واحدة عبر SGLang، يمنح النهج خفضًا في زمن الاستجابة ونموًا في الإنتاجية.
معايير الاختيار
يستحق MAPLE النظر في عدة حالات:
- الحاجة إلى تقليص ميزانية الخبراء الموجَّهين دون إعادة تدريب.
- أن يكون النموذج MoE LLM مُدرَّبًا مسبقًا.
- الحاجة إلى مراعاة عدم التجانس بين الطبقات، لا قاعدة موحّدة.
- الحاجة إلى رفع كفاءة استدلال MoE.
الخلاصة: يصبح التوزيع غير المتجانس للخبراء محورًا جوهريًا وعمليًا لرفع كفاءة MoE.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
التحقق من هلوسات LLM عبر عرض المصادر باستخدام SQL، دون إعادة تدريب
تبحث الدراسة فيما إذا كان بإمكان نموذج لغوي كبير توظيف مهارة رمزية أساسية — إنشاء قاعدة بيانات SQL من المستندات المصدرية — للاستدلال على المصدر دون إشراف عند كشف الهلوسات. ويحقق هذا المسار العصبي الرمزي على مجموعتي RAGTruth وDiaHalu دقة أعلى من التنبؤ المباشر، ويضاهي أحدث الأساليب دون الحاجة إلى ضبط دقيق بحسب المجال.
9 نوفمبر 2026
MathAdv: ما الذي تخفيه الدقة النهائية للبراهين الآلية
تقيّم مجموعة مهام تشخيصية تغطي 13 فرعًا جامعيًا ودراسات عليا في الرياضيات أنظمة البرهنة الآلية في Lean 4، ليس من حيث النتيجة النهائية فحسب، بل أيضًا من حيث الإلمام بالمادة وجودة الاستدلال غير الرسمي والقدرة على التعامل مع إعادة صياغة الشروط. ويُظهر التحليل التفصيلي أن تحويل المسألة إلى صيغة رسمية لا يزال العقبة الأبرز، وأن النجاح يعتمد بشدة على فرع الرياضيات وطريقة صياغة المسألة.
9 نوفمبر 2026
AffordanceWAM: إمكانات الفعل كوسيط بين التنبؤ بالمشهد والتحكم في الذراع الروبوتية
يصف العمل نموذجًا توليديًا يتنبأ في الوقت نفسه بمشاهدات RGB المستقبلية والحقول العددية والخرائط الحرارية لإمكانات التفاعل، وبأوامر الروبوت المستمرة، مستفيدًا من مقاطع الفيديو البشرية لزيادة تنوع التفاعلات دون الحاجة إلى تعليقات توضيحية للأفعال أو إعادة استهدافها. وفي RoboCasa وCALVIN ABC→D والمهام الواقعية، يحقق هذا النهج تحسنًا ثابتًا مقارنةً بالخطوط الأساسية المعتمدة على RGB فقط أو على بيانات الروبوت فقط.
9 نوفمبر 2026