
أين يخطئ قاضي LLM: التحقق من موثوقية التقييم الآلي لوكلاء الصوت
قارن مؤلفو ورقة أولية على arXiv كيف يحكم المُقيّمون البشر ونماذج GPT-4.1 وGPT-5 على المحادثات نفسها لوكلاء صوتيين في قطاعي الاتصالات والتجزئة — عبر 10 مقاييس للفعالية والسلامة في ثلاث مخططات تقييم. والخلاصة: الأتمتة ليست مناسبة في كل الحالات، وبعض المؤشرات (مثل Recovery Turn Count وsafety-recall) لا يمكن حتى الآن تركها للآلة دون إشراف بشري.
لماذا يصعب أتمتة تقييم الوكلاء الصوتيين
الوكيل الصوتي الحواري ليس نموذجًا واحدًا، بل خط أنابيب: التعرّف على الكلام، والاستدلال، واستدعاء الأدوات، وتوليد الرد، والتركيب، وبثّ الصوت. ولا يبقى الخلل في أي مرحلة محصورًا في مكانه — بل يمتد على طول السلسلة ويظهر في الحوار نفسه. ولهذا السبب تحديدًا، لا يكون الحكم على جودة التفاعل ذا معنى إلا ككل، من البداية إلى النهاية، لا عبر حلقاته المنفصلة.
الإبقاء على فريق من المقيّمين البشريين مكلف وغير عملي: فلا يمكن توسيعه ليشمل مئات الآلاف من المحادثات، كما يتراجع انتباههم مع اقتراب نهاية الوردية. والمخرج الطبيعي هو إسناد التقييم إلى نموذج لغوي. وتتحقق مسوّدة arXiv حديثة:2608.24314 (أنوبام بوروار، شاشانك سينغ، كريتيكا سريفاستافا) تحديدًا من مدى تبرير هذا المخرج وأين ينهار.
كيف اختبر المؤلفون قضاة النماذج اللغوية الكبيرة
التجربة مبنية على محادثات حقيقية لوكلاء صوتيين من قطاعين — الاتصالات والتجزئة. وقد قُورنت التقييمات البشرية بأحكام GPT-4.1 وGPT-5، ليس وفق مقياس عام واحد، بل وفق عشرة مقاييس: بعضها يصف جودة الحوار نفسه، وبعضها الأمان.
ثلاث تهيئات بدلًا من واحدة
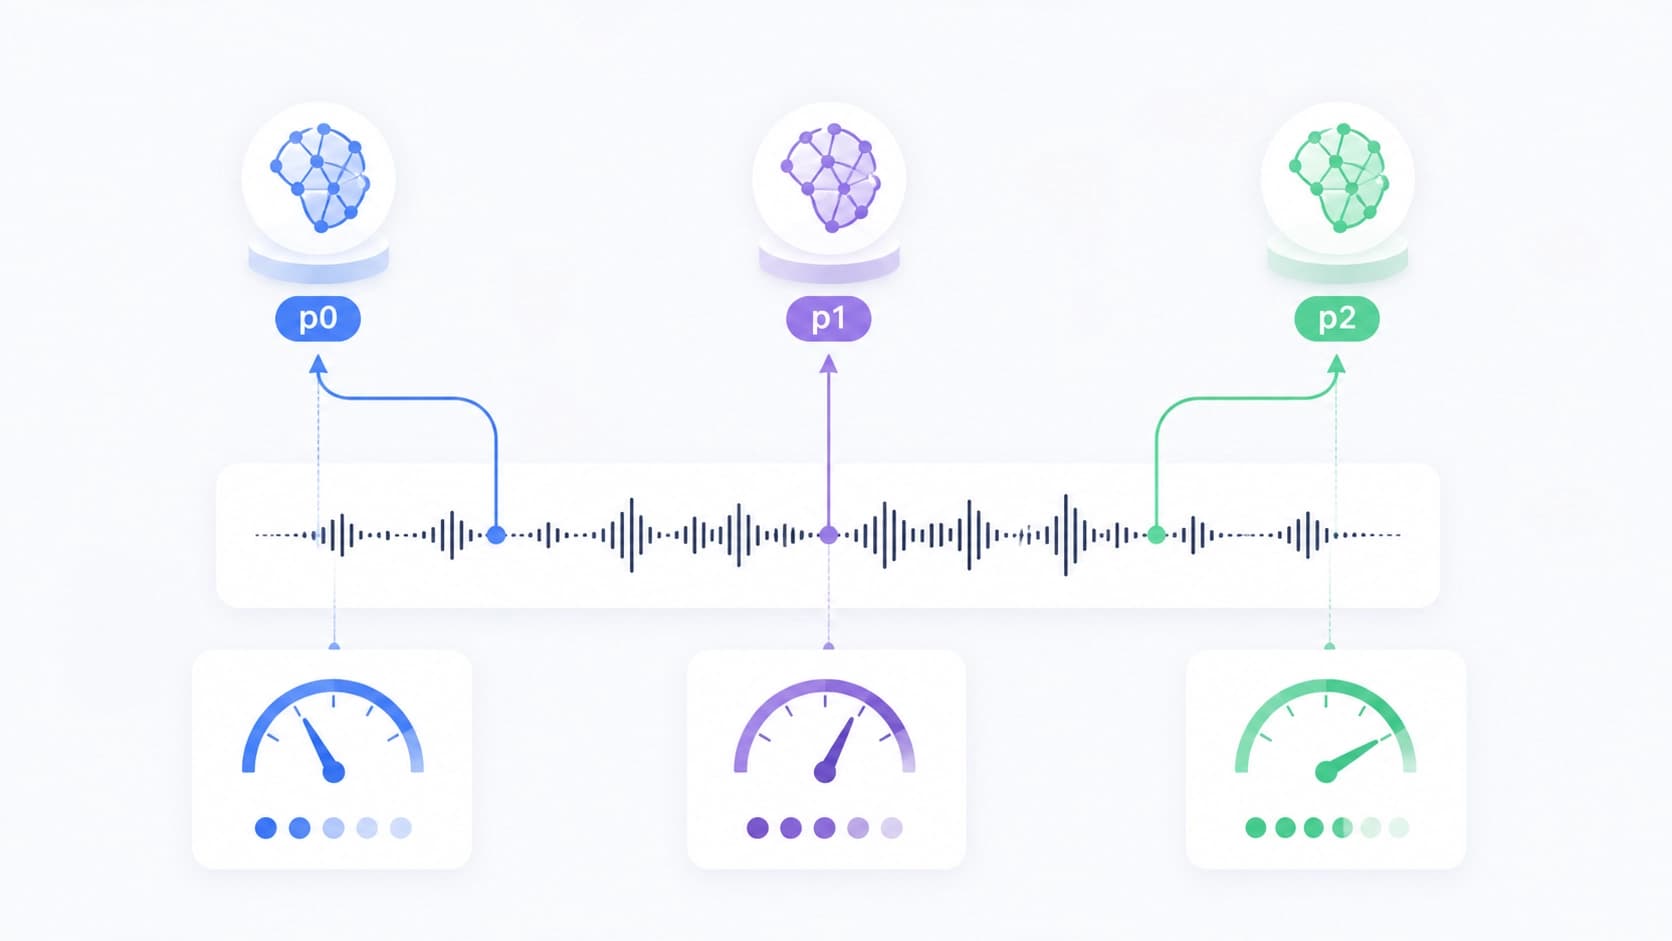
جُرّبت المحادثات نفسها عبر ثلاث مخططات تقييم — p0 وp1 وp2. والمغزى من التمرين بسيط: إذا تغيّر الحكم تبعًا لطريقة صياغة المعايير، فمعنى ذلك أن القاضي يقيس شكل التعليمات لا جودة الحوار. وأي مقياس «يتذبذب» بين التهيئات لا يصلح للأتمتة — على الأقل دون تحفّظات.
ما الذي قُورن بالضبط
التوافق المُجمَّع — نسبة التطابق بين الإنسان والنموذج — ليس سوى الطبقة العليا. ويحفر المؤلفون أعمق: ينظرون إلى الارتباطات لكل مقياس على حدة، ويتحققون من مدى استقرار التقييمات داخل مجموعة البشر، ويفكّكون الفروق المنهجية بين الإنسان والنموذج اللغوي الكبير. ويتيح هذا التقسيم فهم سمات الحوار التي تقبل التقييم الآلي، وتلك التي تصطدم بالسياق والتأويل.
أين يخطئ قاضي النموذج اللغوي الكبير
الاستنتاج الرئيسي يبدو أقرب إلى تحذير منه إلى ترويج للطريقة: موثوقية التقييم الآلي ليست متساوية — فهي تعتمد على المقياس المحدد وعلى التهيئة. فالنماذج القاضية نفسها تعطي نتائج متينة على بعض المقاييس وتتراجع بوضوح على أخرى.
Recovery Turn Count
يحسب هذا المقياس عدد الأدوار التي احتاجها الوكيل لإخراج الحوار من خلل ما. والتقييم الآلي هنا غير موثوق: فالقاضي لا يميّز دائمًا بين استعادة ذات معنى وصياغة موفقة بمحض الصدفة. والحوار الذي يصفه الإنسان بأنه أُنقذ قد يسجّله النموذج بسهولة فشلًا — والعكس صحيح.
مقاييس الأمان من حيث الاكتمال
Safety-recall هو المنطقة الإشكالية الثانية. ومنطق الخطأ متوقّع: يرى القاضي حوارًا لم يقل فيه الوكيل شيئًا خطيرًا، فيمنحه درجة عالية دون أن يسأل نفسه هل كانت هناك أصلًا فرصة لخرق السياسة. والانتهاك المُغفَل هو أغلى أنواع الخطأ، وهو تحديدًا الموضع الذي تكون فيه الأتمتة أضعف ما يكون.
النطاق يغيّر المعايرة
تختلف موثوقية القضاة بين الاتصالات والتجزئة. والاستنتاج العملي: لا يمكن نقل العتبات والمعايير آليًا من قطاع إلى آخر — فما هو معايَر في نطاق ما سينحرف في نطاق آخر.
المعايرة أهم من نسبة التطابق
الرقم الواحد للتوافق يُخدّر الحذر. فقد يتطابق النموذج مع البشر في المتوسط على الأعداد الكبيرة، لكنه يكون منهجيًا أكثر تسامحًا في الحالات الحدّية — وهذا الانحياز لا يظهر خلف النسبة الإجمالية. لذلك فإن تحليل ارتباط المعايرة وتفكيك الفروق لكل فئة من الحالات أنفع من مؤشر إجمالي واحد: فهو لا يُظهر «إلى أي مدى نحن متقاربون»، بل «في أي اتجاه وعلى أي شيء نخطئ».
كيف تدمج هذا في خط أنابيب حقيقي
لا يقترح المؤلفون التخلي عن الأتمتة — بل يقترحون مخططًا هجينًا. يتولى قاضي النموذج اللغوي الكبير التقييم بالجملة، ويبقى البشر حيث يلزم السياق ودرجة عالية من الثقة في الحكم. والقواعد العملية كالتالي:
- شغّل المعايير في تهيئتين أو ثلاث على الأقل وقارن النتائج، لا الدرجة النهائية فقط؛
- احسب التوافق لكل مقياس على حدة، لا برقم واحد لمجموعة البيانات بأكملها؛
- أبقِ الإنسان على safety-recall وعلى مقاييس الاستعادة بعد الخلل؛
- تحقق من المعايرة في نطاقك قبل وضع العتبات الآلية؛
- احتفظ بحالات الاختلاف بين الإنسان والنموذج — فهي مادة جاهزة لإعادة تدريب المعايير.
الخلاصة
قاضي النموذج اللغوي الكبير أداة عملية للتقييم واسع النطاق للوكلاء الصوتيين، لكنه ليس بديلًا عن المقيّم. فموثوقيته موزّعة بشكل غير متساوٍ: بعض المقاييس يمكن إسنادها بثقة إلى الأتمتة، وبعضها يتطلب نظرة بشرية. وتكمن فائدة الدراسة في أنها تقدّم إطارًا تجريبيًا لهذا التقسيم للعمل — وتذكّرنا بأن سؤال «هل نثق بالنموذج في التقييم» غير سليم ما لم يُحدَّد أي مقياس بالضبط وفي أي نطاق.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
Toollery: اختيار الأدوات لوكلاء LLM من بين عشرات الآلاف من الخيارات دون إعادة تدريب
ينشئ Toollery فهرسًا للبحث في أوصاف المهارات والأدوات، وعند تلقي طلب يمرّر إلى النموذج مجموعة محدودة فقط من الخيارات المرشحة. في تجارب على مكتبات تضم ما يصل إلى عشرات الآلاف من الوظائف، يتيح هذا النهج الحفاظ على جودة الاختيار عند قيمة top-K ثابتة، مع أن الأثر النهائي يعتمد على نمط عبء العمل والتخزين المؤقت لدى مزوّد الخدمة.
11 نوفمبر 2026
التشخيص التدريجي لوكلاء واجهة المستخدم الرسومية أثناء تحليل لوحات المعلومات: معيار DashAct
يقدّم DashAct معيارًا مرجعيًا يضم 348 مسارًا راجعها بشر، ويحلّل عمل وكلاء واجهات المستخدم الرسومية مع لوحات التحكم التفاعلية إلى ثلاث مراحل وأربعة شروط بصرية. وتُظهر النتائج مشكلات مستمرة في التنبؤ بالإجراءات وربطها بالأهداف البصرية، فضلًا عن اعتماد استجابة الوكلاء على الدعم السياقي والمكاني.
11 نوفمبر 2026
WILSON: دمج مستويات التكبير وشرائح المريض للتحليل الباثومورفولوجي وإعداد التقارير
تقدّم هذه الورقة البحثية الأولية نموذج WILSON، وهو نموذج للرؤية واللغة يرمّز صور الشرائح الكاملة وسلاسل العينات لمريض واحد عند درجات تكبير مختلفة، بدلًا من الاقتصار على شريحة منفردة «أفضل». ومن دون ضبط دقيق للمهمة، يتفوّق على نماذج الشرائح المتخصصة والأكبر حجمًا في عدد من المقاييس، مع عبء حوسبي أقل بكثير، كما حصلت أوصافه التشخيصية على تقييمات أعلى من اختصاصيي علم الأمراض.
11 نوفمبر 2026