بالضبط رقمان هما ما يظهر عادةً في تقرير جودة التقييم الآلي: مدى تطابق أحكام النموذج مع الأحكام البشرية، ومدى صمودها أمام تغييرات طفيفة مثل إعادة ترتيب الخيارات أو إعادة صياغة الأمر النصي. لكن عملًا جديدًا يرى أن هذا لا يكفي — ويقترح النظر إلى الحَكَم بصورة مختلفة.
الموافقة تجيب عن السؤال الخطأ
الموافقة والصمود أمام التشويشات السطحية يتعلقان بالموثوقية (reliability). فأداة القياس الموثوقة تُخرج نتيجة مستقرة، لكن الاستقرار بحد ذاته لا يقول شيئًا عمّا إذا كانت الأداة تقيس المقدار المطلوب أصلًا. فميزان حرارة يُظهر دائمًا 20 درجة هو موثوق للغاية وعديم الفائدة تمامًا.
ينقل مؤلفو الورقة «A Judge Should Know What Changed: Construct Validity for LLM-as-a-Judge Evaluation» (Jianlin Chen, Wenhui Chen, Ziyao Lin, Chi Man Vong; arXiv:2608.24419, cs.AI، قُدّمت في 25 أغسطس 2026؛ 39 صفحة، 10 أشكال، 11 جدولًا) النقاش إلى مستوى الصدق البنائي (construct validity): هل يتوافق التقييم مع المفهوم الذي يُفترض أنه يقيسه؟ وبالنسبة إلى حَكَم من نموذج لغوي كبير، يعني هذا أمرًا بسيطًا — يجب أن يتفاعل الحَكَم مع المعنى، لا مع الشكل.
ملف من بُعدين
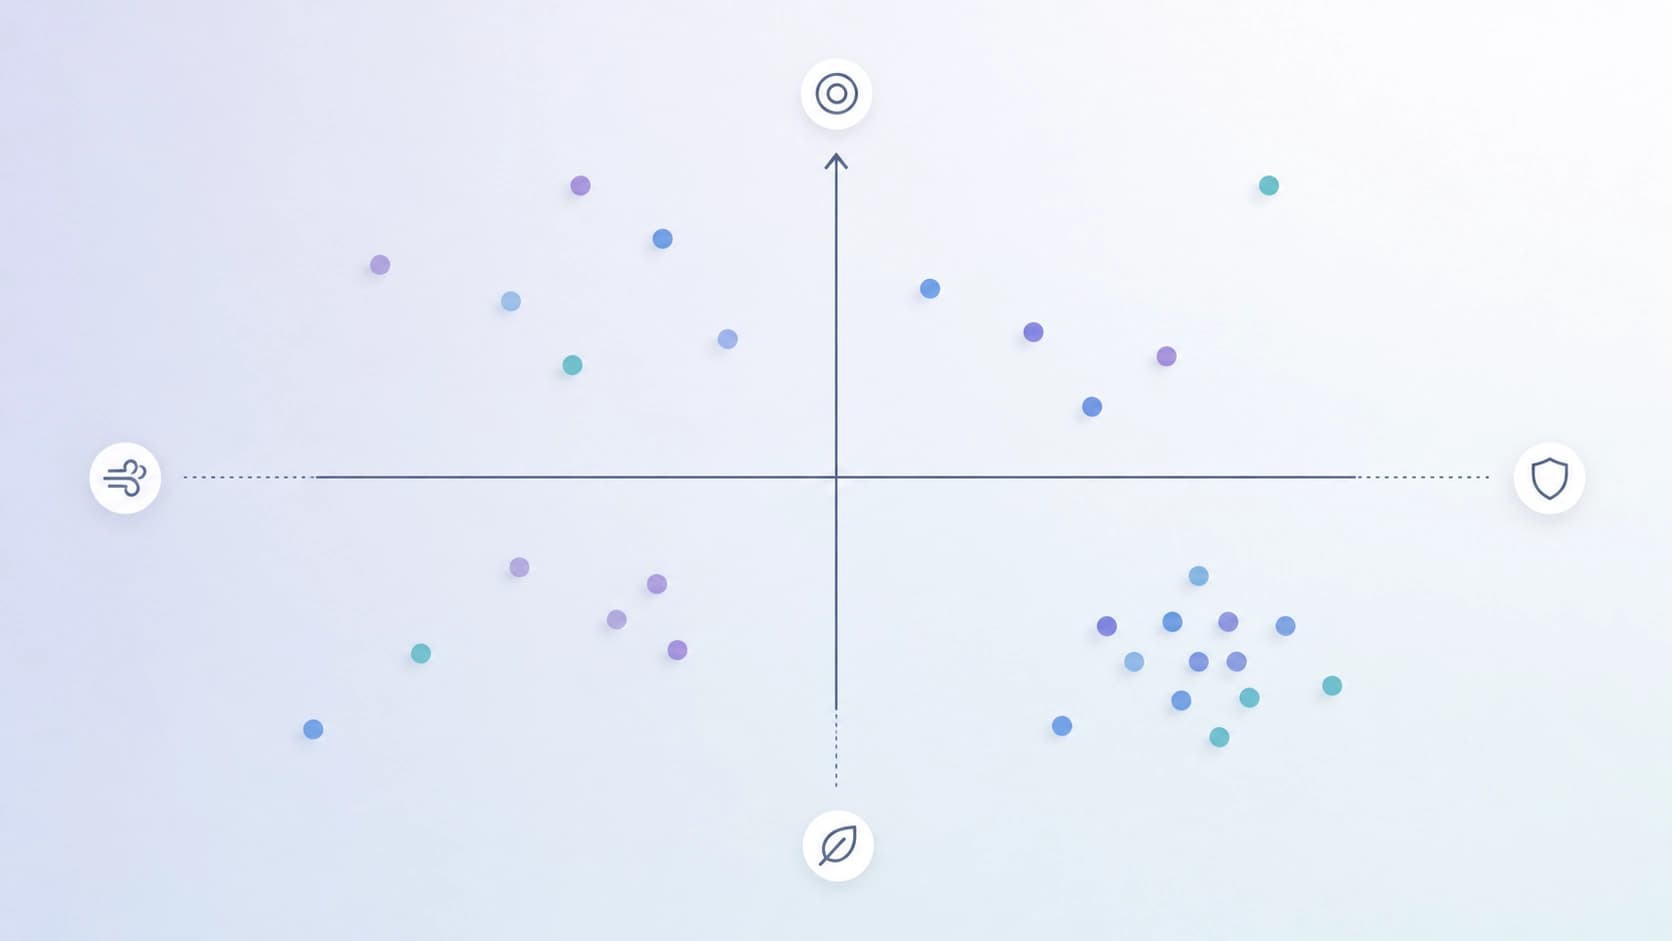
بدلًا من مقياس واحد، يُقترح ملف يتكوّن من احتمالين.
S — الثبات. كم مرة يبقى الحكم كما هو إذا حافظ التعديل على المعنى: إعادة ترتيب الفقرات، تغيير الأسلوب، حذف الحشو. الحَكَم الجيد هنا لا ينبغي أن يهتز.
R — الحساسية البنائية. كم مرة يتغيّر الحكم إذا كان التعديل ضئيلًا لكنه يمسّ المعنى: إضافة تحفّظ، إضعاف ادّعاء، تضييق نطاق التطبيق. الحَكَم الجيد هنا ملزم بأن يتفاعل.
والادّعاء المحوري في الورقة هو أن S و R مستقلان، وأن أي خلاصة عددية واحدة لا تحفظ كل المقارنات ذات الصلة. وبعبارة أبسط، لا يمكن حساب متوسط الرقمين والحصول على رقم واحد صادق — فحَكَم بـ S مرتفع و R منخفض، وحَكَم بـ S منخفض و R مرتفع، قد يعطيان «تقييمًا متوسطًا» متطابقًا مع بقائهما أداتين مختلفتين جوهريًا.
كيف جرى التحقق
البناء التجريبي أكثر صرامة بشكل ملحوظ من المعتاد في أعمال كهذه.
- 7 حُكّام و4 مجالات — أي أن الاختبار لم يجرِ على نموذج واحد ولا على نوع واحد من المهام.
- 7 أنواع من التدخلات المُغيِّرة للبنية مقابل 5 ضوابط لا تمسّ سوى السجل ولا تغيّر المعنى.
- اتجاه التعديل — هل يغيّر البنية أم لا — حدّده مُعنوِنون بشريون، لا تصنيف افتراضي.
- أُسندت عمليات التوليد والتحقق والتحكيم إلى عائلات نماذج غير متقاطعة. وهذه تفصيلة مهمة: فالحَكَم لا يقيّم نصًا ولّده هو نفسه، ولا يفحص تعديلات ابتكرها بنفسه.
ويستحق البند الأخير وقفة منفصلة. فعندما يكون المولِّد والمحقِّق والحَكَم النموذج نفسه، قد تكون الموافقة المرتفعة أثرًا من انحيازات مشتركة، لا دليلًا على الجودة.
الثبات شبه مثالي، أما الحساسية فلا
هنا يبدأ الجزء الأكثر إثارة. عند عتبة ثبات متوافقة S ≥ 0.90، أظهر الحُكّام في المتوسط S = 0.945. وهو الرقم الذي يُسعى إليه عادةً في التقارير.
أما الحساسية فكانت R = 0.319. وتفسيرها التقريبي: في نحو حالتين من كل ثلاث لم يلحظ الحَكَم تعديلًا يغيّر المعنى. أي أن نتيجة مثالية شكليًا في الثبات تتعايش مع استجابة ضعيفة جدًا للمحتوى.
النطاق والقوة ليسا شيئًا واحدًا
الحساسية الضعيفة موزّعة بشكل غير متساوٍ. فعندما يغيّر التعديل نطاق الادّعاء، تكون الاستجابة أعلى: R_scope = 0.383. وعندما يغيّر قوته، تكون أضعف: R_strength = 0.262. والفارق يبلغ +0.121، وإشارته واحدة لدى الحُكّام السبعة جميعًا.
أي أن الأمر ليس تشتتًا عشوائيًا بين النماذج، بل سمة منهجية. فالحُكّام يقرؤون توسيع نطاق التطبيق وتضييقه أفضل من الانزياح على مقياس اليقين — «محتمل» مقابل «بالتأكيد»، و«قد يساعد» مقابل «يساعد». ومن الناحية العملية، هذه أخبار غير سارة: فهذه التدرجات بالتحديد هي ما يلزم التمييز بينه في أغلب الأحيان.
التصنيفات البشرية أيضًا تستحق الفحص
ثمة خيط منفصل — خمس مجموعات تصنيفات عامة تُستخدم كمرجع. والمتنبّئات التي تعتمد حصرًا على سمات سطحية للنص تعيد إنتاج 55–67% من التصنيفات في الوضع الزوجي. وفي حالة MT-Bench، تطابقت الاستدلالات السطحية مع 67.4% من الأصوات البشرية.
والاستنتاج الذي يفرض نفسه غير مريح. فإذا كانت قاعدة بسيطة لا تفهم شيئًا من المحتوى تعيد ثلثي القرارات البشرية، فإن مثل هذه التصنيفات تفصل المعنى عن الشكل فصلًا ضعيفًا — ومن ثمّ لا يلزم التحقق من الحَكَم فحسب، بل من المجموعة نفسها التي يُختبر عليها.
ما العمل حيال ذلك
لا يقترح المؤلفون استبدال حُكّام النماذج اللغوية الكبيرة بشيء آخر — بل يقترحون تغيير أسلوب التقارير وإجراءات التحقق.
تقارير مشتركة. يُنشر S و R جنبًا إلى جنب، لا مطويَّين في رقم واحد. فيرى قارئ التقرير فورًا أين يقع خلل الحَكَم.
تدقيق مجموعة التحقق. قبل الوثوق بالموافقة مع التصنيفات البشرية، يجدر فحص مدى قابلية هذه التصنيفات للتنبؤ دون فهم النص. فإن كانت قابلة للتنبؤ جيدًا، فالوثوق بها مبالغ فيه.
فصل الأدوار. توزيع التوليد والتحقق والتحكيم على عائلات نماذج مختلفة يقلّل خطر أن يكون الثبات المرتفع نتيجة نقاط عمى مشتركة.
الفكرة الجوهرية
الموافقة المرتفعة تتعلق بالاستقرار، لا بالصواب. فالحَكَم الذي يصدر حكمه بالثقة نفسها قبل التعديل الدلالي وبعده ليس «صامدًا»، بل غير منتبه. وما دام في التقارير رقم واحد فقط، فلا سبيل للتمييز بين الحالتين — ولهذا بالضبط يبدو الملف المكوّن من بُعدين ليس تعقيدًا، بل الحد الأدنى الضروري من الصدق.