
لماذا يُعد سؤال «أرني أين هذا» سؤالاً خاطئاً
يبدو الاختبار الكلاسيكي للتوجيه البصري أشبه بشيء مدرسي: تُعطى صورة وعبارة مثل «المجلد الأزرق على الرف السفلي»، وعلى النموذج أن يحدد مكان الجسم المطلوب. طلب واحد، إجابة واحدة، ومقياس واحد — أصاب أم أخطأ.
البنية مريحة، لكنها تصف أمراً لا محادثة. في التواصل الحقيقي، نادراً ما يقدّم الإنسان وصفاً وافياً من المحاولة الأولى. يقول «حسناً، هذا الشيء قرب النافذة» ويتوقع أن يخمّن محدّثه أو يسأل مرة أخرى. يُبنى التفاهم المتبادل أثناء الحوار — أحياناً في دورين، وأحياناً في خمسة.
يقترح مؤلفا الورقة arXiv:2608.23978 (Zhengxiang Wang وOwen Rambow، وقد قُبلت في EMNLP 2026) اعتبار هذه المرحلة المفقودة بالتحديد موضوعاً للقياس. وسؤالهما هو: هل يستطيع النموذج لا أن ينظر فحسب، بل أن يسأل أيضاً عندما لا تكفي الصور والكلمات للوصول إلى استنتاج لا لبس فيه؟
كيف صُمّمت التجربة
نقص معلومات موجَّه
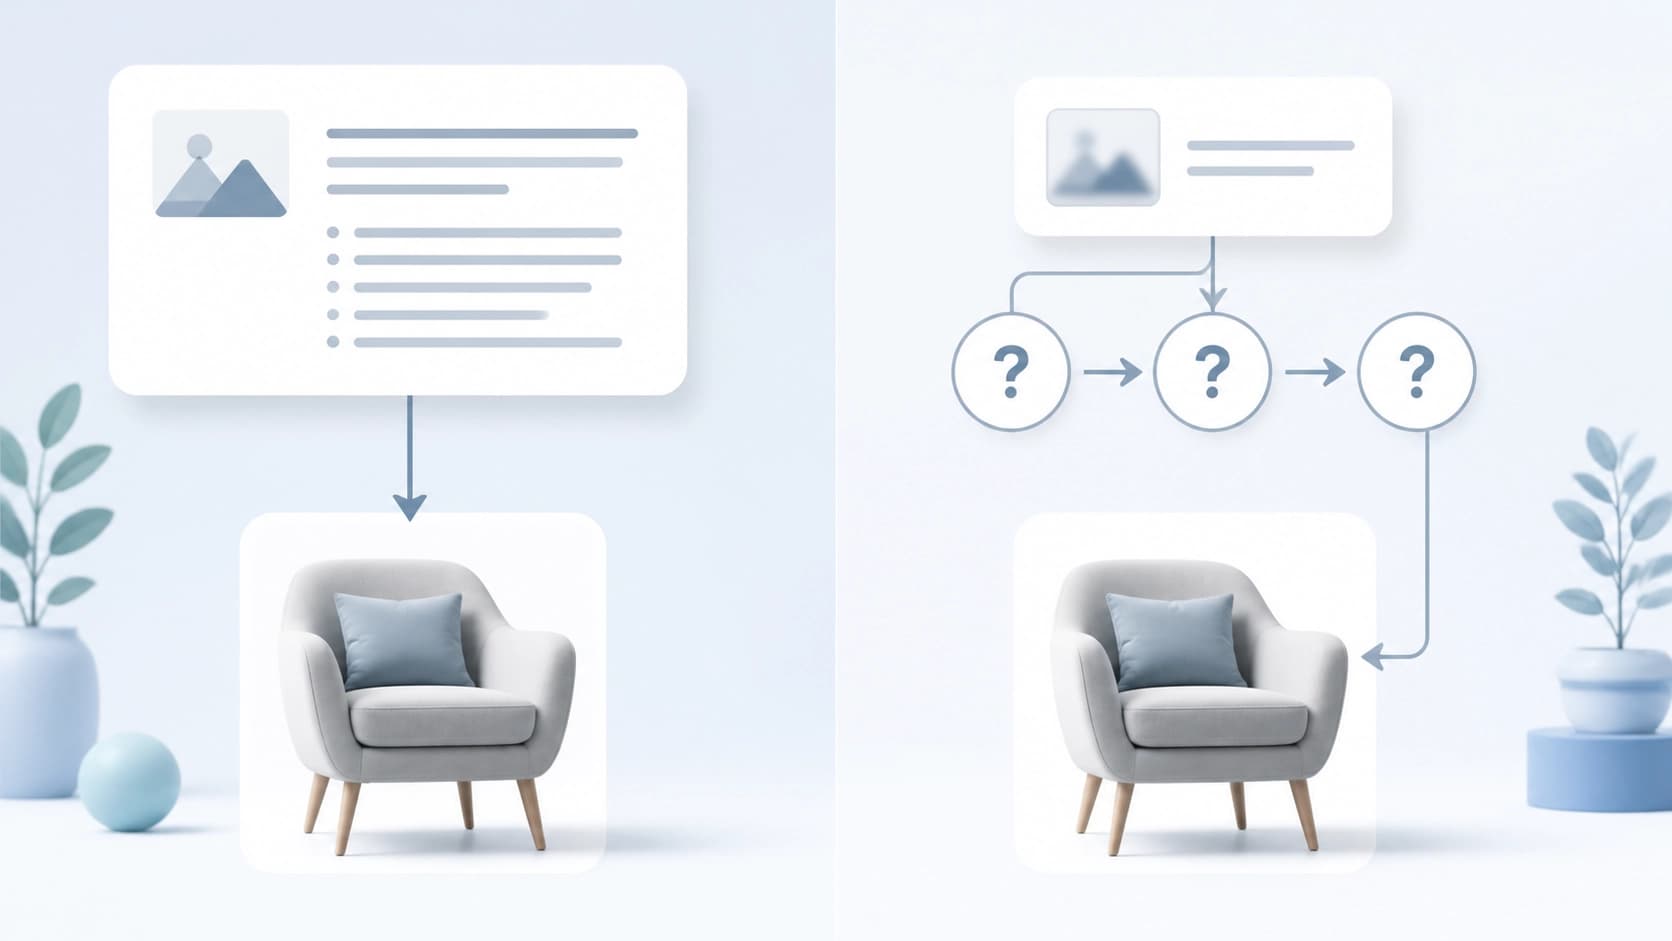
الفكرة الأساسية هي عدم قياس الدقة «في المتوسط»، بل ضبط مقدار المعلومات المتاحة عن الهدف مسبقاً بسلاسة، ومقدار ما يجب على النموذج استخراجه بنفسه. عند أحد طرفي المقياس، لا تكاد المهمة تختلف عن اختبار أحادي الخطوة عادي: الوصف مفصّل والهدف واضح. وعند الطرف الآخر، لا توجد صياغة أولية على الإطلاق، وكل ما يعرفه النموذج عن الجسم المطلوب عليه أن يستخرجه من أسئلته التوضيحية الخاصة.
تتيح هذه البنية فصل مهارة التعرّف عن مهارة إدارة الحوار. فالنموذج الذي يجد الجسم بإتقان عند إشارة دقيقة قد يفشل فشلاً تاماً عندما يجب تجميع الإشارة من شذرات.
أربع سياقات وأربعة بروتوكولات
تستند بيئة التجربة إلى أربع سياقات بصرية قريبة من السيناريوهات البشرية، وأربعة بروتوكولات تفاعل مختلفة. وهذا مهم: فالنتيجة لا تُختزل في إعداد واحد ناجح أو فاشل. وفي الوقت نفسه، جرى فحص من يصوغ الوصف بالتحديد — إنسان أم نموذج آخر — وكذلك كيف يؤثر حجم الاستدلال والمحاولات المتكررة وتغيير مزوّد الأوصاف. وقد تكررت الأنماط التي نتناولها أدناه في كل هذه المتغيرات.
أين يقع الخلل بالتحديد
الفجوة مع الإنسان تصمد في كل البروتوكولات
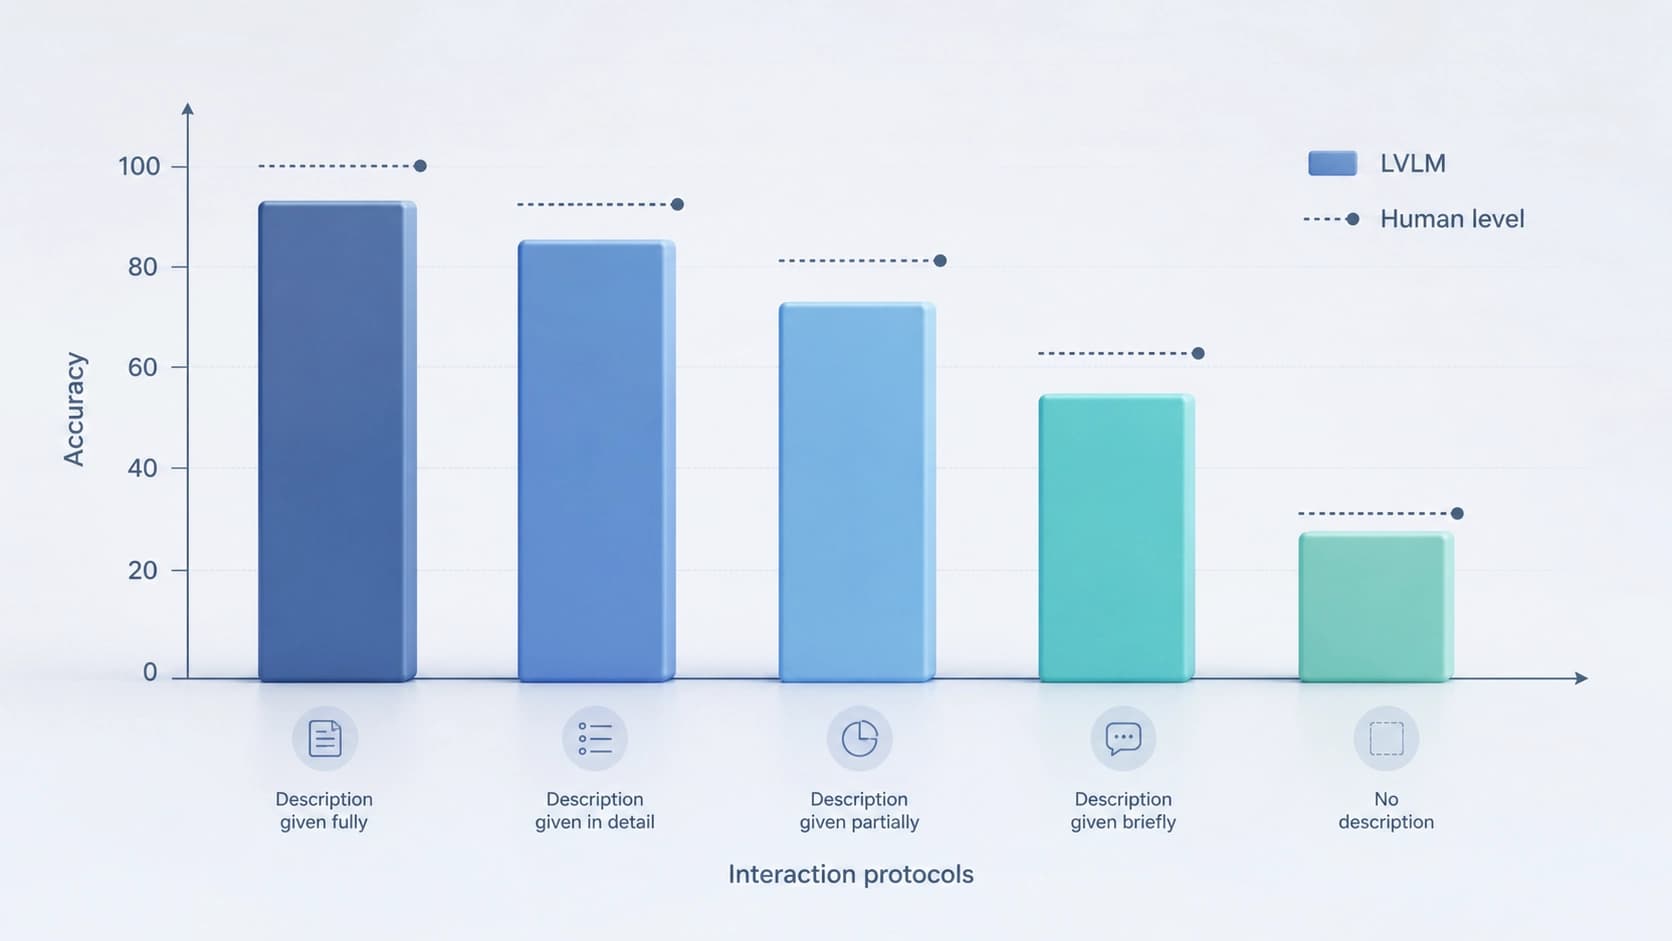
الاستنتاج الرئيسي غير مُبهج: في أي من الأوضاع لم تقترب النماذج اللغوية البصرية الكبيرة الحالية من المستويات البشرية المرجعية. وتظل الفجوة قائمة سواء بدت المهمة شبه بديهية أو تطلّبت حواراً حقيقياً. والأمر لا يتعلق بنقاط مئوية قليلة، بل بفارق نوعي في الموثوقية.
الأسوأ هو غياب الوصف تماماً
سُجّلت أدنى النتائج في السيناريو الذي تغيب فيه الصياغة الأولية للهدف. إذ يتعيّن على النموذج أن يبني بنفسه فرضية عمّا يبحث عنه، وأن يطرح أسئلة، وأن يضيّق نطاق البحث بناءً على الأجوبة. وهذا لم يعد تعرّفاً، بل سلوكاً استباقياً: عليه أن يقرر بنفسه أن المعلومات ناقصة، وأن يصوغ طلباً يسدّ هذا النقص.
وهنا يتجلّى الفشل الذي حملت الورقة اسمه: النموذج يجيد النظر، لكنه لا يجيد السؤال. فهو إما يراهن على التخمين، وإما يطرح أسئلة لا توضّح شيئاً.
التوضيح مفيد، لكن ليس دائماً
التفاعل ليس بلا جدوى. فعندما يصحّح السؤال التوضيحي الوصف الأولي أو يكمله، ترتفع الدقة بشكل ملحوظ. أي أن آلية الحوار موجودة في النموذج وتعود بالفائدة — لكن فقط في دور محرّر لصياغة شخص آخر. وبمجرد أن يجب إنشاء الصياغة من الصفر، يختفي هذا التفضيل.
الثقة قبل الدقة
ثمة خط تحليل منفصل — المعايرة. فالنماذج تُعلن بصورة منهجية ثقة أعلى من تلك التي تؤكدها دقتها الفعلية. وعملياً، يعني هذا أنه لا يمكن الحكم من إجابة النموذج على ما إذا كان يستحق الثقة: فالاختيار الصحيح والخاطئ معاً مصحوبان بنبرة واثقة بالقدر نفسه.
وبالنسبة للتطبيقات، هذا أخطر من مجرد الأخطاء. فإذا أخطأ النظام لكنه أشار بصدق إلى عدم ثقته، أمكن إعادة سؤاله أو استدعاء إنسان. أما إذا أخطأ بثقة راسخة، فلا يمكن بناء مثل هذه الحماية.
لماذا المهمة أصعب مما تبدو
يتطلب التوجيه البصري التفاعلي عمل ثلاثة آليات في آن واحد:
- المطابقة البصرية — ربط الكلمات بالأجسام في الصورة، بما في ذلك العلاقات المكانية والخصائص؛
- البحث عن المعلومات — إدراك أي المعلومات ناقصة والحصول عليها عبر سؤال، لا عبر التجريب الشامل؛
- التركيب — جمع الأجوبة المتفرقة في فرضية واحدة دون فقدانها في الطريق.
كل مهارة من هذه المهارات موجودة لدى النماذج الحديثة بدرجة أو بأخرى. لكن ما ينكسر هو الوصلة بينها: فما يُرى لا يتحول إلى سؤال، والجواب على سؤال لا يعيد تشكيل صورة العالم.
ماذا يعني هذا عملياً
إذا كنت تبني منتجاً على أساس نموذج متعدد الوسائط — لنقل GPT-4o أو أي واجهة برمجية أخرى تدعم الصور — فإن استنتاجات الورقة يمكن تحويلها بسهولة إلى حلول هندسية:
- لا تعتمد على الوصف الأول. إذا صاغ المستخدم طلبه بشكل غامض، فاعتمد حلقة توضيحات، لا طلباً وجواباً وحيدين.
- لا تثق بالثقة المُعلنة. من الأفضل بناء المعايرة على تصنيف خاص بك لمهمة محددة، لا على تقييم النموذج لنفسه.
- صمّم الأسئلة بدلاً من النموذج. إذا لم يستطع النظام إدراك ما ينقصه بنفسه، فسيتعيّن على طبقة منطقية خارجية أن تتولى دور السائل.
- اختبر على نقص معلوماتك الخاص. من المفيد فحص كيف يتصرف خط المعالجة في الأوضاع نفسها التي تنهار فيها الدقة وفقاً لبيانات المؤلفين.
الخلاصة
ترصد الورقة غياب تزامن بين المهارات، لا غياب القدرات. فالنماذج ترى ما يكفي للإجابة عن أسئلة مطروحة جيداً، لكنها لا تفهم الموقف بما يكفي لطرحها بنفسها. وطالما لم تُسدّ هذه الفجوة، سيبقى التوجيه البصري التفاعلي مهمة يظل فيها الإنسان الحلقة الأكثر موثوقية في الحوار.


