
اختبرت Figure نظام Helix 2.5 في 30 منزلًا: أنجز الروبوت بالكامل 237 مهمة من أصل 420
كان الروبوت يطوي المناشف ويرتب الأسرّة ويجمع الألعاب في منازل لم يزرها من قبل. وأظهرت الاختبارات أن المهارات تنتقل إلى أماكن جديدة، لكن 183 مهمة غير مكتملة وتقييم Figure للنتائج بنفسها لا يسمحان بعد باعتبار النظام جاهزًا للتنظيف بشكل مستقل.
ما الذي اختُبر
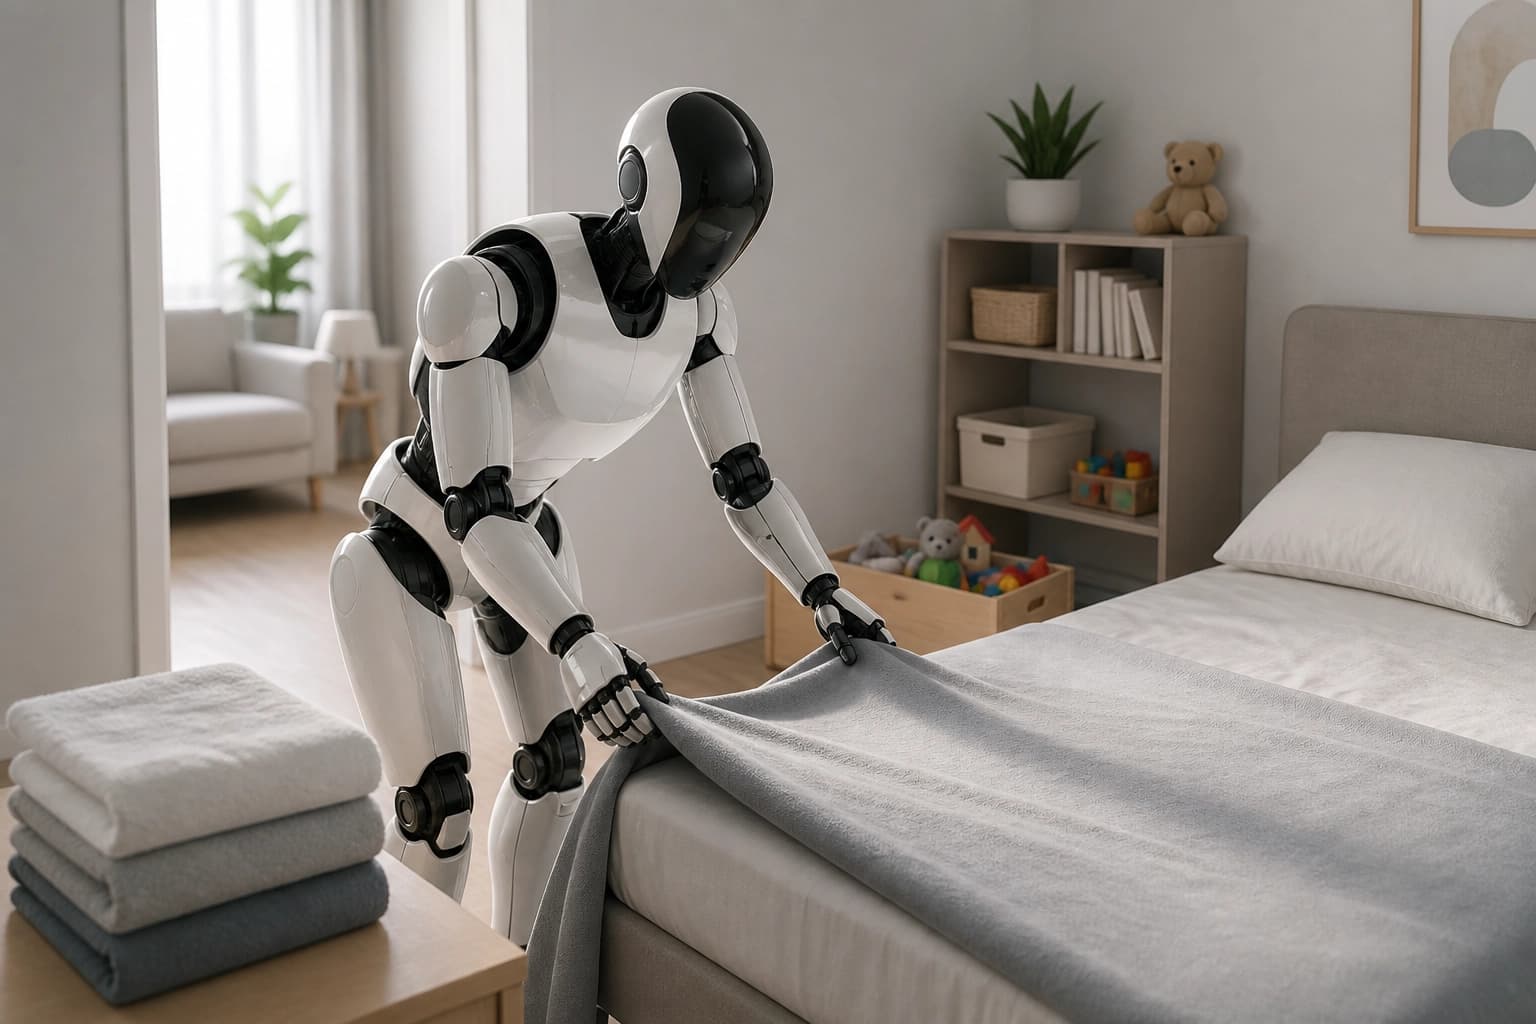
في 30 منزلًا غير مألوف في منطقة خليج سان فرانسيسكو، نفّذ Helix 2.5 ثلاث مهام: طيّ المناشف، وترتيب الأسرّة، وجمع الألعاب.
لم تجمع Figure بيانات مسبقًا في هذه المنازل. وعمل إصدار واحد من النموذج في جميع الأماكن: لم يُدرَّب تدريبًا إضافيًا في الموقع، ولم يُعدَّل بعد المحاولات السابقة.
سمّت الشركة التجربة zero-shot. كانت المنازل والأغراض جديدة، لكن المهام نفسها لم تكن كذلك: فقد دُرّب النموذج مسبقًا على تسجيلات من أماكن أخرى.
كيف احتُسب النجاح
شملت الاختبارات 420 مهمة. لم تُمنح أي نقاط جزئية: كان على الروبوت إكمال المهمة بالكامل.
- الألعاب: وضع الأغراض الـ13–15 كلها في السلة.
- المناشف: طيّ جميع المناشف.
- السرير: وضع وسادتين عليه، وشدّ الزاويتين العلويتين للبطانية، وتسويتها.
كان التدخل البشري لأسباب تتعلق بالسلامة يعني الإخفاق. لذلك، لا تعكس النتيجة النهائية سوى المهام المكتملة بالكامل من دون هذا التدخل.
عدد المهام التي أنجزها الروبوت
أكمل Helix 2.5 بنجاح 237 مهمة من أصل 420. وكان أداؤه الأفضل في ترتيب الأسرّة، والأسوأ في جمع الألعاب.
| المهمة | المحاولات الناجحة | نسبة النجاح |
|---|---|---|
| ترتيب السرير | 94 من 140 | 67% |
| طيّ المناشف | 87 من 140 | 62% |
| جمع الألعاب | 56 من 140 | 40% |
للمقارنة، درّبت Figure النظام على البيانات المتخصصة نفسها، لكنها بدأت بإعدادات عشوائية، من دون تدريب مسبق على Index. وأكمل هذا الإصدار 35 مهمة من أصل 420. ويُظهر الرسم البياني من Figure نسبة 8%، بينما يذكر النص المرافق 9%.
Index هي مجموعة Figure التي تضم تسجيلات لأفعال بشرية. ولم تتجاوز بيانات كل واحدة من المهام الثلاث 1.9% من هذه المجموعة.
ما الذي تقوله النتائج عن الجاهزية للاستخدام المنزلي
أجرت Figure التقييم بنفسها؛ ولم تُعَد النتائج بشكل مستقل حتى الآن. كما لم تحدد الشركة موعد إطلاق الإصدار المنزلي أو معدل الأعطال المقبول.
من أصل 420 مهمة، لم يُنجز الروبوت 183 مهمة. وترى Figure أن هذا العدد من الإخفاقات يعني أن الوقت لا يزال مبكرًا لتركه ينظف من دون إشراف.
ولا يقتصر التقييم العملي هنا على أفضل النتائج في المهام المنفردة. فالمعيار هو إكمال المهام بالكامل من دون تدخل بشري؛ والتحقق المنشور حتى الآن لا يؤكد الجاهزية للتنظيف المستقل.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
MathAdv: ما الذي تخفيه الدقة النهائية للبراهين الآلية
تقيّم مجموعة مهام تشخيصية تغطي 13 فرعًا جامعيًا ودراسات عليا في الرياضيات أنظمة البرهنة الآلية في Lean 4، ليس من حيث النتيجة النهائية فحسب، بل أيضًا من حيث الإلمام بالمادة وجودة الاستدلال غير الرسمي والقدرة على التعامل مع إعادة صياغة الشروط. ويُظهر التحليل التفصيلي أن تحويل المسألة إلى صيغة رسمية لا يزال العقبة الأبرز، وأن النجاح يعتمد بشدة على فرع الرياضيات وطريقة صياغة المسألة.
9 نوفمبر 2026
AffordanceWAM: إمكانات الفعل كوسيط بين التنبؤ بالمشهد والتحكم في الذراع الروبوتية
يصف العمل نموذجًا توليديًا يتنبأ في الوقت نفسه بمشاهدات RGB المستقبلية والحقول العددية والخرائط الحرارية لإمكانات التفاعل، وبأوامر الروبوت المستمرة، مستفيدًا من مقاطع الفيديو البشرية لزيادة تنوع التفاعلات دون الحاجة إلى تعليقات توضيحية للأفعال أو إعادة استهدافها. وفي RoboCasa وCALVIN ABC→D والمهام الواقعية، يحقق هذا النهج تحسنًا ثابتًا مقارنةً بالخطوط الأساسية المعتمدة على RGB فقط أو على بيانات الروبوت فقط.
9 نوفمبر 2026
تحرير العروض التقديمية كعمليات قابلة للتحكم: إطار العمل EditPPT ومعيار DeckEdit-Bench
يحلل المؤلفون تحرير الشرائح عبر تحديد العناصر المستهدفة والإجراءات المسموح بها والتحقق من بقاء المحتوى غير المستهدف دون تغيير، بدلًا من توليد الشيفرة بحرية. ولقياس الجودة، أنشؤوا DeckEdit-Bench (183 مهمة على 28 عرضًا تقديميًا من إعداد أشخاص)، وأظهر مخطط EditPPT متعدد الوكلاء، باستخدام خمسة نماذج أساسية، نجاحًا في 66.7–74.9% من المهام مع الحفاظ على أكثر من 97% من المحتوى.
8 نوفمبر 2026