ثلاثة نماذج، ترخيص واحد، وبلا أي تحفظات
لم يعد Granite 4.2 مساعدًا مصممًا لاتباع التعليمات كما كانت الإصدارات السابقة من السلسلة. أعادت IBM بناء العائلة حول الاستدلال الصريح: أي من النماذج تسرد أولًا سلسلة الخطوات، ثم تصوغ الإجابة. يضم الإصدار ثلاثة أحجام — 3B و8B و30B معلمة.
الخبر الأهم للأعمال ليس في الاختبارات المعيارية، بل في الترخيص. تُوزَّع النماذج الثلاثة جميعها تحت رخصة Apache 2.0: التنزيل والتدريب الإضافي والتشغيل في بيئة الإنتاج لا تتطلب أي موافقات إضافية ولا قيودًا على الاستخدام التجاري. وبالنسبة للشركات في القطاعات الخاضعة للتنظيم، غالبًا ما ترجّح إمكانية الاحتفاظ بالأوزان on-prem على أي سطر في جداول المقاييس.
بالتوازي، صدر نموذجا كلام بعرض 470 مليون معلمة لكل منهما: Granite Speech 5.0 Turbo CTC — وسنخصص لهما حديثًا منفصلًا أدناه.
يُبدَّل وضع العمل مباشرة في قالب المحادثة. هناك thinking، وهناك non-thinking، وبينهما low-effort: ميزانية استدلال قصيرة للأسئلة البسيطة، كي لا تُهدر الرموز حيث لا تستحق المهمة ذلك. في الجوهر، النموذج نفسه يغطي كلا الحالتين: «فكّر جيدًا» و«أجب بسرعة».
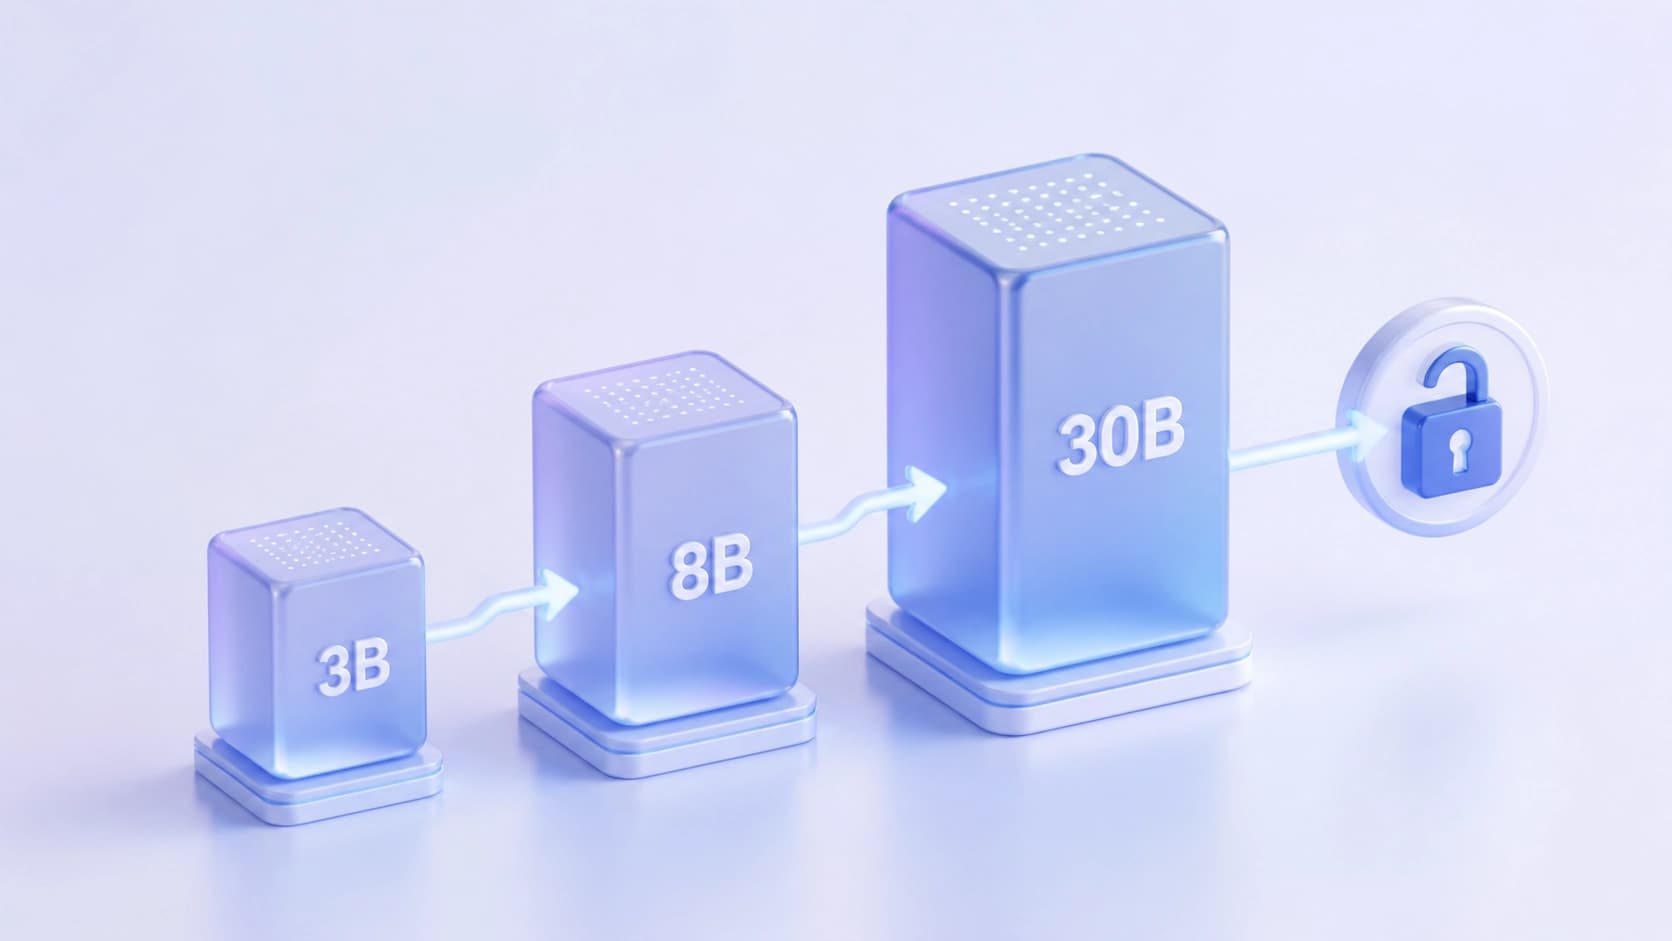
أي حجم لمن
3B — حاسوب محمول لمطوّر فردي
النموذج الأصغر موجَّه للمطورين الأفراد والشركات الناشئة الصغيرة. يمكن تشغيله محليًا عبر Ollama أو LM Studio، بما في ذلك على تكميمات GGUF المنشورة وصولًا إلى Q4_K_M. هذا سيناريو «ثبّته على الحاسوب المحمول وجرّب دون فاتورة API».
8B — بطاقة رسومات حديثة واحدة للفريق
الحجم المتوسط موجَّه لفرق السوق المتوسط: بطاقة رسومات حديثة واحدة تكفي لإبقاء النموذج في محيط العمل.
30B — المحيط المؤسسي
يتطلب الإصدار الأكبر قدرات من مستوى A100 أو H100، إضافة إلى التشغيل بصيغة FP8 أو NVFP4 على vLLM. لكن هذه هي الحالة التي يمكن فيها نشر النموذج داخل المحيط وعدم إخراج البيانات إلى الخارج.
القطاعات التي تستهدفها IBM صراحةً: تطوير البرمجيات وأدوات المطورين، والخدمات المالية، والرعاية الصحية، والاتصالات، والقطاع الحكومي، ومراكز الاتصال — وهذه الأخيرة تحديدًا مناسبة لنماذج الكلام الجديدة. السيناريوهات النموذجية — وكلاء لكتابة الشيفرة، وأتمتة الطرفية وDevOps، والبحث والاستقصاء العميق، وRAG على المستندات الطويلة، والاستدعاء المنظم للأدوات، والنسخ الصوتي بالجملة.
البنية: محوّل كثيف بلا حيل
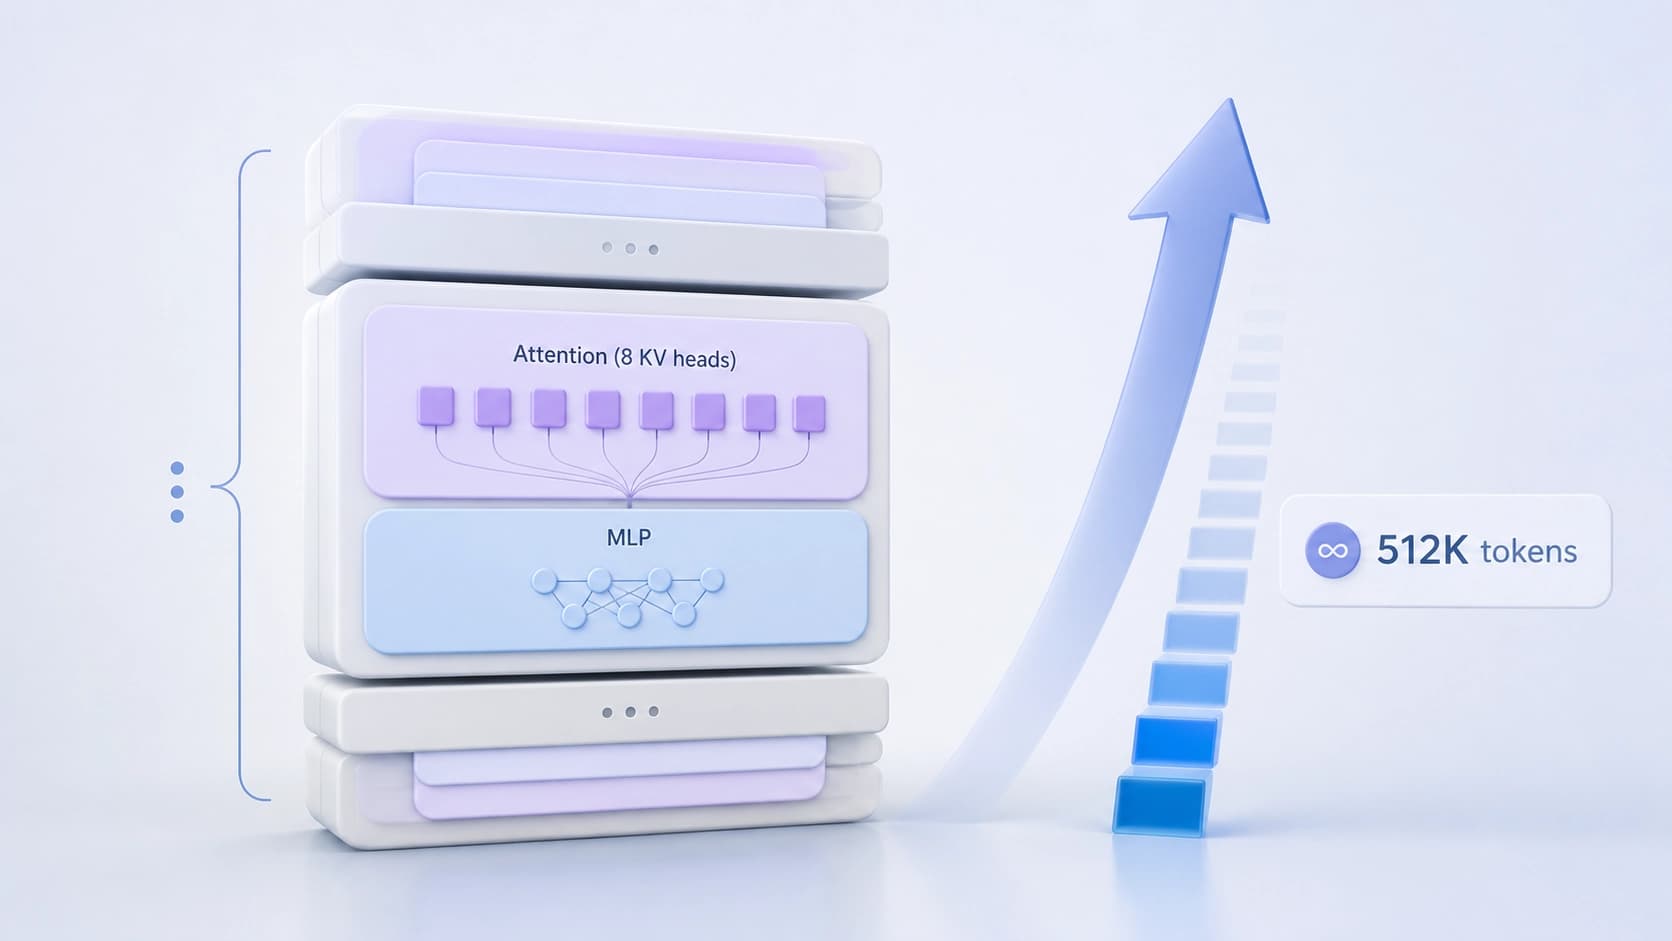
Granite 4.2 هو محوّل كثيف من نوع decoder-only. لا هجينة ولا mixture-of-experts: الرهان على قابلية التنبؤ بالسلوك وبساطة النشر، وهو أمر منطقي للمحيط المؤسسي.
من التفاصيل التقنية:
- Grouped Query Attention مع 8 رؤوس KV؛
- RoPE بقيمة θ = 10 000 000؛
- SwiGLU في MLP؛
- RMSNorm بقيمة ε = 1e-5؛
- تضمينات إدخال وإخراج غير مرتبطة؛
- دقة bfloat16.
تختلف الأحجام كالتالي: لدى 3B — 40 طبقة وتضمينات بحجم 2560، ولدى 8B — الطبقات الـ40 نفسها لكن بتضمينات 4096، ولدى 30B — 64 طبقة وحجم مخفي لـMLP يساوي 32 768.
يشير جدول البنية المنشور إلى طول تسلسل يبلغ 131 072 رمزًا، أي 128K. في المقابل، تألفت جولة التدريب المسبق من خمس مراحل وتضمنت مرحلة سياق طويل تصل إلى 512K رمز. جرى التدريب من الصفر على نحو 15 تريليون رمز.
التدريب: SFT ثم RL متعدد المراحل
اعتمدت مرحلة supervised fine-tuning على نحو 7.2 مليون عيّنة — حوالي 100 مليار رمز، منها نحو 65 مليارًا قابلة للتدريب. وتتوزع خليط البيانات كالتالي: 31.6% أمثلة وكيلية مقابل 68.4% غير وكيلية، مع نسبة 69% من الجزء الوكيلي لهندسة البرمجيات.
جُمعت المسارات في أُطر تشغيل — منها OpenHands وSWE-agent وTerminus-2 وMiniSWE وCodex وGoose. وجرى ترشيح الجودة بطريقتين: تولّى GPT-OSS-120B وGemma 4 دور الحكّام، إضافة إلى إزالة التكرار عبر SHA-256 على حقلي tools وmessages.
التدريب اللاحق ليس جولة واحدة، بل سلسلة RL عبر عدة بيئات. تمثل كل مرحلة جولة GRPO غير متزامنة منفصلة، تُهيَّأ warm-start من نقطة حفظ المرحلة السابقة؛ وبدلًا من شبكة value تُستخدم قاعدة leave-one-out، بينما يحدّ أخذ العينات المهم المقتطع من الانحراف في off-policy. الترتيب كالتالي: أولًا RLVR، ثم skill boosters، ثم SWE وTerminal وSearch، وفي الختام RLHF.
وهنا يكمن أهم قيد في الإصدار: طُبِّق جزء RL الوكيلي على 8B و30B فقط. أما 3B الأصغر فيمر فقط بـRL الأساسي والمواءمة — وهذا ما يفسر إلى حد كبير الفجوة في القدرات بين الأحجام. جرى التدريب على NeMo-RL وNeMo-Gym على عنقود NVIDIA GB200 NVL72 المستضاف لدى CoreWeave. إضافةً إلى ذلك، أُدرج في المسار تريليون رمز من الشيفرة الاصطناعية من CodeAlchemy وطبقة فك ترميز تخميني لتسريع الخدمة.
ما تُظهره مقاييس IBM
الأرقام معلنة من IBM نفسها، لذا يجدر قراءتها كدليل إرشادي لا كتحقق مستقل. ترتيب القيم — 3B / 8B / 30B:
- SWE-Bench Verified: لا يوجد تقييم لـ3B، ولدى 8B — 47.6، ولدى 30B — 57.00؛
- Terminal-Bench 2.1: 20.56 و29.24 على التوالي؛
- τ³-bench: 50.99 / 66.34 / 68.05؛
- BFCL v4: 52.41 / 50.29 / 61.39؛
- AIME25: 78.33 / 86.67 / 89.17؛
- GPQA: 54.80 / 64.14 / 66.41؛
- MMLU-Pro: 67.84 / 74.04 / 77.60؛
- RULER 128K: 55.30 / 71.41 / 81.38.
تفصيل لافت — في اختبار استدعاء الدوال يتفوق 8B قليلًا على 3B (50.29 مقابل 52.41). وهذا تذكير بأن الحجم بحد ذاته لا يضمن الأفضلية في كل مهارة على حدة، وأن اختيار النموذج حسب المهمة أهم من السعي وراء نقطة الحفظ الأكبر.
الكلام: 470 مليون معلمة بلا عمود فقري LLM
تختلف نماذج Granite Speech 5.0 Turbo CTC الكلامية جوهريًا عن أنظمة ASR المعتادة القائمة على نماذج اللغة: فلا يُستخدم هنا عمود فقري LLM إطلاقًا، بل يُنفَّذ تحويل الصوت إلى نص عبر connectionist temporal classification. ومن هنا يأتي الحجم المدمج — 470 مليون معلمة.
تعلن IBM عن RTFx بنحو 12 600 على بطاقة H200 واحدة، بينما يُظهر المتصدرون الحاليون في السرعة على Open ASR leaderboard نحو 6 000. وبالنسبة لمراكز الاتصال ذات أحجام التسجيلات الكبيرة، يُترجم الفرق في الإنتاجية إلى مال مباشرةً. يمكن تجربة النموذج في عرض توضيحي على WebGPU.
الخلاصة
جمعت IBM منتجًا متوقع السلوك لسوق المؤسسات: نماذج كثيفة بلا غرائب معمارية، وترخيص مفتوح، ونشر على العتاد الخاص، وأوضاع استدلال تناسب أنواعًا مختلفة من المهام. تتركز القدرات الوكيلية في 8B و30B، لذا من المنطقي النظر إلى 3B كنقطة دخول منخفضة التكلفة ونموذج للسيناريوهات البسيطة، لا كـ«أخ أصغر» بلا خسائر. يجدر التحقق من التفاصيل عبر مدونة IBM Research والوصف التقني والمستودع على GitHub، التي تُرفَق روابطها مع الإصدار.