
طريقة GoldiMask لضبط نماذج اللغة الانتشارية: اختيار السياق وترجيح الأهداف
يقدّم العمل GoldiMask، وهو نهج للضبط الدقيق الخاضع للإشراف لنماذج اللغة القائمة على الانتشار المتقطع، يختار الرموز المرئية عبر تعظيم تقريبي لدالة شبه معيارية، ويُسنِد أوزانًا إلى الأهداف المتبقية وفقًا لفائدتها التدريبية. وتُظهر التجارب على عدة نماذج ومجموعات بيانات تحسنًا في متوسط الدقة، ومكاسب في مهام الاستدلال المنطقي والبرمجة، فضلًا عن الحاجة إلى تكرارات أقل لفك الترميز المتوازي على GSM8K وMATH-500 مع جودة مماثلة تقريبًا.
يحدّد إخفاء الرموز قرارين في آن واحد
يعتمد الضبط الدقيق لنماذج اللغة الانتشارية المتقطعة على استعادة الرموز المخفية. يُحجب بعض رموز الإجابة بقناع، ويتنبأ النموذج بقيمها الأصلية استنادًا إلى السياق الظاهر.
يحدّد مخطط الإخفاء أمرين في آن واحد. فهو يحدد السياق المتاح للنموذج، كما يحدد الرموز التي تصبح أهدافًا للتنبؤ.
يرتبط هذان القراران أحدهما بالآخر: فالرمز الذي كُشف لم يعد هدفًا. ولا يأخذ الإخفاء العشوائي الموحّد هذا الارتباط في الحسبان. لذلك، تُكشف بعض الرموز في مواضع لا يساعد فيها ذلك كثيرًا على التنبؤ.
تُوصَف منهجية GoldiMask في ورقة Fine-Tuning Diffusion Language Models with Context Selection and Target Weighting (arXiv:2609.38385، 29 سبتمبر 2026). وهي مخصّصة للضبط الدقيق الخاضع للإشراف لنماذج اللغة الانتشارية المتقطعة.
| القرار | الإخفاء العشوائي الموحّد | GoldiMask |
|---|---|---|
| الرموز التي تُكشف لتكون سياقًا | اختيار عشوائي | اختيار وفق دالة هدف شبه معيارية |
| وزن الأهداف المتبقية | لا يعتمد على السياق المختار | يعتمد على فائدة السياق وإمكانات التدريب |
| العلاقة بين القرارين | لا تؤخذ في الحسبان | تؤخذ في الحسبان عبر إشارات النموذج |
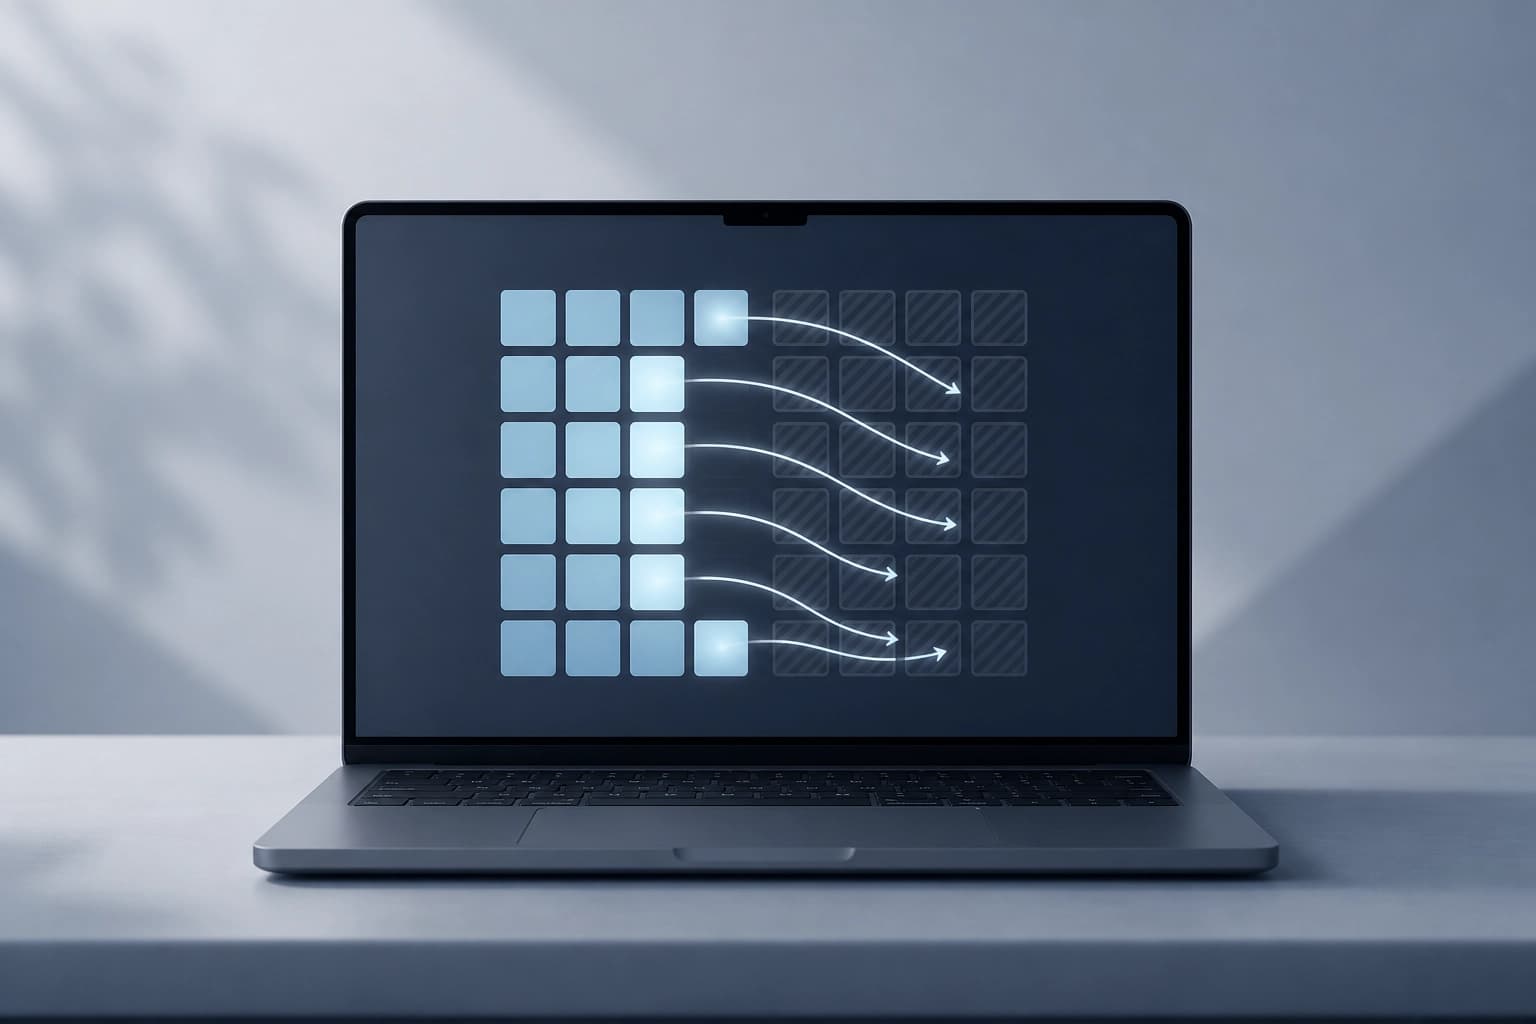
المعيار: ينبغي تقييم مخطط الإخفاء باعتباره قرارًا موحّدًا بشأن السياق والأهداف. عندئذٍ يتضح متى يكون كشف الرموز مبررًا ومتى لا يكون كذلك.
اختيار السياق استنادًا إلى إشارات النموذج
تختار GoldiMask الرموز التي ستُكشف لتكون سياقًا. ويهدف هذا الاختيار، على نحو تقريبي، إلى تعظيم دالة هدف شبه معيارية.
تستخدم المنهجية إشارات النموذج وتوازن بين أمرين:
- الفائدة من كشف رمز محدد؛
- قيمة هذا الرمز بوصفه هدفًا للتنبؤ.
من المفيد كشف الرمز الذي يساعد على التنبؤ بالرموز المحيطة. أما الرمز الذي لا يجيد النموذج التنبؤ به، فمن الأفضل إبقاؤه هدفًا.
المعيار العملي: لا يستخدم الاختيار العشوائي للسياق إشارات النموذج. وإذا استُخدم هذا المخطط تحديدًا، تظل إمكانات اختيار السياق غير مستغلة.
ترجيح الرموز المستهدفة
بعد اختيار السياق، تظل بعض الرموز أهدافًا للتنبؤ. وتُرجّحها GoldiMask مع مراعاة عاملين:
- مدى مساعدة السياق المختار على التنبؤ برمز محدد؛
- إمكانات التدريب المتبقية لهذا الرمز.
وهكذا يربط الوزن الأهداف بقرار السياق المتخذ مسبقًا. ولا يختار الترجيح ما يجب كشفه، بل يحدد إسهام الرموز التي ظلت مخفية في التدريب.
المعيار: عند تحليل مخطط الإخفاء، من المفيد الفصل بين سؤالين: ما الذي ينبغي كشفه، وما الوزن الذي ينبغي به تدريب الباقي؟
النتائج على النماذج ومجموعات البيانات
اختُبرت GoldiMask على ثلاثة نماذج أساسية وثلاث مجموعات بيانات تدريب. وحقق متوسط دقة المنهجية أعلى نتيجة في معظم الإعدادات التي جرى تقييمها.
شملت التحسينات مهام الاستدلال وتوليد الشيفرات البرمجية. وأظهرت دراسات الاستئصال للمكونات أن كلا الآليتين أسهمتا في التحسينات: اختيار السياق وترجيح الرموز المستهدفة.
المعيار العملي: لا يعني تحقيق أعلى دقة في معظم الإعدادات الفوز في كل تهيئة. ومن المنطقي اختبار المنهجية على الزوج المحدد «النموذج الأساسي + مجموعة بيانات التدريب».
الأثر على فك الترميز المتوازي
تتعلق نتيجة أخرى بفك الترميز المتوازي باستخدام عتبة للثقة. ففي GSM8K وMATH-500، تقلل GoldiMask عدد تكرارات فك الترميز.
وتظل الدقة متقاربة عند استخدام عتبات ثقة أعلى.
المعيار العملي: إذا كان مسار المعالجة يستخدم فك الترميز المتوازي مع عتبة للثقة، فإن المنهجية تؤثر في كل من عدد خطوات فك الترميز والدقة. لذا فإن التقييم استنادًا إلى الدقة وحدها غير مكتمل.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
اختبار وكلاء البرمجة في تطوير XR التفاعلي: نتائج GenXR-Bench
نُشرت GenXR-Bench، وهي مجموعة تضم 112 مهمة من إعداد خبراء لتقييم وكلاء البرمجة تقييمًا شاملًا في تطوير XR التفاعلي، بدءًا من تحسين الوظائف وإصلاح العيوب وصولًا إلى إنشاء التطبيقات والتحقق من سلوكها على أجهزة استهلاكية. حقق أفضل أداء بين النماذج العشرة التي خضعت للاختبار 50.9% Pass@1؛ وشملت الإخفاقات المتكررة التعامل مع الأحداث غير المتزامنة للمستشعرات، وربط الكائنات بالفضاء الواقعي، وفهم التفاعل في السياق المادي.
5 نوفمبر 2026
من المكافأة القياسية إلى جبهة باريتو: توليف RTL باستخدام النماذج اللغوية الكبيرة والتعلّم المعزّز متعدد المعايير
اقتُرحت طريقة لتدريب نموذج لغوي على توليد مجموعة من مرشّحات RTL بدلًا من مخطط واحد، مع مفاضلات مختلفة بين المساحة وزمن التأخير واستهلاك الطاقة؛ وتُبنى المكافأة على مساهمة كل خيار في حجم فرط جبهة باريتو. على RTLLM v2، ارتفع حجم فرط باريتو النسبي بمقدار 13.3 نقطة مئوية مقارنةً بالإصدار الأساسي من دون تحسين PPA، وبمقدار 14.4 نقطة مئوية مقارنةً بالتدريب بالتعلّم المعزّز ذي الهدف الواحد.
5 نوفمبر 2026
تتعرّف النماذج اللغوية الكبيرة الطبية على تحديثات التوصيات، لكنها غالبًا ما تجيب وفقًا للإرشادات القديمة
أظهرت دراسة ChronoEvo التي شملت 1709 تغييرات في التوصيات السريرية أن النموذج الأساسي رصد التحديث في 90,8% من الإجابات، لكنه طبّقه بالكامل في 58,5% فقط، وظلت فجوة قدرها 32,3 نقطة مئوية قائمة لدى 14 نموذجًا. وحتى تعزيز بروز التحديثات لم يحقق زيادة ملحوظة في التطبيق الكامل للقواعد الجديدة ضمن التوصيات السريرية.
4 نوفمبر 2026