
西门子物理AI:上千倍的速度,但工程师有最后的发言权
代理西门子模型在数秒内通过数千个设计变体进行电传,但是它们不能独立地批准关键部分:最终的确认总是停留在人类和古典的模拟上.
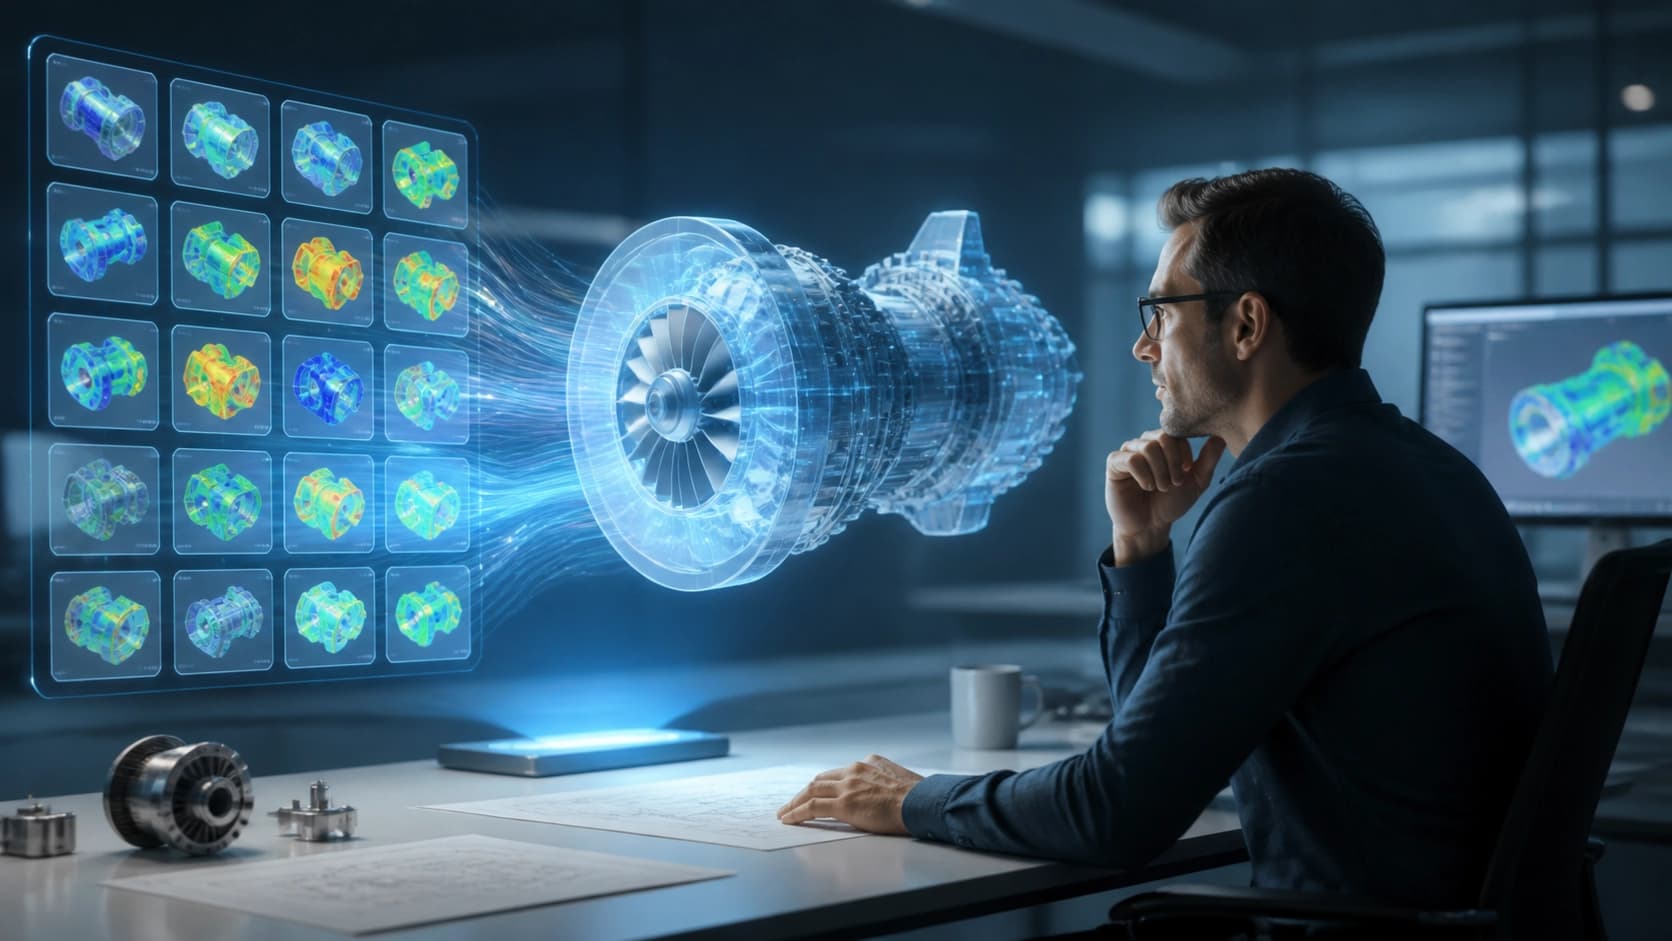
Simcenter PhysicalsAI是什么,为什么速度很快
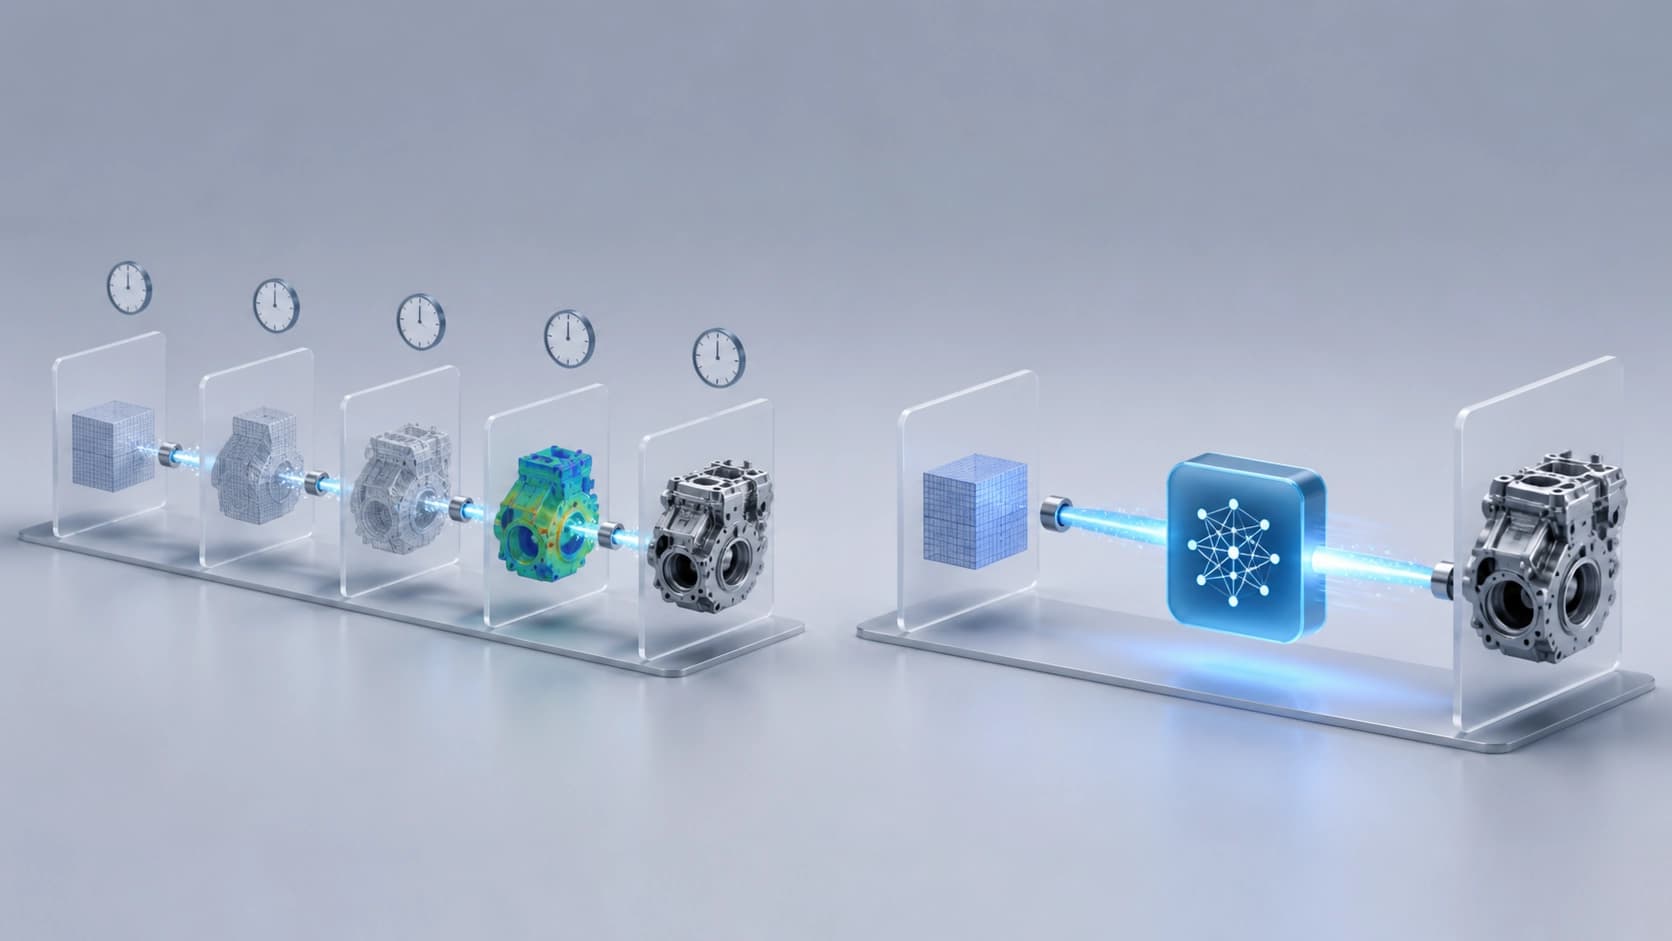
Simcenter PhysichologyAI是Simcenter家族出产的西门子产品,以几何深层学习为原理. 它的关键思想不是从零开始运行每一个计算,而是利用以往模拟中积累的数据. 该模型对这些数据进行了培训,并且根据新的设计,几乎立即对所需参数作出预测。
这种方法将评价设计变体所需的时间从小时缩短到秒. 西门子认为,速度的相差可以达到三个数量级——换句话说,比传统的解相快了1000倍. 当然,这种表现开辟了诱人的前景,但也有缺点。
高速不是高精度的同义词
Siemens Digital Industry Software的负责人Sam Mahalingam以完全坦率的方式回答在安全临界系统中使用基于物理的AI的问题:"不,这不合适". 这是值得记住的,任何希望将计算完全自动化,并将责任转移到算法上的人。
拥有足够多的训练数据,代用模型可以产生接近物理解析器的结果,传播率为1-3%. 然而,马哈林根本人强调:一个代孕者永远不会比它所训练的模拟更准确. 解析器中的任何错误和假设都会被自动转移到模型上. 这就是为什么基于物理的AI有一个客观的精确度上限,它永远不会超过.
正因为如此,西门子认为这一工具不是替代验证,而是快速初步筛选的机制. 最终确认总是由经典的解决者来决定。
Siemens如何提议使用基于物理的AI:过滤器,而不是最终判决
一个典型的情况是这样的。 一名工程师通过快取代词运行了数十个甚至数百个变体,从中选择了2到3个有希望的变体,然后用传统的物理解析器将变体传递给详细改进. 只有在全面核查后,设计才能获准生产。 工程师的角色不会消失——它会改变,从常规计算转向有意义的选择方向.
在大陆的一个涉及气囊的显著案例中,在寻找初始变体阶段专门使用了基于物理的AI. Mahalingam认为,仅基于AI的制作建议在任何情况下都不会发生.
另一个例子是与Magna合作的项目。 在那里,首先在Simcenter HEEDS环境中进行了广泛的搜索,然后在Simsolid中解出有希望的变体——一个没有网元一代的解析器. 由此产生的模拟数据被用于训练以物理为基础的AI模型. 如果数据不足,则会预先合成生成,再次依赖于西门子模拟器.
重要的是,保障制度中包含保障措施。 如果一个模型被训练成一种形状, 并且被喂入一个完全不同的形状, 它直截了当地说: “我无法预测,它是一个完全不同的形状。” 这种诚实的拒绝胜过沉默地产生不正确的结果。 这降低了工程师在不知不觉中通过信任不合适的模型"自相残杀"的风险.
为什么工程师要继续掌舵
西门子始终将基于物理学的AI定位为一种强大而严格限制的工具. 它在培训数据范围之外是无用的,不是用来作出最后决定的。 公司打赌,工程师们会信任一个 诚实地传达其边界的系统 不止一个 将希望的思维呈现为事实的系统
人类验证仍然是一个强制性步骤。 物理解说者仍然"握起笔",为一切必须可靠的事,正如马哈林格姆所比喻地说. 千倍速度是加速探索的令人印象深刻的方法,但最终的语句总是由工程师掌握.
常问问题
相关材料
所有材料
验证候选项比生成候选项更昂贵:对抗 LLM 漏洞搜索的诱饵
本文剖析了智能体缺陷搜索中的成本不对称:生成候选版本成本低廉,而通过可达性分析、执行和 PoC 对其进行确认却要耗费主要预算,因此可以将验证本身作为独立的防御目标。本文提出的 RedHerring 是一套针对代码仓库定制、带有隐藏证书的诱饵;在投入相同成本的情况下,它使 33 个 OSS-Fuzz 项目中发现的真实漏洞数量减少了 38.7–60.4%;即使提前告知智能体,降幅仍达 37.2%。
9 十一月 2026
通过 SQL 视图检查 LLM 幻觉,无需微调
这项研究考察了 LLM 能否运用一项基础的符号技能——根据源文档构建 SQL 数据库——在幻觉检测中实现无监督的来源归因。在 RAGTruth 和 DiaHalu 上,这种神经符号流程比直接预测更准确,且性能可与先进方法相媲美,无需针对特定领域进行微调。
9 十一月 2026
MathAdv:机器证明的最终准确率隐藏着什么
这套涵盖大学及研究生阶段 13 个数学分支的诊断性任务集,不仅根据最终结果评估 Lean 4 中的机器证明系统,还考察其学科知识、非正式推理质量以及对题目改写的适应能力。分项分析显示,将题目转化为形式化表达仍然是主要障碍,而成功与否在很大程度上取决于数学领域和题目的表述方式。
9 十一月 2026