
RLTLDR:智能体从失败中自行总结经验,并在下一次尝试中加以运用
失败后,系统会向智能体展示验证器的信号,并要求将其压缩成一条提示;训练基于“任务—提示”配对,不需要教师或标准答案。在复杂的编程和工具调用基准测试中,该方法将 Pass@1 从 GRPO 的 0–1% 提升至 12–31%,其中起决定作用的正是对这种配对关系的学习。
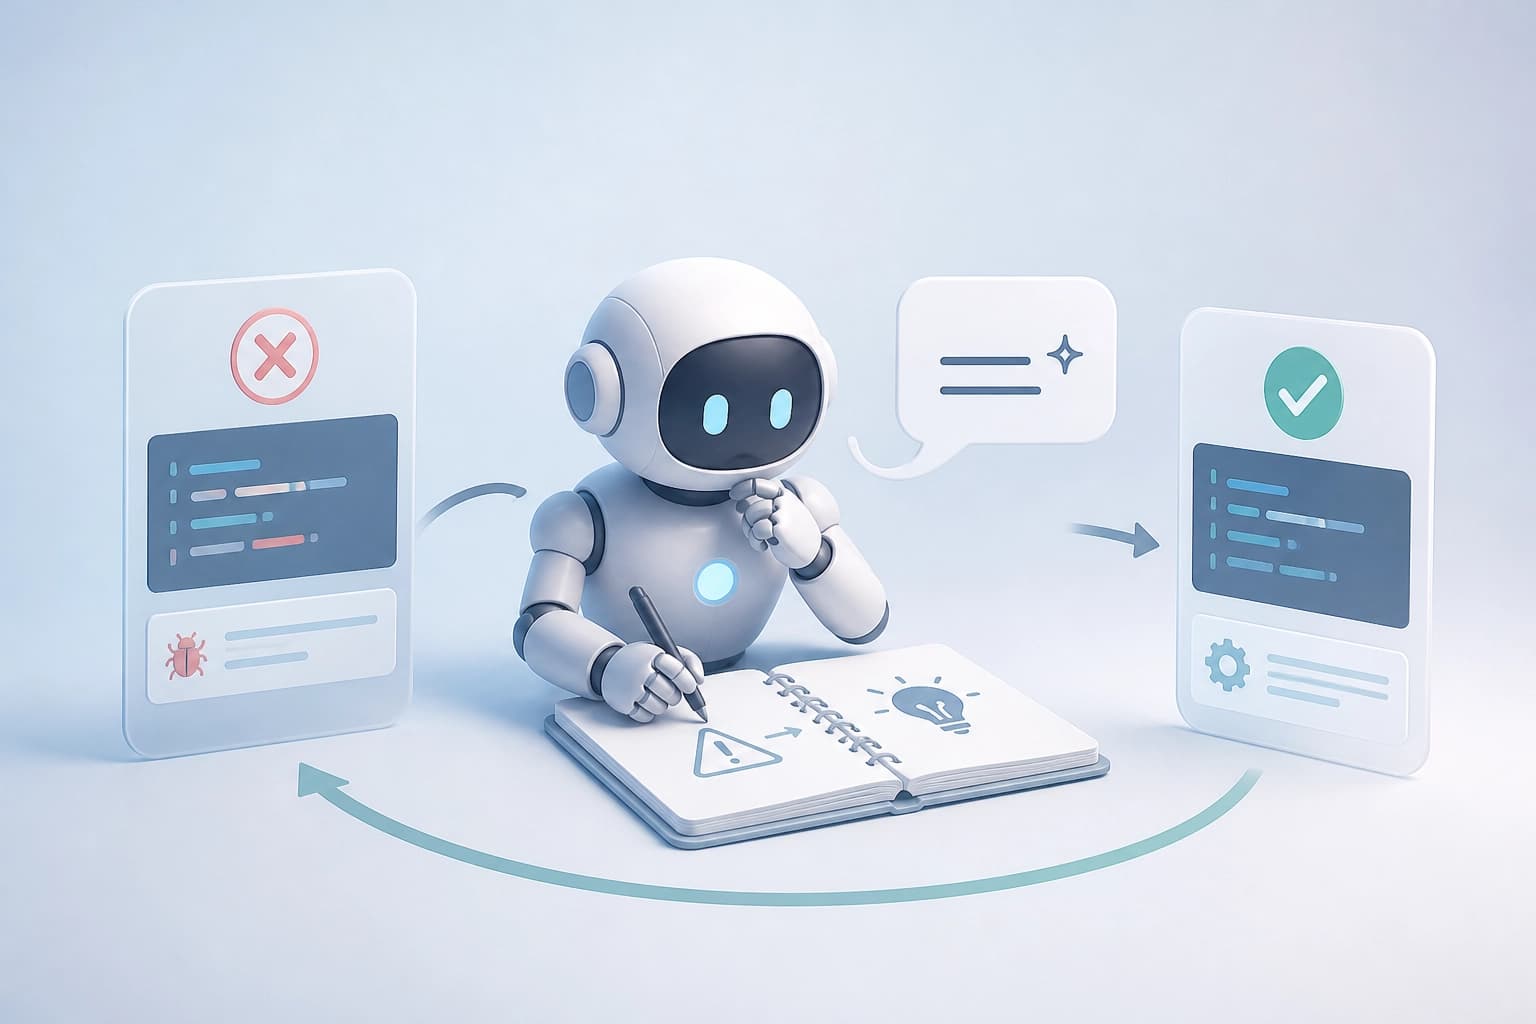
RLTLDR 是一种用于成功难度较高任务的智能体自我改进方法。一次尝试失败后,智能体会看到验证器的输出,并自行总结一条简短结论——TL;DR insight。下一次尝试会考虑所有先前的结论。Michael Kirchhof、Eleonora Gualdoni、Andrew Szot 及其合作者的研究介绍了这一方法。首个版本于 2026 年 9 月 29 日提交。最后编辑于 2026 年 10 月 19 日。
RLTLDR 要解决的问题
RLTLDR 旨在实现智能体自我改进。在这类任务中,智能体很难取得成功。没有教师模型,也没有可用于蒸馏的解题示例。因此,失败和验证器的输出就成为反馈来源。
任务条件:
- 没有教师模型;
- 没有可用于蒸馏的解题示例;
- 智能体很难取得成功;
- 失败后可以获得验证器的输出。
结论:RLTLDR 适用于没有现成解法和教师、但能够验证失败的场景。一个实用的判断标准是:是否有验证器,且其输出可以传递给智能体。
循环如何运作
RLTLDR 循环围绕连续尝试展开。每次失败都会为下一步提供素材。
步骤:
- 智能体执行一次 rollout 并失败。
- 智能体查看验证器的输出。
- 智能体自行给出反馈——一条简短的 TL;DR insight。
- 下一次 rollout 会考虑所有先前的结论。
- Rollout 持续进行,直到找到解决方案。
- 通过对上下文中的结论进行反向传播来训练,使模型学会“任务 → 结论”的对应关系。
结论:循环的价值不只在于为下一次尝试提供提示。关键因素是学会任务与结论之间的联系。
复杂任务上的结果
测试使用了面向工具调用和编程的复杂基准集。作者根据 Pass@128=0 的条件筛选了基准集。比较基于 Qwen 3.5 9B Thinking 策略进行。
| 方法 | 评估条件 | Pass@1 |
|---|---|---|
| 标准 GRPO 训练 | 不使用所述结论循环 | 0–1% |
| RLTLDR | 训练期间在上下文中提供结论 | 14–31% |
| RLTLDR | 评估期间不在上下文中提供结论 | 12–13% |
标准 GRPO 训练的 Pass@1 仍处于 0% 到 1% 的水平。训练期间在上下文中提供结论时,RLTLDR 达到 14–31%。评估期间不在上下文中提供结论时,结果为 12–13%。作者将学会“任务 → 结论”的对应关系视为关键因素。
结论:上下文中的结论能够提高 Pass@1。若要验证是否学会了这种对应关系,需要分别在有结论和无结论的情况下评估该方法。
SFTLDR:基于“任务—结论”配对进行训练
SFTLDR 是一种精简的训练方案。它只基于(任务,结论)配对进行训练,不使用 rollouts,也不对其进行反向传播。
关于 SFTLDR,已知信息如下:
- 训练仅基于(任务,结论)配对;
- SFTLDR 不展示 rollouts;
- SFTLDR 不对 rollouts 进行反向传播;
- 使用 4k 组此类配对进行训练,可以恢复 RLTLDR 几乎全部的性能;
- SFTLDR 的表现几乎达到基于完整 rollouts 的经典 SFT;
- 作者将这一方法描述为一种精简范式:“对于这类任务,记住这类要点”。
结论:SFTLDR 是一种精简的训练方案。判断标准:在能够收集“任务—结论”配对的场景中验证它。
适用标准
RLTLDR 需要可验证的反馈和连续尝试。缺少这些条件,就无法构建这一循环。以下标准有助于评估其适用性。
标准:
- 任务允许尝试失败并进行多次 rollout;
- 有一个验证器,其输出可以展示给智能体;
- 智能体能够总结一条简短结论;
- 下一次尝试会考虑所有先前的结论;
- 如果需要验证是否学会了对应关系,评估中应包含上下文中不提供结论的模式。
结论:RLTLDR 适用于有验证器且成功难度较高的任务。需要基于“任务—结论”配对进行精简训练时,则选择 SFTLDR。
常问问题
相关材料
所有材料
概率波浪预报校正:BridgeCast通过流式匹配连接物理模型与再分析资料
本文介绍了一种混合方法,利用条件流匹配、Transformer 架构和外生大气特征,将物理海浪模型的输出转换为接近再分析数据的场。作者称,该方法在不同预报时效和不同区域均稳定优于此前的先进基线方法。
12 十一月 2026
OpenCollab:可编程智能体协调、受控执行环境与规程遵循度指标
该框架将智能体交互结构的设定、统一的实验环境和详细的事件追踪整合在一起;新增的 Adherence 指标则反映实际执行与声明方案的符合程度。在基准测试中,Duo 配置达到新的 SOTA 水平,而单智能体版本的 token 消耗量最低。
11 十一月 2026
Toollery:从数万种选项中为 LLM 智能体挑选工具,无需微调
Toollery 根据技能和工具的描述构建搜索索引,并在收到请求时只向模型传递有限的一组候选项。在规模达数万个函数的库上进行的实验表明,该方法在固定 top-K 的情况下能够保持选择质量,但最终效果取决于负载特征和服务提供商的缓存情况。
11 十一月 2026