
最终答案作为唯一指标——以及它掩盖了什么
大多数语言模型基准测试都像学校考试:有问题、有标准答案、有匹配检查。计算这种指标很方便,比较模型也很方便。但这种方案有一个内在缺陷:它评估的是结果,而不是通往结果的路径。
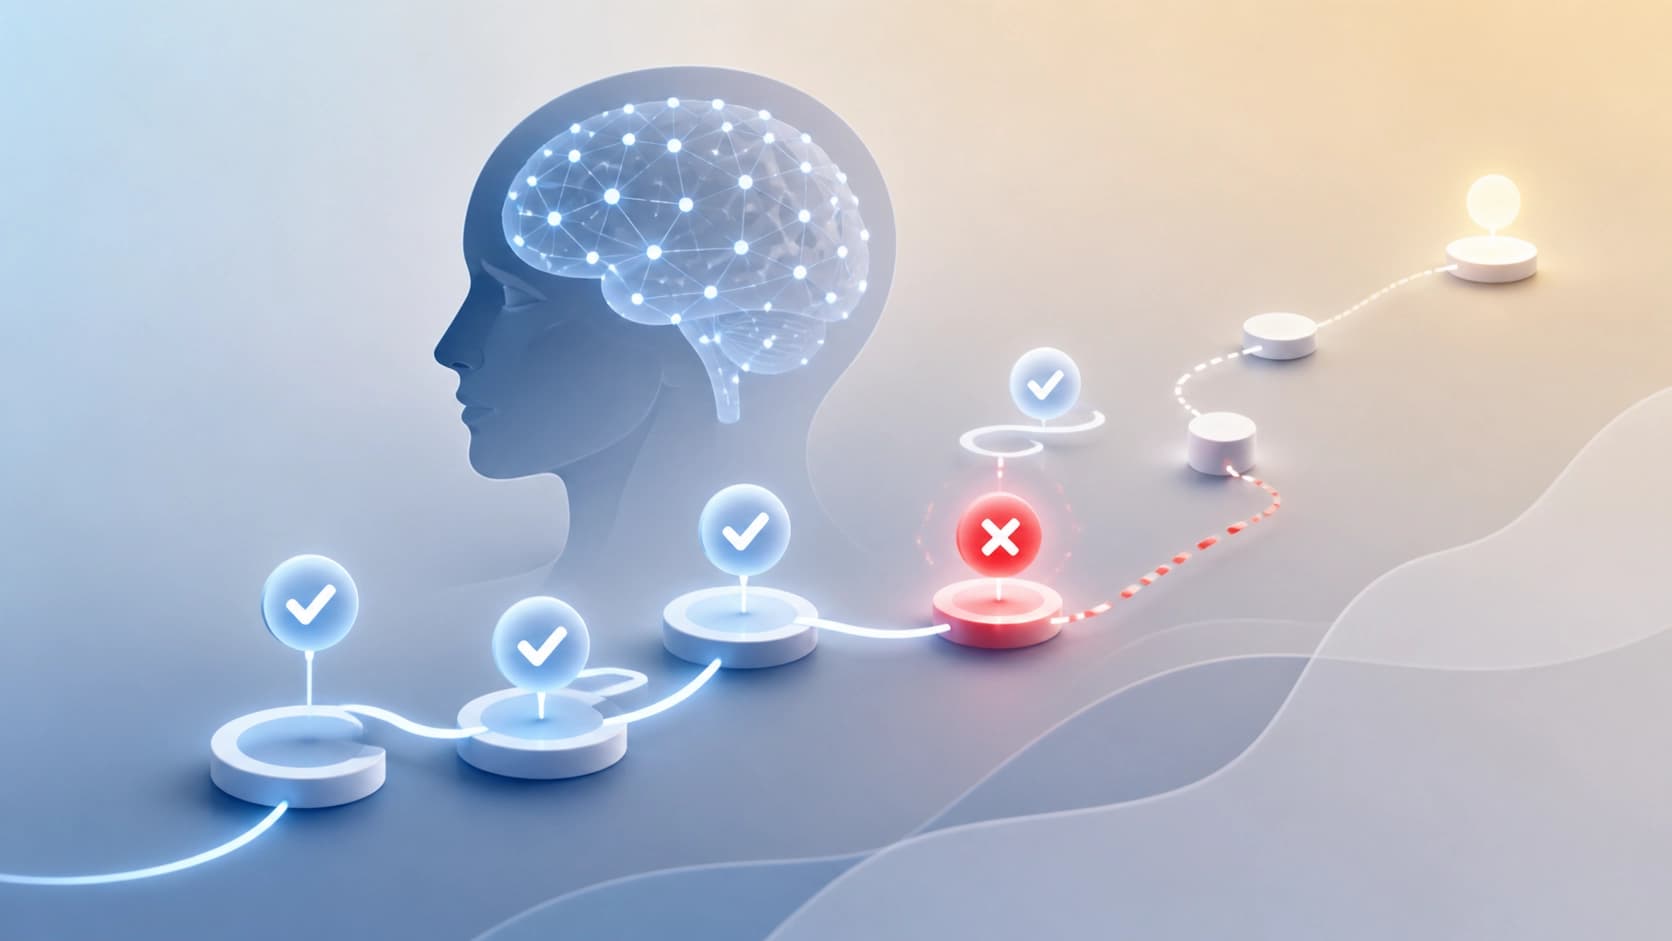
设想一个需要串联四个事实的任务。模型在第二个环节出错,在第四个环节碰巧猜对——于是拿到了分数。或者反过来:三个环节都构建得无可挑剔,只是最后一个答案的措辞不同——于是没有分数。在这两种情况下,最终数字都在谎报内部实际发生的事。这对多步问题尤其痛苦:那里考察的不是单一技能,而是它们的序列——找到信息、保持住它、与后续信息连接、在途中不丢失。
诊断"究竟在哪里断了"——不是学术上的吹毛求疵。它决定了该修什么:数据语料、训练策略还是提示词的表述。最终准确率从定义上就无法回答这个问题。
什么是 Omanic
正是这个盲区被《Omanic: Towards Step-wise Evaluation of Multi-hop Reasoning in Large Language Models》这项工作填补了(arXiv:2603.16654,归入 cs.CL 分区,同时被归入 cs.AI 和 cs.LG,已被 EMNLP 2026 Findings 接收)。作者团队规模庞大且国际化:Xiaojie Gu、Sherry T. Tong、Aosong Feng、Sophia Simeng Han、Jinghui Lu、Yingjian Chen、Yusuke Iwasawa、Yutaka Matsuo、Chanjun Park、Rex Ying、Irene Li。初版于 2026 年 3 月 17 日发布,随后在 5 月和 8 月进行了两次修订。
Omanic 是一个四步推理的开放域基准测试。"开放域"这个词在这里是关键:模型不是从现成列表中选选项,也不是在某个预先准备好的文档里翻找。信息需要自己去找,然后才能从中构建出链条。这种设定更接近真实场景,那里的答案几乎从不躺在一个段落里。
两个语料库而非一个
Omanic 内部有两个不同的数据集,不应把它们混淆。
第一个是 OmanicSynth,10 296 个由机器生成的样本。这是训练材料:可以用作监督,作者正是在它上面检验了逐步推理能力是否能够传递。
第二个是 OmanicBench,967 个经过专家审核并附有手动标注的样本。这是评估部分,它明显更小——这很合理,因为步骤级别的人工标注成本很高。
这种划分不是形式上的。它能够把"模型被训练过"与"模型确实会"区分开来:训练语料庞大且由机器生成,验证语料紧凑且经过精心校验。
逐步标注是如何构建的
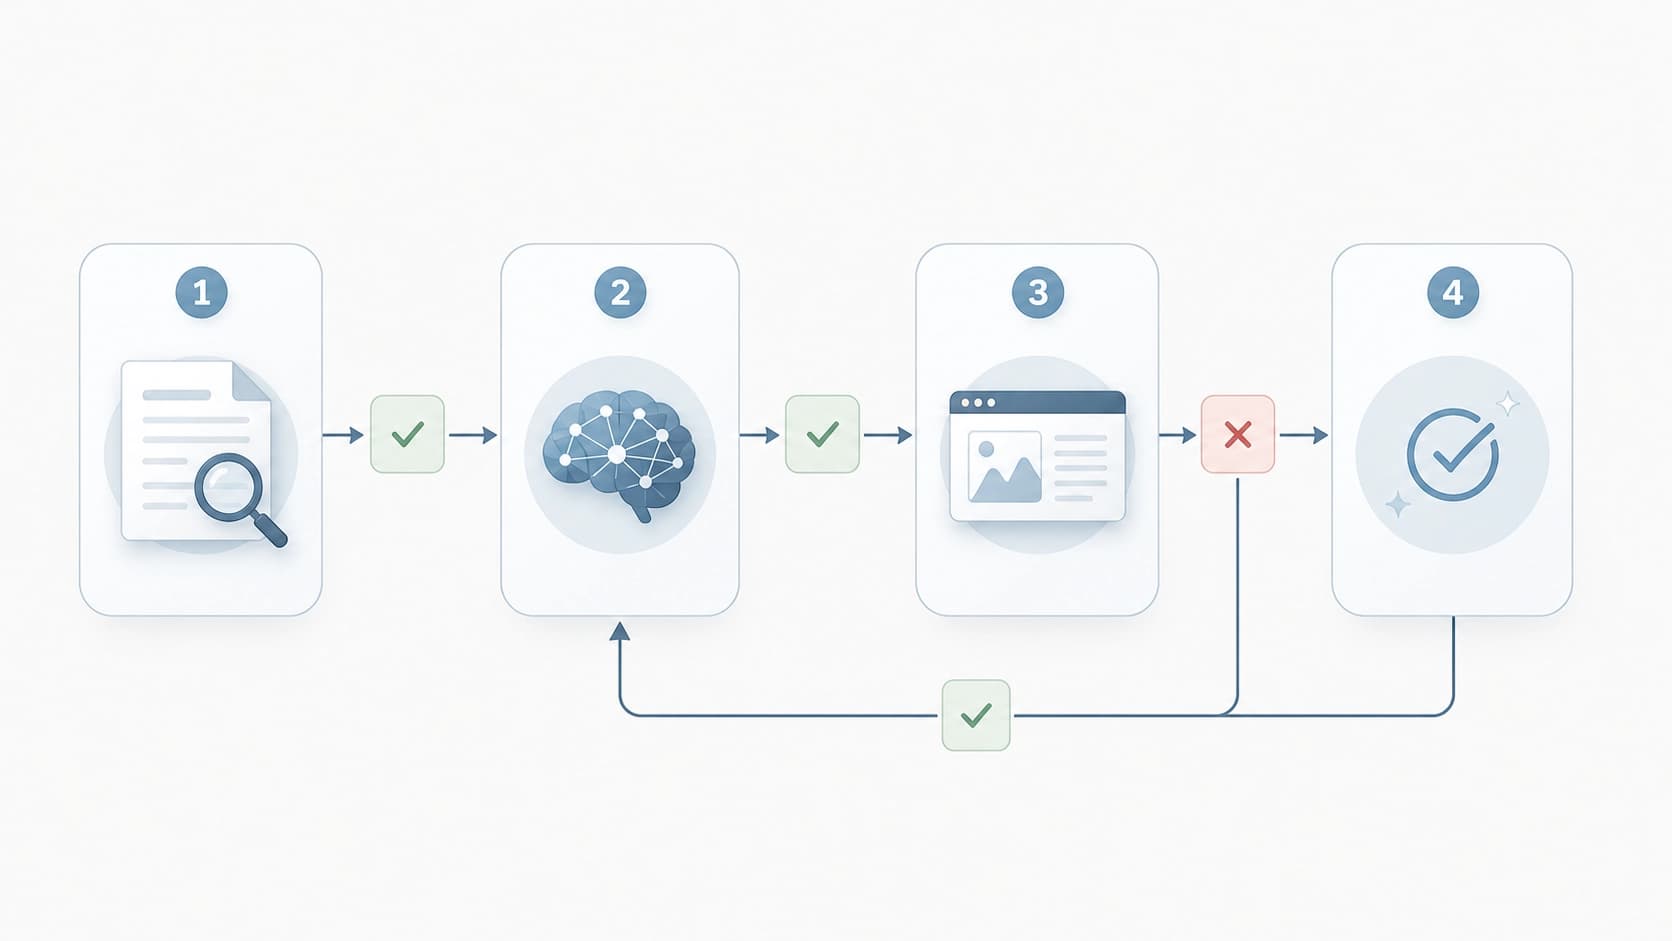
Omanic 与常规 QA 数据集的主要区别在于,每个问题都被拆解成了组成部分。单步子问题、中间答案、结构化的图拓扑——也就是事实之间如何相互关联的图示。
这把评估从一个点变成了一组检查点。现在不仅能看到"模型答对了还是没答对",还能看到"它究竟在哪个转换环节上出了问题"。图结构在这里之所以重要,还因为不同类型的关联对模型来说难度不同:提取对象的一个属性是一回事,追踪四个连续依赖构成的链条则完全是另一回事。
只有逐步分析才能看到的三种诊断
对闭源和开源模型的实验得出了三个最终指标根本无法呈现的观察结果。
后期步骤的瓶颈
作者把第一个结论称为 later-hop bottleneck。说的是主要损失不是累积在开头,而是更靠近链条末端。第一、第二个转换模型通过得相对有把握,但到了第三、第四个就开始崩了。
解释不言自明:链条越长,需要同时保持在运行状态中的中间实体就越多。在后期步骤,模型要处理的已经不是原始问题,而是自己先前推理的结果——那里的任何不精确都会被放大。实际结论对那些喜欢构建长多级流水线的人来说不太愉快:增加第五、第六个步骤的代价可能比想象中更高。
事实知识的"地板"
第二种现象是 factual knowledge floor,即事实知识的"地板"。一部分错误与逻辑完全无关:模型只是不具备所需的事实,而它没有诚实地停下来,反而在空地上继续构建推理。
这是一个重要的区分。当模型在推理上出错——问题出在推理。当它不知道原始事实——问题出在数据,以及它是否会承认无知。后者很难治:如果第一环下面根本没有支撑,那么无论是逐步推理还是更聪明的提示词都帮不上忙。
沿链条传播的错误
第三种诊断是错误沿链条传播。早期的不精确不会停留在局部:它被后续步骤接住,变成一个自信的、表述流畅的、但错误的最终答案。
这里藏着评估的陷阱。一个只错了一次、之后推理连贯的模型,和一个在所有步骤上都崩掉的模型,在最终指标里看起来是一样的——两者都没猜对。逐步分析能把它们区分开,而这正是诊断比最终分数更有价值的情形。
迁移学习:六个基准测试上 7.41 个百分点
一个单独的问题是,这种标注能否不仅用于测量,还用于训练。作者验证了:在 OmanicSynth 上微调,在六个专注于推理和数学的第三方基准测试上带来了提升,平均增幅为 7.41 个百分点。
这个数字需要正确解读。这不是"模型在所有方面都变聪明了"——而是"在分解链条上练就的技能,迁移到了其他类似类型的任务上"。这本身就说明了该基准测试的性质:它不是关于死记硬背具体问题,而是关于训练流程——如何把任务拆解成步骤并保持它们之间的联系。
这对实践意味着什么
从上述内容中可以得出几个结论。
按步骤评估,而不是按结果评估。 如果你的系统构建多步回答,单靠一个最终指标是不够的——它会把性质不同的故障平均成一个含糊的数字。
区分"不知道"和"推导错了"。 这是两种不同的缺陷,治疗方法也不同,但在常规报告中它们被混为一谈。
对长链条要谨慎。 后期步骤是最脆弱的地方。有时把任务拆成几个独立的子任务,比硬推一条长链条到底更明智。
分解也是一种训练信号。 迁移到六个第三方数据集的结果表明,逐步标注不仅作为尺子有效,也作为训练材料有效。
Omanic 不是什么
明确边界是有益的。Omanic 不是对模型智能的通用评估,也不是一次性测试所有东西的测验。它是针对特定任务的工具:展示在开放域多步问题中,推理的哪一环出现了故障。
评估部分的规模——967 个样本——也值得记住:数据集经过精心校验,但并不庞大。训练部分大一个数量级且由机器生成,这提供了规模,但不能替代人工检查。
最重要的是:诊断本身治不好任何东西。知道模型在后期步骤上绊倒——这是起点,不是解决方案。接下来是常规工作:哪里补充数据,哪里简化链条,哪里教模型停下来并说"我不知道"。
作者已将数据和代码公开;该工作可通过 DOI 10.48550/arXiv.2603.16654 获取。


