
MAPLE:在MoE模型各层之间迁移可路由专家的预算,无需修改权重
研究表明,对所有层采用统一的可路由专家数量会系统性地劣于非均匀分配方案,并提出了一种基于层敏感度评估的可插拔机制。在四个MoE模型上,该方法在75%专家预算下优于均匀方案和专家裁剪方案,并在SGLang中将服务延迟降低32.2%,吞吐量提升47.4%。
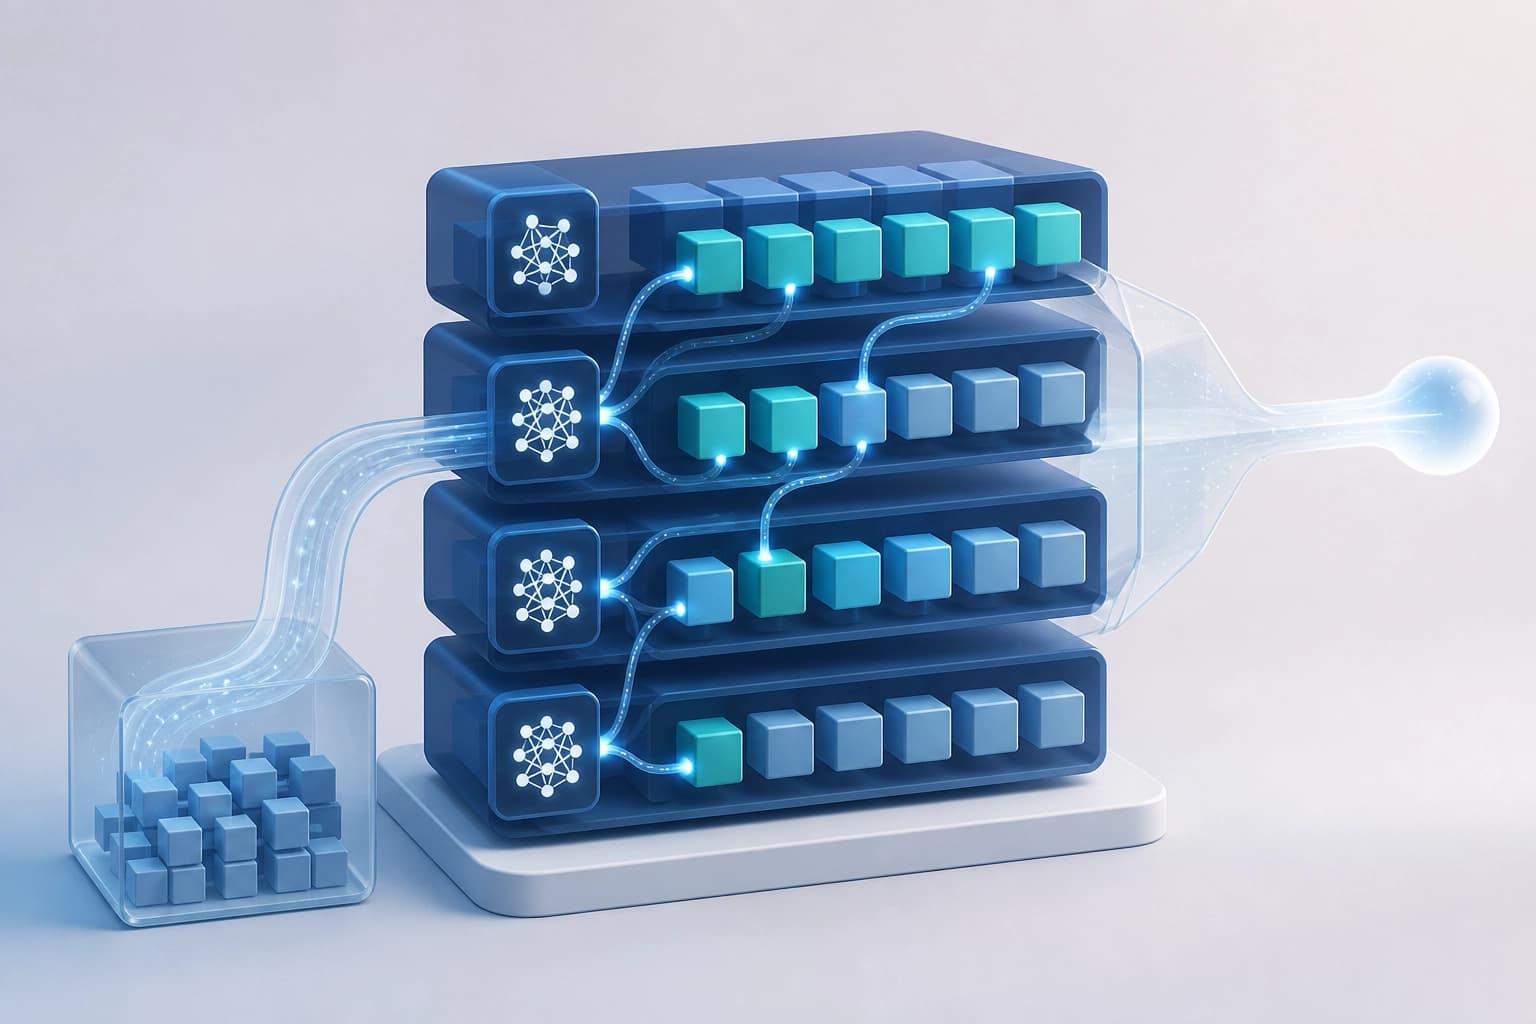
专家预算均等的问题
稀疏激活的 MoE Transformer 在所有层中固定相同数量的可路由专家。这忽略了已被记录的层间冗余异质性。
MAPLE 是一个即插即用框架。它重新分配任意预训练 MoE LLM 各层之间的可路由专家预算。该方法不改变权重,也不需要重新训练。
关键特性:
- 按层异质分配预算。
- 不修改模型权重。
- 无需重新训练。
- 适用于预训练 MoE LLM。
实用标准:当需要在不修改权重和重新训练的情况下改变专家分配时,就需要这种方法。
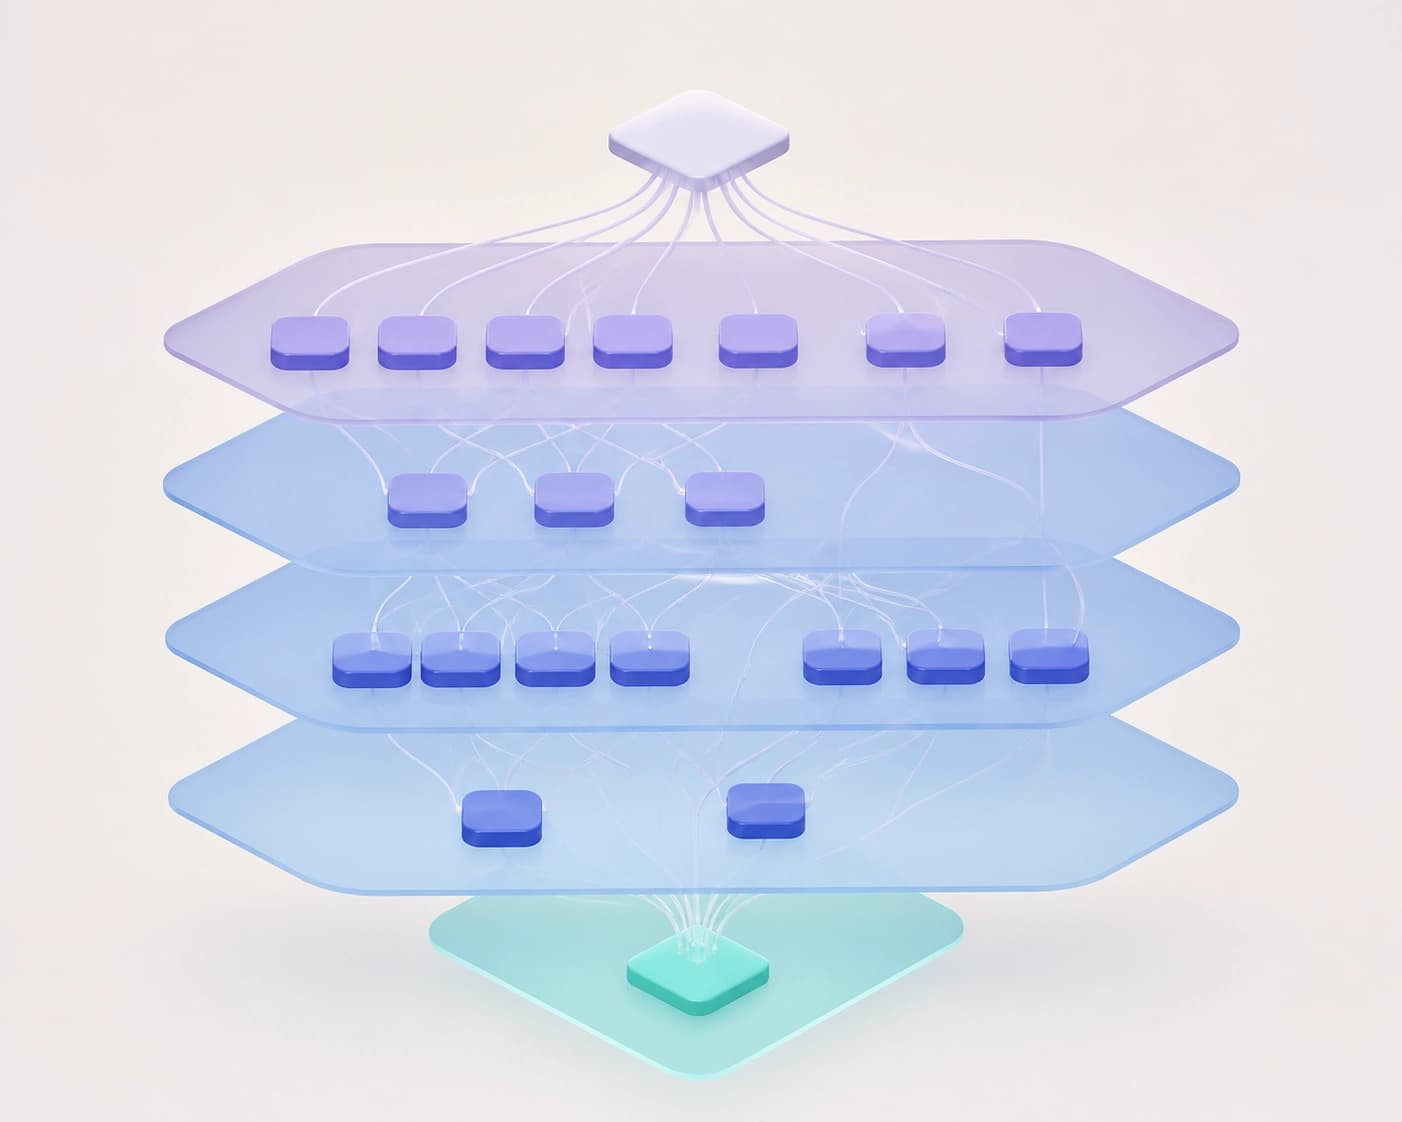
层敏感性与闭式公式
MAPLE 探测每一层。该方法检查层对专家数量变化的反应。敏感性通过三种度量进行量化评估。
预算迁移的步骤:
- 探测每一层。
- 评估对专家数量变化的反应。
- 用三种度量量化评估敏感性。
- 推导解析最优预算分配。
- 通过带敏感性约束的遗传搜索进行细化。
解析分配将容量导向敏感层。在冗余层中,预算削减被吸收。遗传搜索将逐层敏感性作为先验。这带来更快的收敛和更好的分配质量。
结论:预算迁移依赖于可测量的敏感性,而非均等规则。
与均等方法和 pruning 方法的比较
MAPLE 在四个不同规模和架构的 MoE 模型上优于均等和 pruning-based baselines。比较在 75% 可路由专家预算下进行。
| 变体 | 可路由专家预算 | 结果 |
|---|---|---|
| 均等 baseline | 75% | 逊于 MAPLE |
| Pruning-based baseline | 75% | 逊于 MAPLE |
| MAPLE | 75% | 优于两个 baseline |
| 均等 baseline | 100% | 在 DeepSeek-MoE-16B 上于 ARC-E、ARC-C 和 BoolQ 逊于 75% 的 MAPLE |
在 DeepSeek-MoE-16B 上,MAPLE 仅使用 75% 的专家。同时,它在 ARC-E、ARC-C 和 BoolQ 上超过了原始的 100% 均等 baseline。
准确率提升:
- ARC-E:从 65.09 到 71.40。
- ARC-C:从 48.49 到 51.50。
- BoolQ:从 80.03 到 82.38。
结论:异质分配可能比简单启用更多专家更有效。
SGLang 中的服务效率
MAPLE 在 SGLang 中的实现将单 GPU 上的端到端服务延迟降低了 32.2%。吞吐量提升了 47.4%。
该方法不改变权重。因此它可以嵌入现有的 MoE 服务栈。这使预算迁移成为推理的实用杠杆。
实用标准:对于通过 SGLang 进行的单 GPU 服务,该方法可降低延迟并提升吞吐量。
选择标准
在以下几种情况下值得考虑 MAPLE:
- 需要在不重新训练的情况下缩减可路由专家预算。
- 模型是预训练 MoE LLM。
- 需要考虑逐层非均质性,而非均等规则。
- 需要提升 MoE 推理效率。
结论:专家的异质分配成为提升 MoE 效率的原则性和实践性轴心。
常问问题
相关材料
所有材料
通过 SQL 视图检查 LLM 幻觉,无需微调
这项研究考察了 LLM 能否运用一项基础的符号技能——根据源文档构建 SQL 数据库——在幻觉检测中实现无监督的来源归因。在 RAGTruth 和 DiaHalu 上,这种神经符号流程比直接预测更准确,且性能可与先进方法相媲美,无需针对特定领域进行微调。
9 十一月 2026
MathAdv:机器证明的最终准确率隐藏着什么
这套涵盖大学及研究生阶段 13 个数学分支的诊断性任务集,不仅根据最终结果评估 Lean 4 中的机器证明系统,还考察其学科知识、非正式推理质量以及对题目改写的适应能力。分项分析显示,将题目转化为形式化表达仍然是主要障碍,而成功与否在很大程度上取决于数学领域和题目的表述方式。
9 十一月 2026
AffordanceWAM:可供性作为场景预测与机械臂控制之间的桥梁
该工作介绍了一种生成模型,可同时预测未来的 RGB 观测、标量场、可供性热图和机器人的连续动作指令;该模型利用人类视频扩展交互多样性,无需动作标注或动作重定向。在 RoboCasa、CALVIN ABC→D 和真实任务中,该方法相比仅使用 RGB 数据和仅使用机器人数据的基线均取得了稳定提升。
9 十一月 2026