为什么通用草图对页面无效
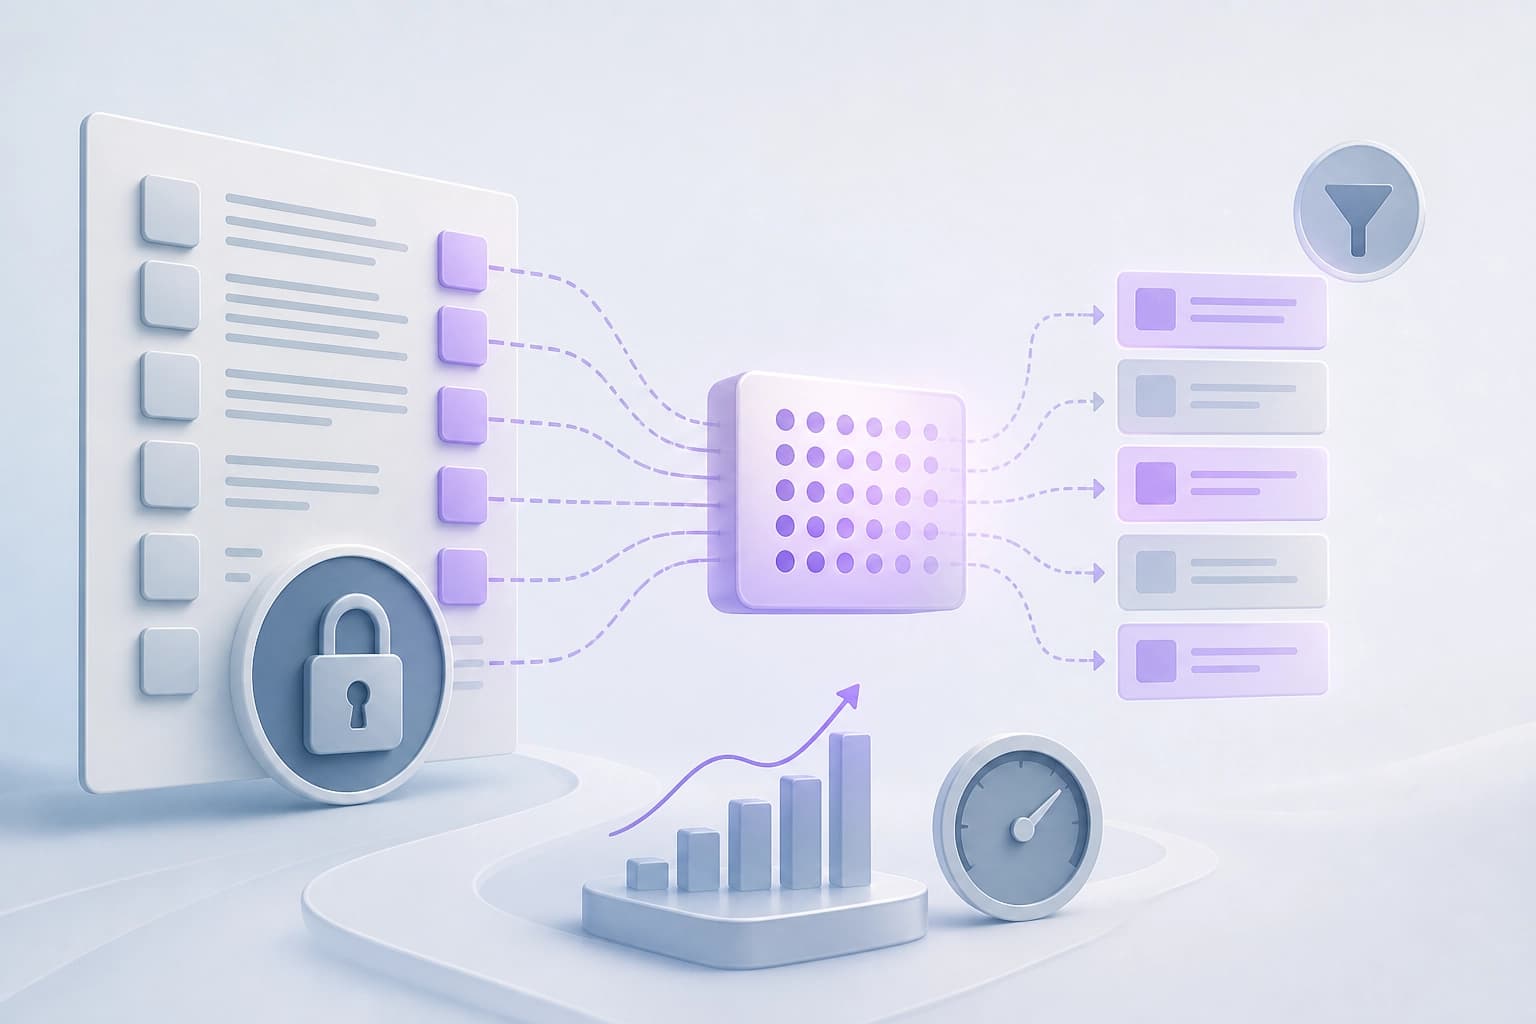
在长上下文上服务大型语言模型受限于键值(KV)缓存。缓存在每个解码步骤都会被完整读取。注意力键在局部是低秩的,尽管在全局是高秩的。一个固定的、对所有页面通用的低秩草图,可证明对页面方向是盲的。
在相同摘要大小下,页面自身的基能更好地对页面进行排序并保留载体。通用草图看不到这些方向。逐键的谱摘要解决了这个问题。
每个页面的谱摘要
LOCKS 为每个页面提供其自身的 rank-r 谱摘要。该摘要是常驻的:在 r=8 时占缓存的十分之一,在 r=2 时占二十五分之一。该方法重建页面内的 logits。它通过 log-sum-exp 估计每个页面的注意力质量。然后只处理排名靠前的页面。
关键要素:
- 名称:Page-Local Compact Key Summaries for Efficient Long-Context Decoding。
- 摘要:每个页面的 rank-r 谱摘要。
- 常驻性:在 r=8 时占缓存的十分之一,在 r=2 时占二十五分之一。
- 重建:页面内的 logits。
- 估计:通过 log-sum-exp 计算页面的注意力质量。
- 选择:仅处理排名靠前的页面。
结论:摘要只占缓存的一小部分,却保留了页面特征。页面选择依据谱数据进行。
不读取键的块选择
选择本身不读取候选的键或值。选择仅依据谱摘要进行。摘要在每个步骤都会被完整扫描。在所述秩范围内,每步的 KV 读取量下降 10–25 倍。
每个 token 的解码延迟减半。在单块 H200 NVL 上处理 1M token 时,r=8 时加速为 2.0×。这是与稠密注意力的比较。选择不依赖于读取候选键。
长任务上的质量
LOCKS 在多种任务类型上保持质量。在长文档问答(LongBench-v1;Llama-3.1-8B)上,结果与完整缓存相差不超过一个点。在检索密集的 RULER 上,该方法在最极小的预算下仍能跟随读取每个键的精确 LSE 预言机。在长文本推理(AIME26、MATH-500;Qwen3-4B)上,该方法在极小预算模式下保持质量的时间最久。基于驱逐的推理选择器和压缩器在那里则会退步。
在 2048 token 的预算下,LOCKS 在 100K+ 上下文(GLM-4-9B-Chat-1M)上与 FullKV 的聚合质量持平。同时该方法只处理 2% 的 token。
| 条件 | 结果 |
|---|---|
| 长文档问答(LongBench-v1;Llama-3.1-8B) | 与完整缓存相差不超过一个点 |
| 检索密集的 RULER | 在极小预算下仍跟随精确 LSE 预言机 |
| 长文本推理(AIME26、MATH-500;Qwen3-4B) | 在极小预算下保持质量的时间最久 |
| 2048 token 预算,100K+ 上下文(GLM-4-9B-Chat-1M) | 与 FullKV 持平,只处理 2% 的 token |
结论:在上述任务上,该方法保持质量的时间比选择器和基于驱逐的压缩器更久。
部署与选择标准
该方法作为即插即用插件提供给未经修改的 vLLM。批量解码在完整的 CUDA 图中运行。无需修改 vLLM。
选择标准:长上下文、有限的 token 预算、需要降低 KV 读取量和解码延迟。如果任务需要在不读取候选键的情况下进行块选择,该方法适用。