
CARAT:检验材料科学大语言模型是在生成结构,还是在复述提示词
本文提出了一种协议,在八种结构呈现方式下固定问题和标准答案,并单独标注 GraphSpace 中的关联。通过成对微调、屏蔽目标字段和添加证据的实验表明,模型能够学会应用关系和遵循链接,但移除链接会使准确率低于启发式遍历方法的水平。
为什么准确率不能证明推理能力
材料科学领域的语言模型可能出于两种不同原因给出正确答案。它要么从结构数据中推导出答案,要么复述输入中已经出现的数值。常规准确率指标无法区分这两种情况。结构描述中可能包含用于评估答案的字段,这时得分反映的只是读取提示。
基准测试 CARAT 围绕这一区别构建。它检验材料科学领域的 LLM 是基于结构数据进行推理,还是复述提示。论文作者为 Jiajun Wu、Jian Yang、Zixiang Ni、Zhenzhu Li 和 Bin Chong;论文于 2026 年 9 月 29 日提交。
实用标准:仅凭结构数据上的高准确率,并不能证明什么。需要关注的是答案是在什么条件下得出的。
配对比较如何进行
八种配对表示中的问题和标准答案保持不变。结构关系则在 GraphSpace 中单独表示。
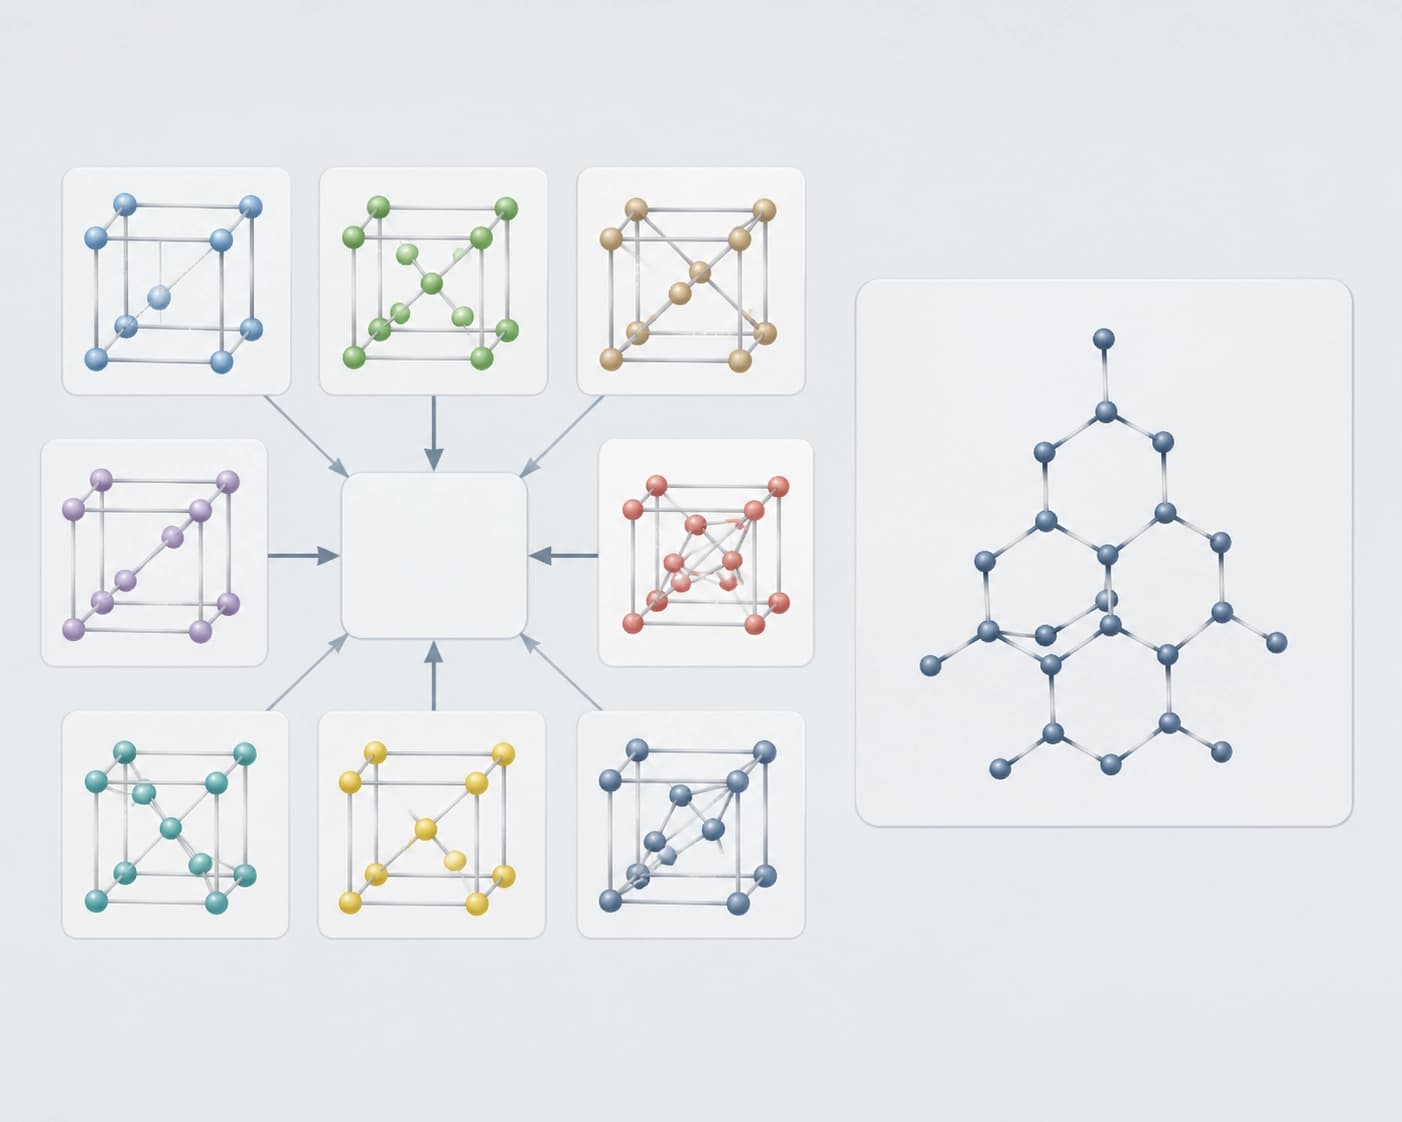
此外,还采用了配对微调、答案遮蔽、证据添加、成对推理,以及允许弃答的规则。
| 比较内容 | 差异 |
|---|---|
| 最难任务类别中,结构化表示与仅输入化学式的对比 | 17.3 分 |
固定问题排除了题目措辞的影响。答案遮蔽则阻止模型直接填入现成数值。
结论:只有在问题和标准答案保持不变时,比较不同表示才有意义。否则,差异反映的是题目文本的质量,而不是模型对结构的处理能力。
GraphSpace 与简单图表示之间的差距有多大
GraphSpace 比简单周期表图高出 19.3 分。这一差距由两种不同的效应构成。
| 条件 | 差异 |
|---|---|
| 简单表示包含回答问题所需的所有信息 | 1.96 分 |
| 简单表示完全不包含这些字段 | 46.7 分 |
当基础表示足以回答问题时,优势几乎消失。而当其中缺少所需字段时,差距就会变大。作者指出,比较中的主要结果反映的是基础表示中的数据不足,而不是证据表示方式的差异。
实用标准:在得出某种表示更优的结论前,先检查其中包含哪些字段。否则,衡量的就是数据完整性,而不是方法。
规避策略与基准测试改进
测试暴露了任务集的一处薄弱环节。一条跳过关系引用、直接读取列表的规则,就能回答七个难化任务类别中的四个。模型可能并未理解这种关系,只是在绕过它。
基准测试经过了改进。十一种此类规避策略的表现都降至接近随机水平。
结论:只有在检查过规避路径之后,任务集才适合用于评估推理能力。如果一条简单规则就能解决部分类别,测到的就不是推理能力。
答案中的引用与对关系的依赖
冻结模型会引用关系,但重定向这条关系后,它在 95.6% 的成对案例中仍给出相同答案。模型只是复述关系,并未使用它。
| 条件 | 答案相同的成对案例占比 |
|---|---|
| 冻结模型,重定向关系引用 | 95.6% |
| 配对训练后,重定向关系引用 | 99.8% |
| 删除关系引用 | 23.4% |
| 最佳规避策略 | 27.0% |
配对训练后,该指标升至 99.8%。删除关系引用后,指标降至 23.4%,低于最佳规避策略达到的 27.0%。作者得出结论:训练可以教会模型使用关系,并依赖关系引用,这两种能力都能习得。
标准:引用关系不等于使用关系。应检查重定向和删除关系引用时模型的表现。
这对工具评估意味着什么
- 检查输入中是否包含问题的现成答案。
- 关注重定向和删除关系引用后的表现,而不只是引用情况。
- 要求说明控制条件:问题、标准答案保持不变,并采用多种表示。
- 确认任务集是否在检查规避策略后进行了更新。
- 结合数据构成评估所声称的差距,而不要只看单个数字。
选择标准:如果结果不能用提示中存在所需字段或简单规避规则的作用来解释,那么它才值得信赖。
常问问题
相关材料
所有材料
转向概率单纯形可缩小对比式多模态模型中的模态差距
在论文 arXiv:2610.32890 中,作者提出用概率单纯形替代球面嵌入,并加入轻量级 softmax 适配器和总变差相似度。在五个检索基准测试中,模态间的质心 ℓ2 距离降低了 97–99%,同时检索质量保持不变或有所提升。
3 十一月 2026
ActionRAG 如何在 LLM 智能体的记忆图扩散过程中重新审视证据
提出了一种图式记忆架构,在索引阶段谨慎协调实体,并在查询时依据局部结构重新评估关联。在 MemoryAgentBench 上,该方法的平均准确率达到 55.1,比最强检索基线高 5.4 个百分点,且每次查询的合成成本很低。
3 十一月 2026
十五家公司支持 MDK Tether,实现挖矿自动化
设备制造商、矿池和运营商已着手基于 Tether 开放工具集开发集成,以统一设备监控和管理;AI 代理 QVAC 已在此基础上运行。目前尚未发布有关降低电力成本或提高效率的独立验证。
2 十一月 2026