问题:AR 的局部贪心与 DLM 因果性不足
自回归模型容易陷入局部贪心。扩散语言模型往往缺乏用于推理的严格因果结构。
| 模型类型 | 局限性 |
|---|---|
| AR | 局部贪心 |
| DLM | 缺乏用于推理的严格因果结构 |
结论:推理需要一种将生成与因果约束相结合的机制。实践标准:检查模型在中间步骤中如何保持逻辑结构。
框架及其任务
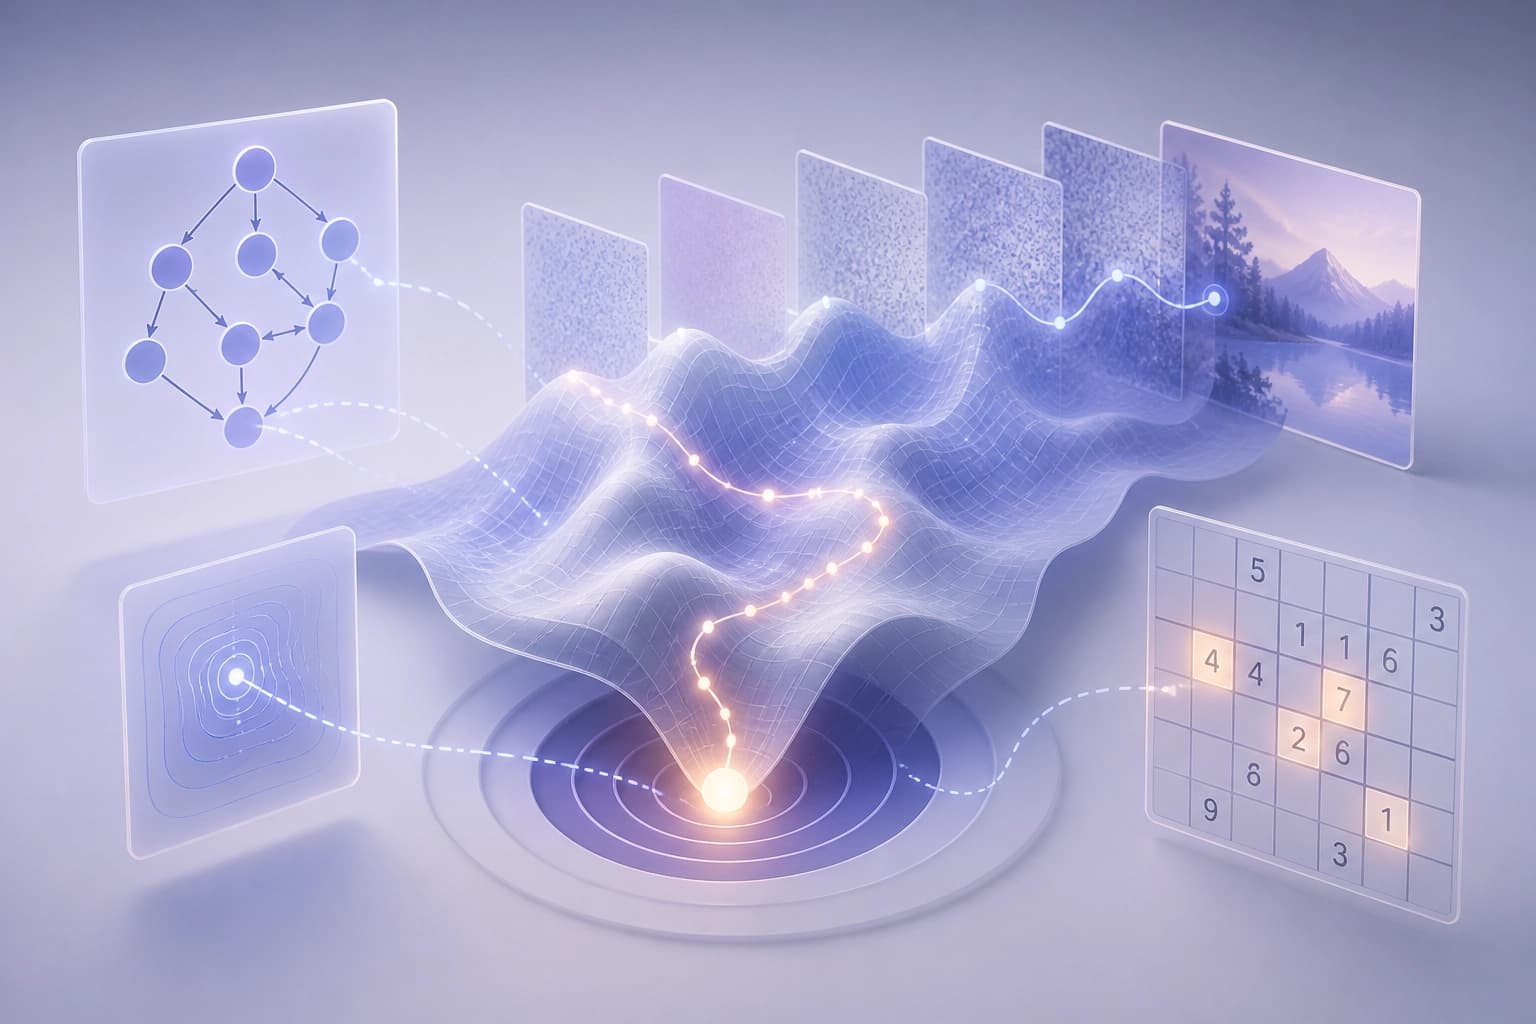
CaLR 是一个用于实现扩散模型稳健推理的框架。它将推理表述为受约束的潜在优化。全称:“CaLR: Causal Latent Revision for Robust Diffusion Reasoning”。作者:Wei Cai, Jian Zhao, Yuchen Yuan, Xuelong Li。提交日期:2026年9月17日。
结论:CaLR 将稳健推理与潜在表示优化相结合。实践标准:如果任务需要推理中的因果结构,就选择该方法。
方法组成部分
CaLR 使用三个要素。第一是因果拓扑矩阵(CTM)。该矩阵由专家模型提供。第二是隐式微分。第三是梯度引导的“思维修订”。
因果拓扑矩阵(CTM)
CTM 是因果拓扑矩阵。它由专家模型提供。
隐式微分
CaLR 使用隐式微分。
梯度引导的“思维修订”
此操作旨在确保逻辑一致性。它还旨在并行生成期间动态自我修正中间步骤。
结论:CTM 提供因果结构,隐式微分参与优化,思维修订则修正步骤。实践标准:检查因果结构的来源和修正机制是否具备。
所声称的结果
CaLR 在复杂基准测试中实现了 DLM 的 SOTA 性能。该框架优于强大的 AR 基线。在 Sudoku 等带约束的任务中,它展现出更强的稳健性。
| 属性 | 结果 |
|---|---|
| DLM 性能 | 在复杂基准测试中达到 SOTA |
| 与 AR 的比较 | 优于强大的 AR 基线 |
| 稳健性 | 在带约束的任务中稳健性更强,例如 Sudoku |
结论:所声称的优势涉及复杂基准测试和带约束的任务。实践标准:根据带约束任务中的稳健性来匹配任务需求。对于其他场景,数据摘要中没有相关信息。