
AffordanceWAM:可供性作为场景预测与机械臂控制之间的桥梁
该工作介绍了一种生成模型,可同时预测未来的 RGB 观测、标量场、可供性热图和机器人的连续动作指令;该模型利用人类视频扩展交互多样性,无需动作标注或动作重定向。在 RoboCasa、CALVIN ABC→D 和真实任务中,该方法相比仅使用 RGB 数据和仅使用机器人数据的基线均取得了稳定提升。
模型是什么
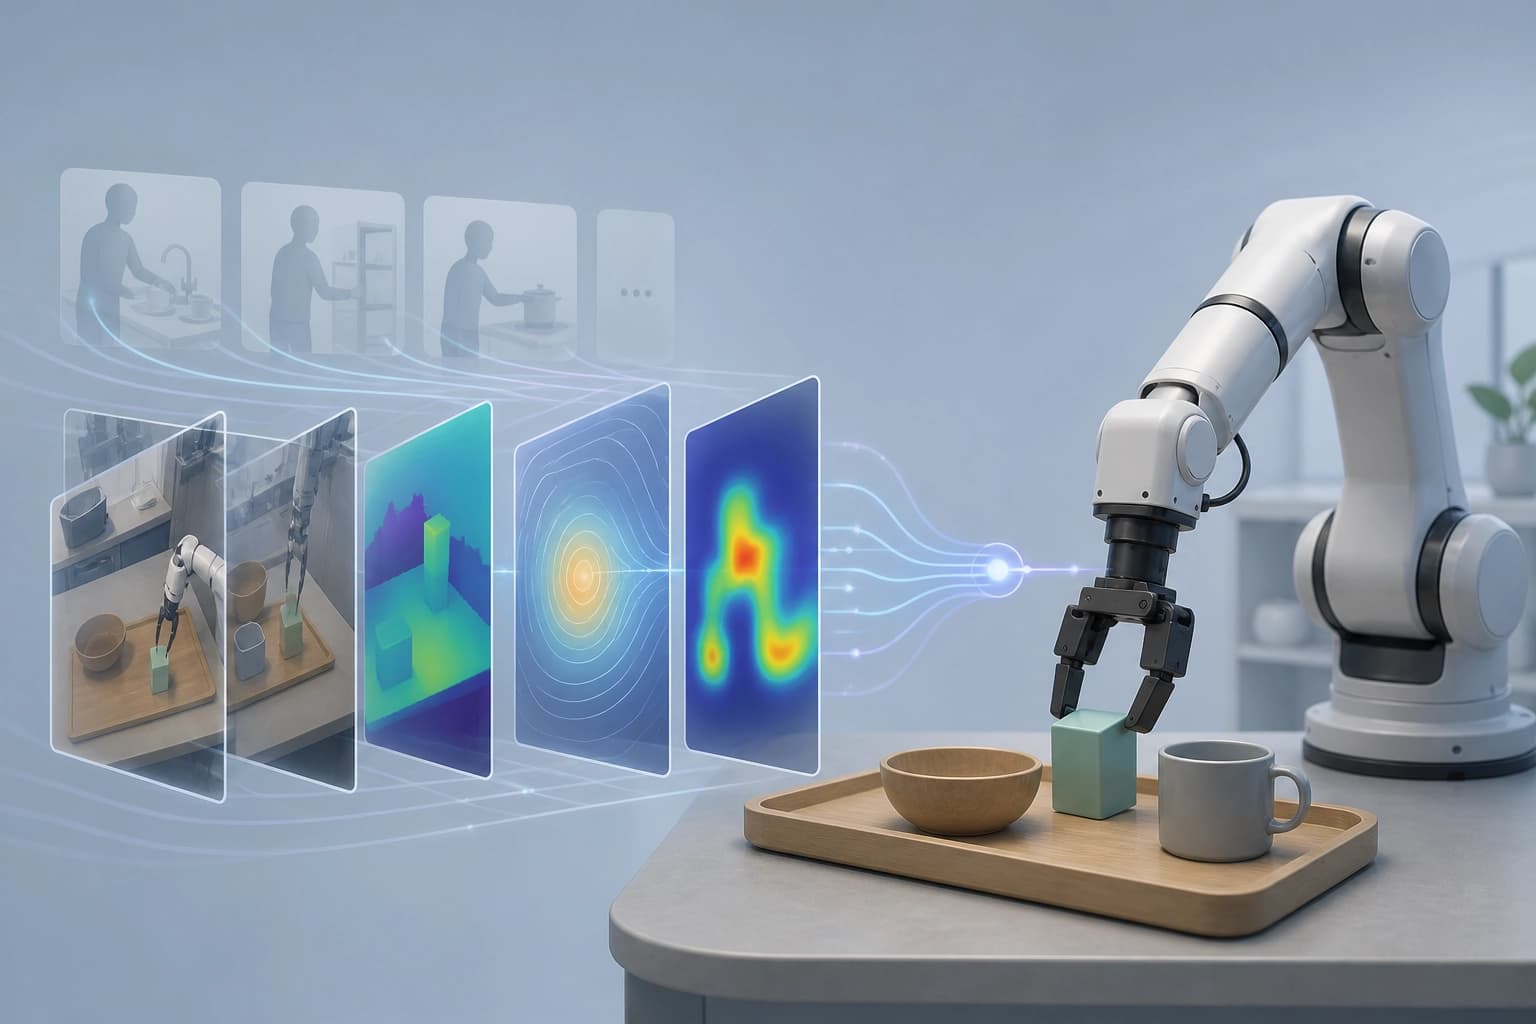
arXiv 论文 2609.22332 介绍了 AffordanceWAM——一种用于机器人操作、考虑可供性的生成式世界动作模型。首个版本于 2026 年 9 月 16 日提交。最新标注版本为 v3,修订于 2026 年 10 月 18 日。该模型表示以物体为中心的时空可供性。它使用两种格式:
- 标量可供性;
- 可供性热图。
这些表示位于生成的未来世界之中。可供性将视觉预测与任务相关物体及交互区域联系起来。它们为人类视频和机器人视频中的交互提供共同基础。由此,可供性成为场景预测与机械臂控制之间的中介。
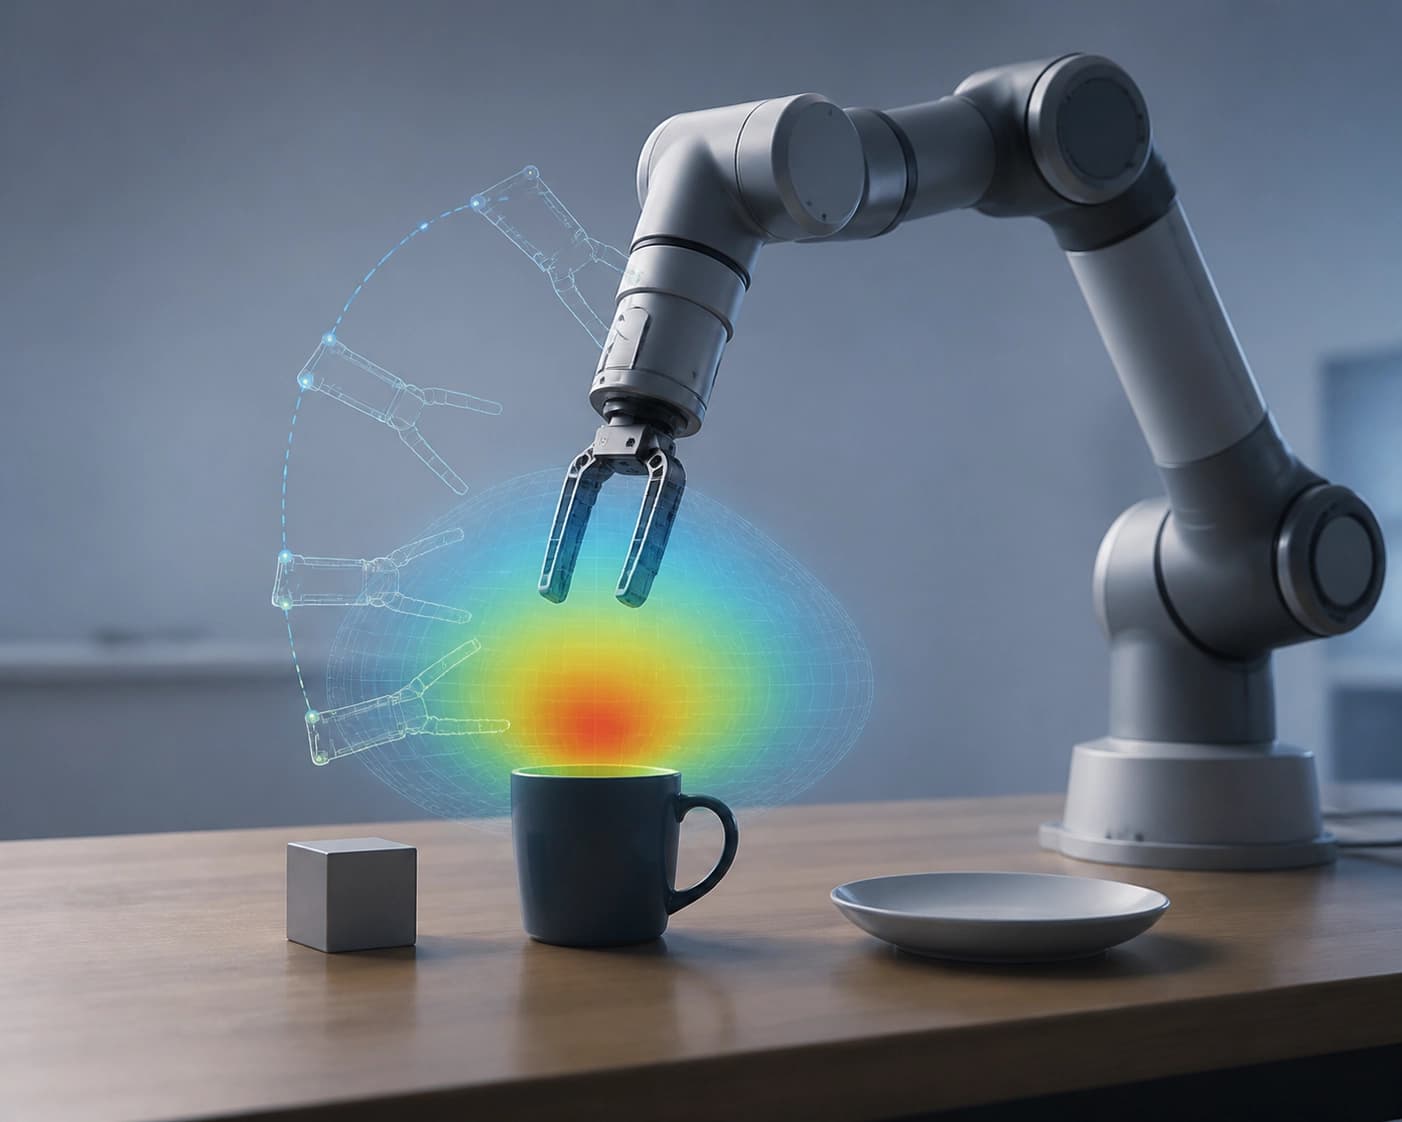
结论:该模型为物体和动作区域提供了明确的格式。这种格式将未来预测与控制联系起来。
架构:两个专家与一个统一目标
AffordanceWAM 以预训练的视频扩散 Transformer 为基础。模型分别对 World Expert 和 Action Expert 进行参数化,并通过 Masked Joint Self-Attention 将二者联系起来。
| 组成部分 | 论文描述的作用 |
|---|---|
| World Expert | 独立参数化的世界专家 |
| Action Expert | 独立参数化的动作专家 |
| Masked Joint Self-Attention | 将 World Expert 和 Action Expert 联系起来 |
| 统一的流匹配目标 | 将 RGB、可供性和动作预测整合起来 |
模型联合预测未来 RGB 观测、标量可供性场、可供性热图以及连续机器人动作。所有这些输出都由统一的流匹配目标整合。专家参数相互独立,不会妨碍联合训练。它们之间的联系支持世界与动作的联合预测。
结论:该架构将世界与动作的参数分开,同时通过 Masked Joint Self-Attention 和共同目标保留联合预测能力。
基于人类视频和机器人轨迹的训练
AffordanceWAM 的训练使用人类视频来监督未来世界的全部三个流。机器人轨迹则额外提供动作监督。迁移不需要人类动作标签或重定向。
| 数据来源 | 对训练的作用 |
|---|---|
| 人类视频 | 训练未来世界的全部三个流 |
| 机器人轨迹 | 额外提供动作监督 |
可供性为人类视频和机器人视频中的交互提供共同基础。因此,可以在不使用人类动作标签的情况下利用人类视频。作者称,可供性是视觉—语言—动作和技能从人到机器人迁移的高效接口。
结论:可供性为人类视频和机器人视频提供了共同接口,因此无需人类动作标签或重定向。
实验:性能提升与数据依赖性
作者在 RoboCasa、CALVIN ABC→D 和真实世界的操作任务中测试了 AffordanceWAM。实验显示,与仅使用 RGB 或仅使用机器人数据的基线方法相比,该模型取得了稳定提升。
在 RoboCasa 上,随着经可供性标注的人类视频数量增加,结果持续提升,同时机器人监督数据量保持不变。这一效果表明,可供性对训练有所贡献。
| 条件 | 论文报告的结果 |
|---|---|
| 仅使用 RGB 的基线 | AffordanceWAM 稳定提升 |
| 仅使用机器人数据的基线 | AffordanceWAM 稳定提升 |
| 在机器人监督数据量固定时增加带可供性标注的人类视频 | RoboCasa 上的表现持续提升 |
实际选择时,一个参考标准是带有可供性标注的人类视频数量。在机器人监督数据量固定的情况下,增加这类视频的数量会使 RoboCasa 上的表现持续提升。
常问问题
相关材料
所有材料
通过 SQL 视图检查 LLM 幻觉,无需微调
这项研究考察了 LLM 能否运用一项基础的符号技能——根据源文档构建 SQL 数据库——在幻觉检测中实现无监督的来源归因。在 RAGTruth 和 DiaHalu 上,这种神经符号流程比直接预测更准确,且性能可与先进方法相媲美,无需针对特定领域进行微调。
9 十一月 2026
MathAdv:机器证明的最终准确率隐藏着什么
这套涵盖大学及研究生阶段 13 个数学分支的诊断性任务集,不仅根据最终结果评估 Lean 4 中的机器证明系统,还考察其学科知识、非正式推理质量以及对题目改写的适应能力。分项分析显示,将题目转化为形式化表达仍然是主要障碍,而成功与否在很大程度上取决于数学领域和题目的表述方式。
9 十一月 2026
将演示文稿编辑转化为可控操作:EditPPT 框架与 DeckEdit-Bench 基准测试
作者将幻灯片编辑拆解为针对具体对象的操作、允许执行的动作,以及对其他内容是否保持原样的检查,而非自由生成代码。为衡量质量,作者创建了 DeckEdit-Bench(涵盖 28 份人工制作的演示文稿中的 183 项任务);在五种基础模型上,多智能体方案 EditPPT 的任务成功率为 66.7–74.9%,内容保留率超过 97%。
8 十一月 2026