
Novo benchmark SemComp-Bench verifica se modelos de vídeo concluem a tarefa até o resultado final
Pesquisadores apresentaram um conjunto de dados e uma metodologia para avaliar a geração de vídeos com base na execução semântica de tarefas: o modelo não deve apenas criar um vídeo plausível, mas alcançar o resultado desejado e manter uma conexão semântica com a referência. Os primeiros experimentos mostram que essa ainda é uma tarefa desafiadora para os modelos de vídeo atuais.
Execução semântica da tarefa: um novo olhar sobre a geração de vídeo
Os modelos modernos de geração de vídeo lidam muito bem com comandos curtos como "gato brincando com um novelo de lã" — o resultado é bonito e parece real. Mas será que o sistema realmente entende qual resultado o usuário deseja? Pesquisadores da China propuseram o benchmark SemComp-Bench, que verifica não apenas a qualidade visual, mas se a tarefa foi executada em termos de significado.
O grupo de autores liderado por Keyu Tu (oito pesquisadores no total) apresentou no arXiv um artigo descrevendo o SemComp-Bench. O trabalho foi publicado em 18 de agosto de 2026 e pertence às áreas de visão computacional e inteligência artificial. Um novo conceito é introduzido — Semantic Task Completion Video Generation, ou seja, geração de vídeo com execução semântica da tarefa. O sucesso aqui é determinado não pela suavidade do movimento dos objetos nem pela correspondência quadro a quadro com a referência, mas sim pela obtenção do resultado solicitado e pela manutenção da conexão semântica com a amostra.
A ideia-chave é o "ancoramento semântico" (semantic grounding). O modelo não deve apenas copiar a imagem, mas compreender o significado de alto nível da tarefa: por exemplo, se a imagem de referência mostra uma mesa posta e a instrução pede para "adicionar uma chaleira", então no vídeo final a chaleira deve aparecer sobre a mesa. Não é necessário mostrar cada etapa intermediária nem criar uma cópia quadro a quadro da amostra — apenas a cena final e sua conformidade com a tarefa são importantes.
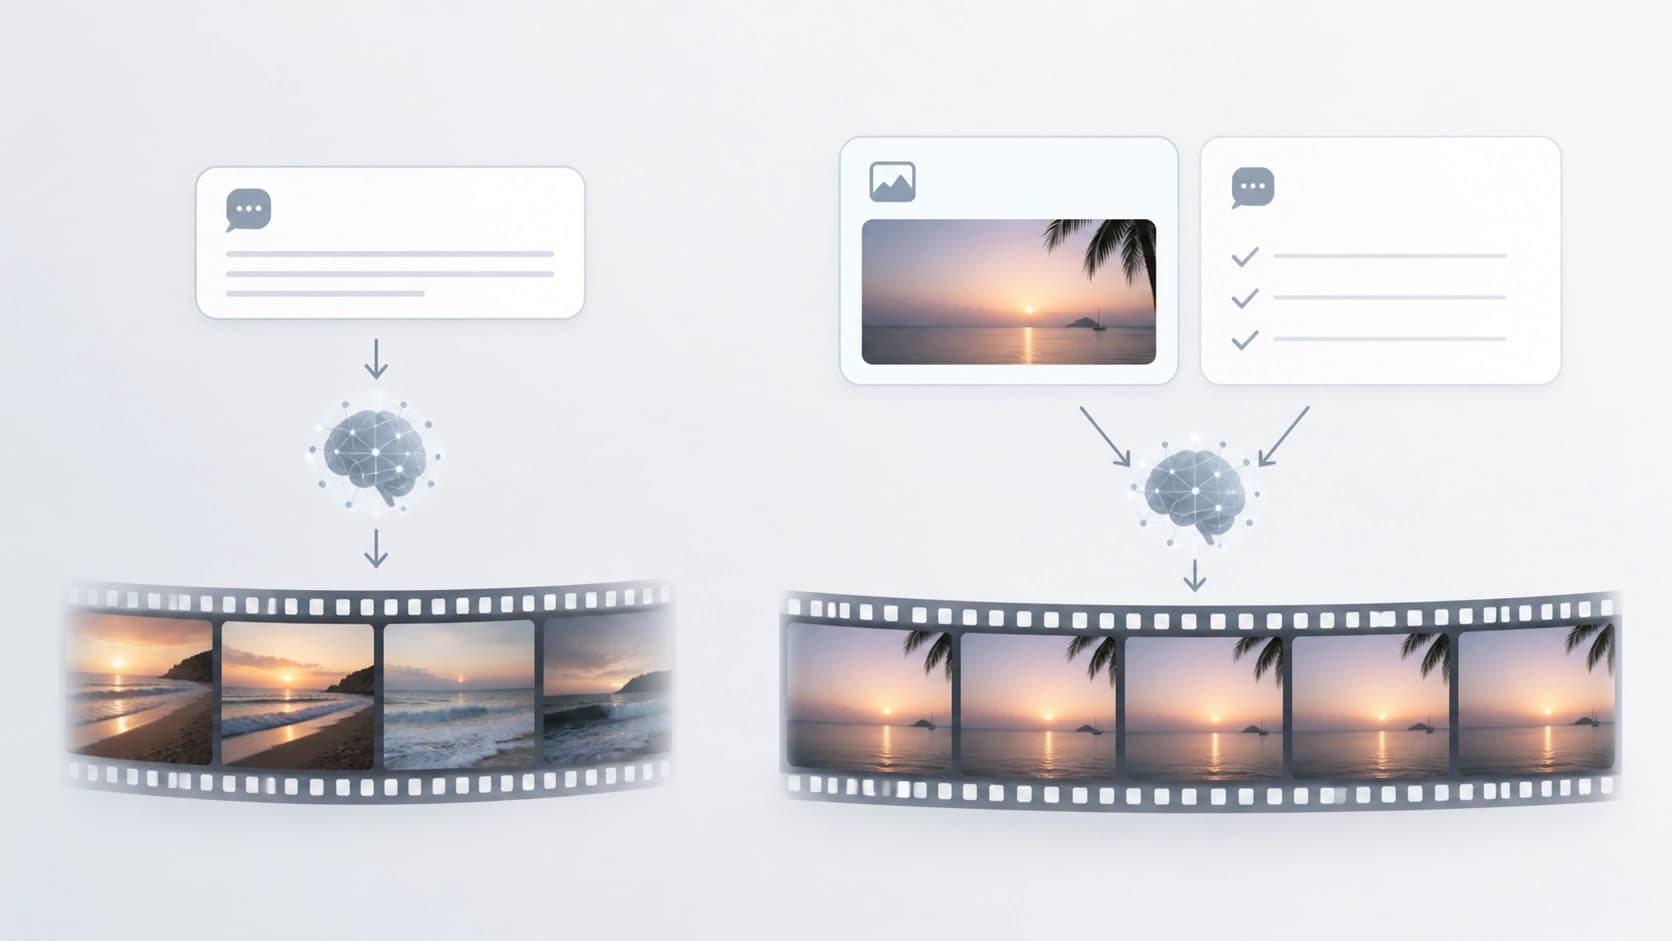
Como os dados e a avaliação do SemComp-Bench são estruturados
Para uma verificação sistemática, os autores criaram o conjunto de dados SemComp-Data. Ele inclui exemplos de seis áreas diferentes — assim, os autores buscaram cobrir o espectro mais amplo possível de cenários. Cada elemento do conjunto contém:
- uma imagem de referência (o que deve ser obtido ao final);
- uma instrução detalhada com especificações;
- uma instrução curta — a variante que tem mais probabilidade de aparecer em uma solicitação real;
- um clipe de vídeo final, demonstrando o resultado esperado.
Para preparar os dados, os pesquisadores construíram um pipeline de quatro etapas. Ele transforma vídeos brutos em instâncias padronizadas do SemComp-Data. Essa automação permitiu escalar o conjunto de dados sem anotação manual de cada vídeo.
A avaliação no SemComp-Bench é estruturada em torno de um vision-language model (VLM). O modelo responde a perguntas binárias estruturadas — ou seja, para cada pergunta há uma resposta inequívoca "sim" ou "não". Isso torna a verificação transparente e reproduzível. Com base nos resultados, duas métricas são calculadas:
- OA Score (Outcome Achievement) — se o resultado especificado foi alcançado;
- GR Score (Generation Reliability) — o quão confiavelmente o modelo reproduz a solução, mantendo a conexão com a imagem de referência.
Em essência, a primeira métrica responde à pergunta "o que foi pedido foi feito", e a segunda — "isso foi feito precisamente no contexto do exemplo".
O que os primeiros testes mostraram
Os autores executaram vários modelos representativos de geração de vídeo através do benchmark. Descobriu-se que a tarefa de levar a semântica até o fim permanece em aberto. Mesmo os sistemas modernos frequentemente produzem um vídeo que parece de alta qualidade, mas não corresponde à essência da solicitação: a chaleira não aparece, o objeto é trocado por um semelhante, e o resultado apenas remotamente lembra o esperado.
É especialmente difícil para os modelos manter a conexão com a imagem de referência quando a instrução é curta e não contém todos os detalhes. Os OA Score e GR Score acabam baixos, ou seja, o modelo "não entende" a tarefa no nível do significado. Isso confirma: a geração de vídeo hoje é mais sobre "imagem bonita" do que sobre executar uma instrução.
O surgimento do SemComp-Bench desloca o foco nos testes de modelos de vídeo: em vez de avaliar a plausibilidade dos quadros — a verificação de um resultado significativo para o usuário. Se antes os benchmarks perguntavam "o vídeo parece real", agora a pergunta é colocada de outra forma: "a tarefa foi executada". Este é um passo para que os vídeos gerativos se tornem não apenas demonstrações, mas uma ferramenta para resolver problemas práticos.
Os autores publicaram o trabalho na plataforma arXiv sob o número 2608.17426, DOI: https://doi.org/10.48550/arXiv.2608.17426. Os materiais estão disponíveis para estudo, e a própria abordagem de avaliação pode servir de base para as próximas gerações de geradores de vídeo.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Diagnóstico passo a passo de agentes GUI na análise de dashboards: benchmark DashAct
Apresentamos o DashAct — um benchmark com 348 trajetórias verificadas por humanos, que divide o trabalho de agentes GUI com painéis interativos em três etapas e quatro condições visuais. Os resultados revelam problemas persistentes na previsão de ações e na associação a alvos visuais, bem como a dependência das respostas dos agentes do suporte contextual e espacial.
11 novembro 2026
WILSON: integração de ampliações e lâminas de pacientes para análise anatomopatológica e elaboração de laudos
O preprint apresenta o WILSON — um modelo de visão e linguagem que codifica imagens de lâminas inteiras e séries de preparações de um mesmo paciente em diferentes ampliações, em vez de apenas uma lâmina «melhor». Sem ajuste fino para a tarefa, supera modelos especializados e maiores para lâminas em várias métricas, com uma carga computacional substancialmente menor, e as suas descrições diagnósticas receberam avaliações mais elevadas dos patologistas.
11 novembro 2026
Invariantes polinomiais canónicos no diagnóstico de falhas em simuladores de RL: onde são realmente úteis
O estudo avalia se a incorporação de leis físicas em modelos de dinâmica treináveis se justifica: os invariantes extraídos das trajetórias e reduzidos à forma canónica por meio de bases de Gröbner proporcionam ganhos modestos nas previsões, mas são eficazes no diagnóstico — permitem localizar a restrição violada e identificar o parâmetro específico incorreto.
10 novembro 2026