
Cadeia curta de raciocínio — nem sempre a melhor
Modelos grandes, treinados para "pensar em voz alta", ganham vantagem por meio de longas cadeias de raciocínio. Quanto mais complexa a tarefa, mais passos intermediários o modelo escreve antes de dar uma resposta. Um dos mecanismos considerado essencial para essa qualidade é a autorreflexão: a capacidade de olhar para trás, para os passos já dados, perceber um erro e reescrever o curso da solução.
O problema é que essa capacidade tem um custo. Cada ato de revisão representa tokens adicionais na inferência — ou seja, dinheiro, tempo e recursos computacionais. Ao mesmo tempo, até recentemente ninguém explicava direito o que exatamente governa a decisão do modelo de "parar e se reexaminar". A autorreflexão era algo como uma caixa-preta dentro de uma caixa-preta: sabe-se que funciona, mas não se entende como.
O trabalho de Ge Yan, Chung-En Sun, Linbo Liu e Tsui-Wei Weng (arXiv:2512.13979, aceito na COLM 2026) aborda a questão por um ângulo inesperado — não por meio de prompts nem de fine-tuning, mas das representações latentes do modelo.
A direção da reflexão dentro do modelo
O que buscaram e o que encontraram
Os pesquisadores aplicaram à autorreflexão o aparato da representation engineering — uma área que estuda não os textos na saída do modelo, mas suas ativações internas. A lógica é simples: se o modelo "decide" refletir, essa decisão está refletida em algum lugar de suas representações. Logo, é possível encontrá-la, descrevê-la e — o mais importante — usá-la.
E foi o que aconteceu. No espaço latente, descobriu-se uma direção destacada ao longo da qual os passos com reflexão se separam dos passos sem ela. Em essência, é um eixo "reexaminar / não reexaminar", e a posição do ponto nesse eixo distingue de forma consistente os dois tipos de passos.
A reflexão é governada pela incerteza
A observação mais interessante do artigo: a magnitude da ativação ao longo da direção encontrada prediz bem se a resposta final será correta. Em outras palavras, a reflexão não se ativa por acaso nem por cronograma — ela está ligada à incerteza interna do modelo. Quando o modelo "sente" que o terreno é escorregadio, ele freia e revisa; quando tudo está claro, segue em frente.
Esta é uma mudança importante na forma de ver o problema. A reflexão deixa de ser uma capacidade separada, que precisa ser desenvolvida, e passa a ser mais um sinal — um indicador de que o próprio modelo duvida do seu passo.
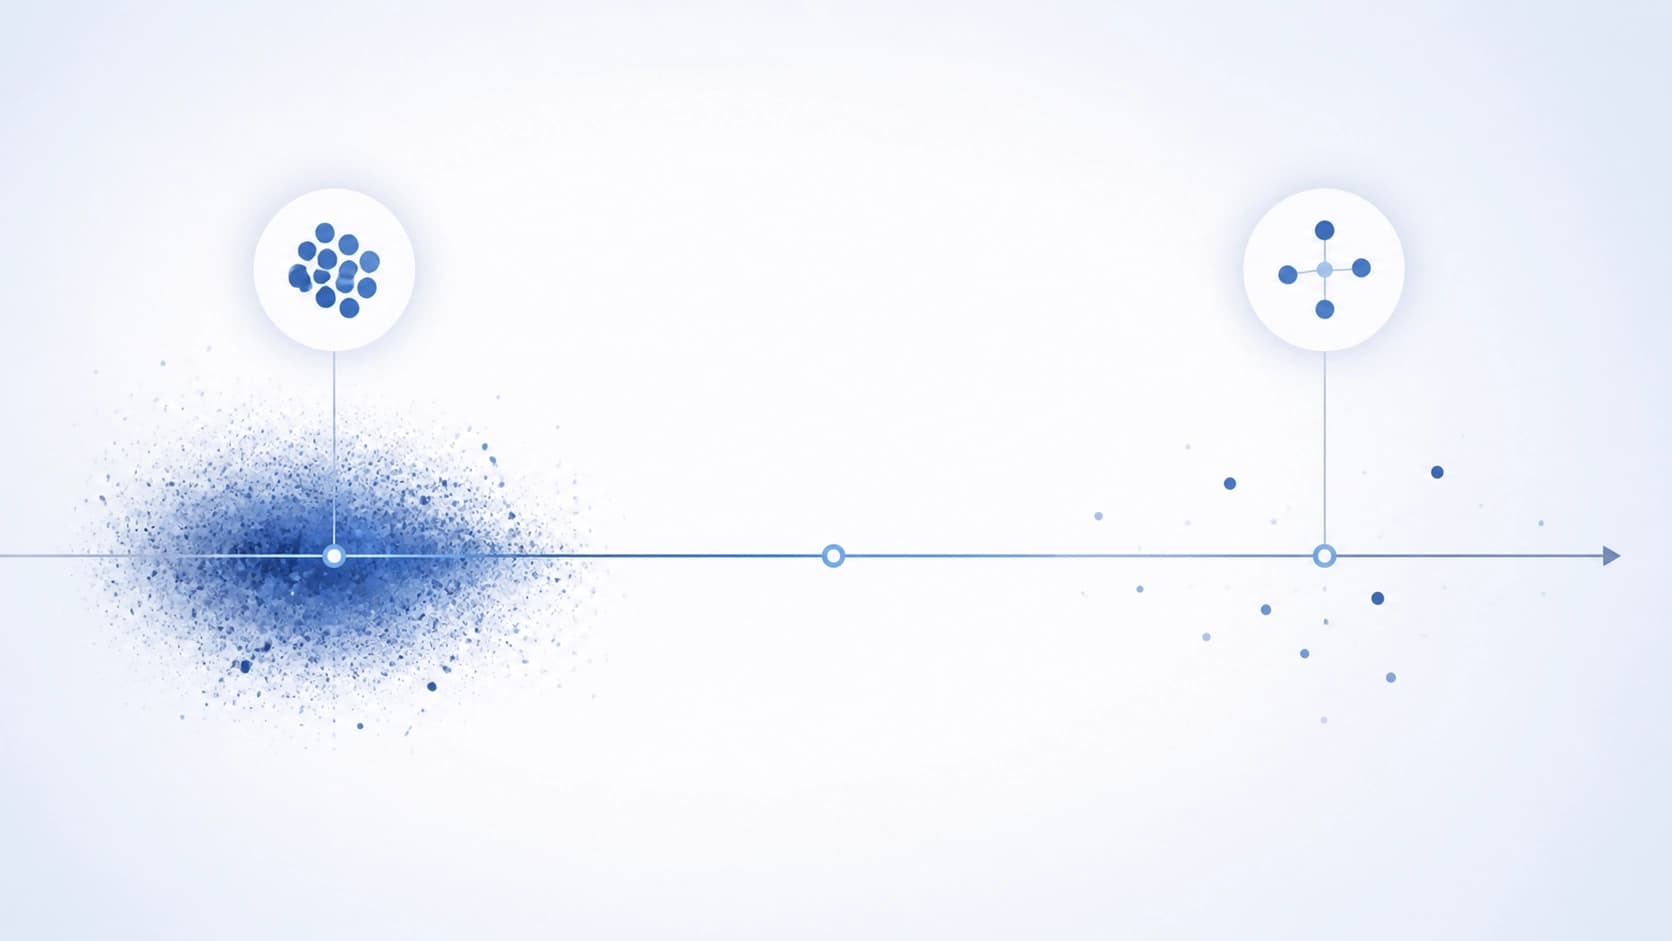
Como o ReflCtrl é estruturado
Se a decisão sobre a reflexão vive nas ativações, é possível influenciá-la diretamente — intervindo nas representações, em vez de reescrever o prompt. É nisso que se baseia o ReflCtrl: um framework que controla a autorreflexão por meio de steering — o deslocamento das ativações ao longo da direção encontrada.
O detalhe-chave — quando exatamente intervir
A abordagem ingênua é óbvia: adicionar o deslocamento desejado a cada token gerado. Foi a primeira coisa que veio à mente — e é justamente ela que funciona mal. A pressão constante sobre as representações dilui a qualidade da geração: o modelo perde coerência, porque a intervenção acontece também onde ela não faz sentido.
Os autores propõem uma variante por passo (step-level). A intervenção é aplicada exatamente uma vez — bem no início de cada novo passo de raciocínio. Depois, o modelo gera os tokens desse passo livremente, sem interferência. O resultado é um ajuste fino: a frequência da reflexão muda, mas o próprio fluxo de pensamento dentro do passo permanece intacto.
É justamente essa combinação — intervenção rara e pontual em vez de contínua — que traz o principal ganho.
O que os experimentos mostraram
Os testes foram realizados em benchmarks de raciocínio matemático e geral. Os resultados levam a uma conclusão bastante incômoda para a indústria: a reflexão é frequentemente excessiva.
- É possível reduzir o número de tokens de raciocínio em até 43,2% do volume original — mantendo a precisão.
- O efeito é especialmente notável em modelos mais fortes: quanto melhor o modelo, mais frequentemente ele se reexamina sem necessidade.
- O steering por passo supera consideravelmente o tradicional por token com orçamentos de tokens comparáveis.
O segundo e o terceiro pontos estão relacionados. Um modelo forte é mais confiante em seus passos, por isso sua reflexão acaba sendo, com mais frequência, um esforço em vão — e o steering por token sofre exatamente por não saber parar a tempo.
Por que isso importa fora do laboratório
A economia do raciocínio não é abstração. Cadeias longas inflam as contas de inferência, aumentam a latência e limitam quantas requisições podem passar pelo hardware disponível. Se quase metade do "pensamento" pode ser removida sem perda de qualidade, isso é economia direta em escala.
Há também uma camada menos óbvia. O trabalho mostra que o comportamento do modelo pode ser ajustado no nível das representações — de forma mais suave e precisa do que com prompts, e mais barata do que com fine-tuning. A controlabilidade torna-se uma dimensão de engenharia à parte: não "o que escrever na instrução", mas "para onde deslocar a ativação e em que momento".
Por fim, é uma contribuição para a interpretabilidade. Entendemos cada vez melhor o que exatamente acontece por dentro quando o modelo para e diz a si mesmo "vou reexaminar".
Questões em aberto
Os limites de aplicabilidade ainda não estão totalmente delineados. O steering ao longo de uma única direção é uma ferramenta estreita: captura bem o eixo de reflexão encontrado, mas o que fazer com outros tipos de autocorreção — não está claro. Permanece também a questão de quão transferível é a direção encontrada entre arquiteturas: cada modelo tem suas próprias representações, e não é certo que um vetor que funciona para um seja útil para outro.
Também não está totalmente claro o compromisso entre economia e confiabilidade em tarefas em que um erro custa caro. Cortar 43,2% dos tokens mantendo a precisão média é um resultado forte, mas precisão média não é o mesmo que ausência de falhas catastróficas raras. Buscar como distinguir a reflexão "supérflua" daquela única que salva a resposta é, provavelmente, a próxima tarefa nessa linha de pesquisa.


