
Neptuna: comparação de arquiteturas de ML em escoamentos multifásicos compressíveis com descontinuidades
Apresentamos Neptuna — um grande benchmark com 3 TB de cálculos para tarefas de colapso de bolhas e fragmentação de gotas sob a ação de ondas de choque, no qual são avaliados modelos convolucionais, espectrais, transformers e modelos de PDE pré-treinados. Conclusão: não há um líder universal, e funções de perda compostas e SoftAdapt ajudam a preservar melhor as interfaces e a reproduzir o espectro com maior precisão.
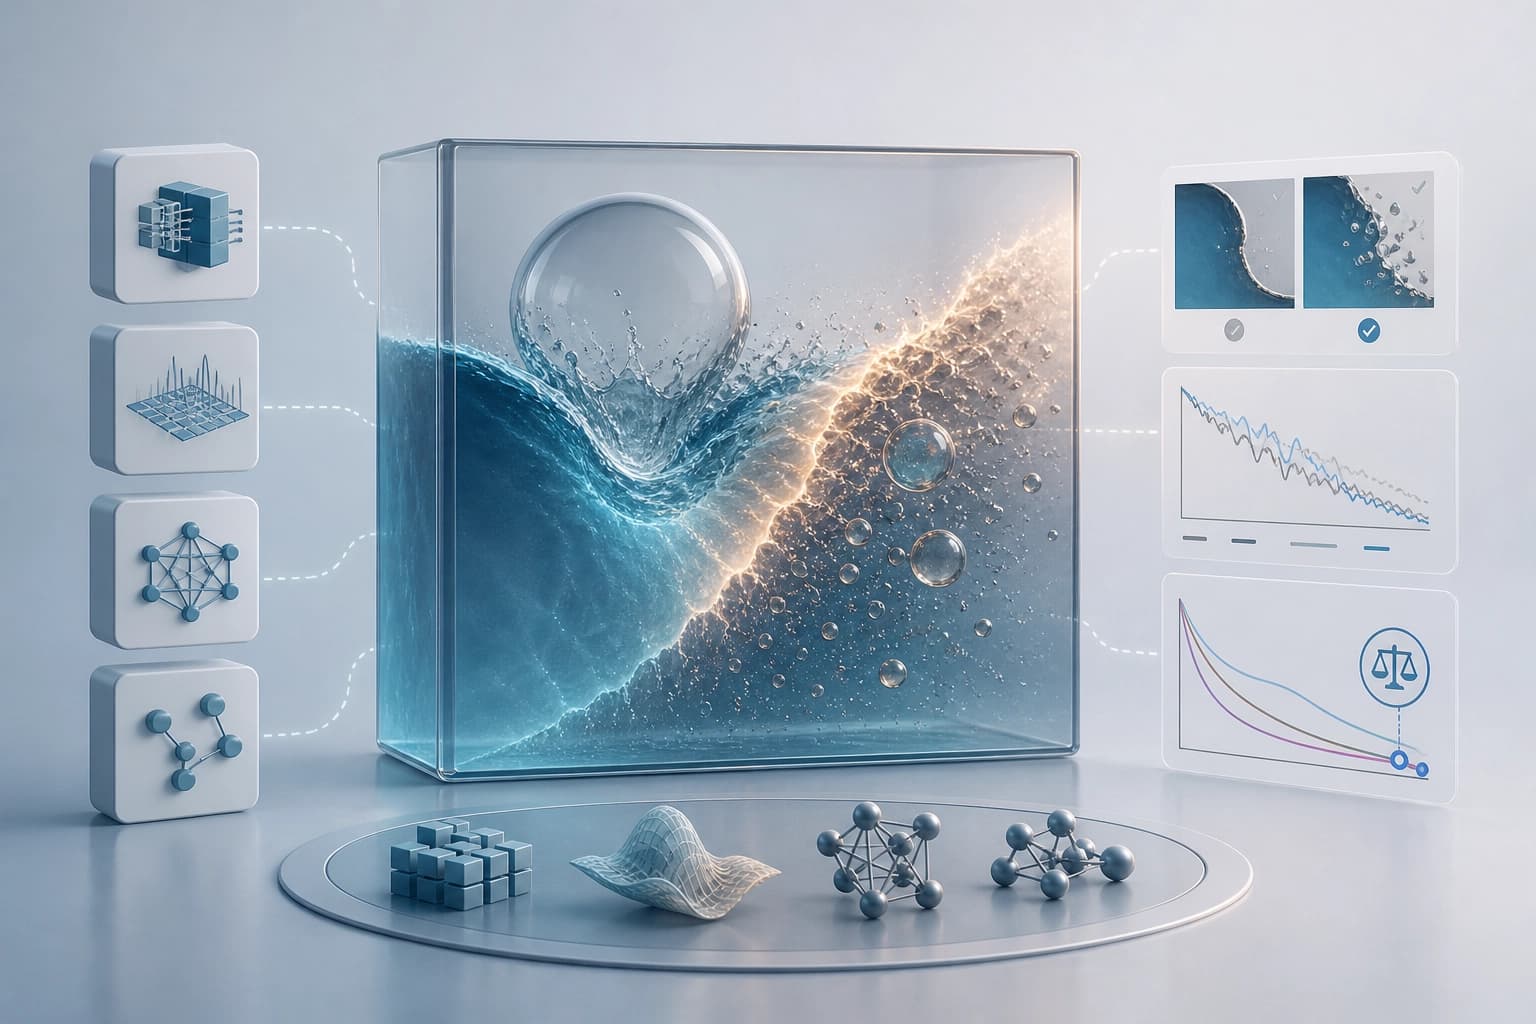
Tarefa do benchmark
Neptuna é o primeiro benchmark de grande escala para escoamentos multifásicos compressíveis excitados por choque. Foi criado para comparar modelos de ML em dados com ondas de choque e interfaces entre materiais. O benchmark avalia não uma única arquitetura, mas a combinação de arquitetura, função de perda e métricas.
| Componente da avaliação | Opções |
|---|---|
| Arquiteturas | convolucionais, espectrais, transformadores, modelos fundacionais de PDE |
| Funções de perda | MSE, funções compostas, SoftAdapt, GradNorm |
| Métricas | pontuais, espectrais, orientadas para características, estruturais, sensíveis à física |
Conclusão: o benchmark estabelece uma plataforma comum para comparação reprodutível. Critério prático: utilizá-lo para comparar modelos com os mesmos dados e métricas.
Dados e física
O benchmark inclui 3 TB de dados de alta precisão em 2D e 3D. Os dados descrevem o colapso de bolhas e a fragmentação de gotas provocados por ondas de choque. Estes escoamentos incluem ondas de choque e interfaces entre materiais.
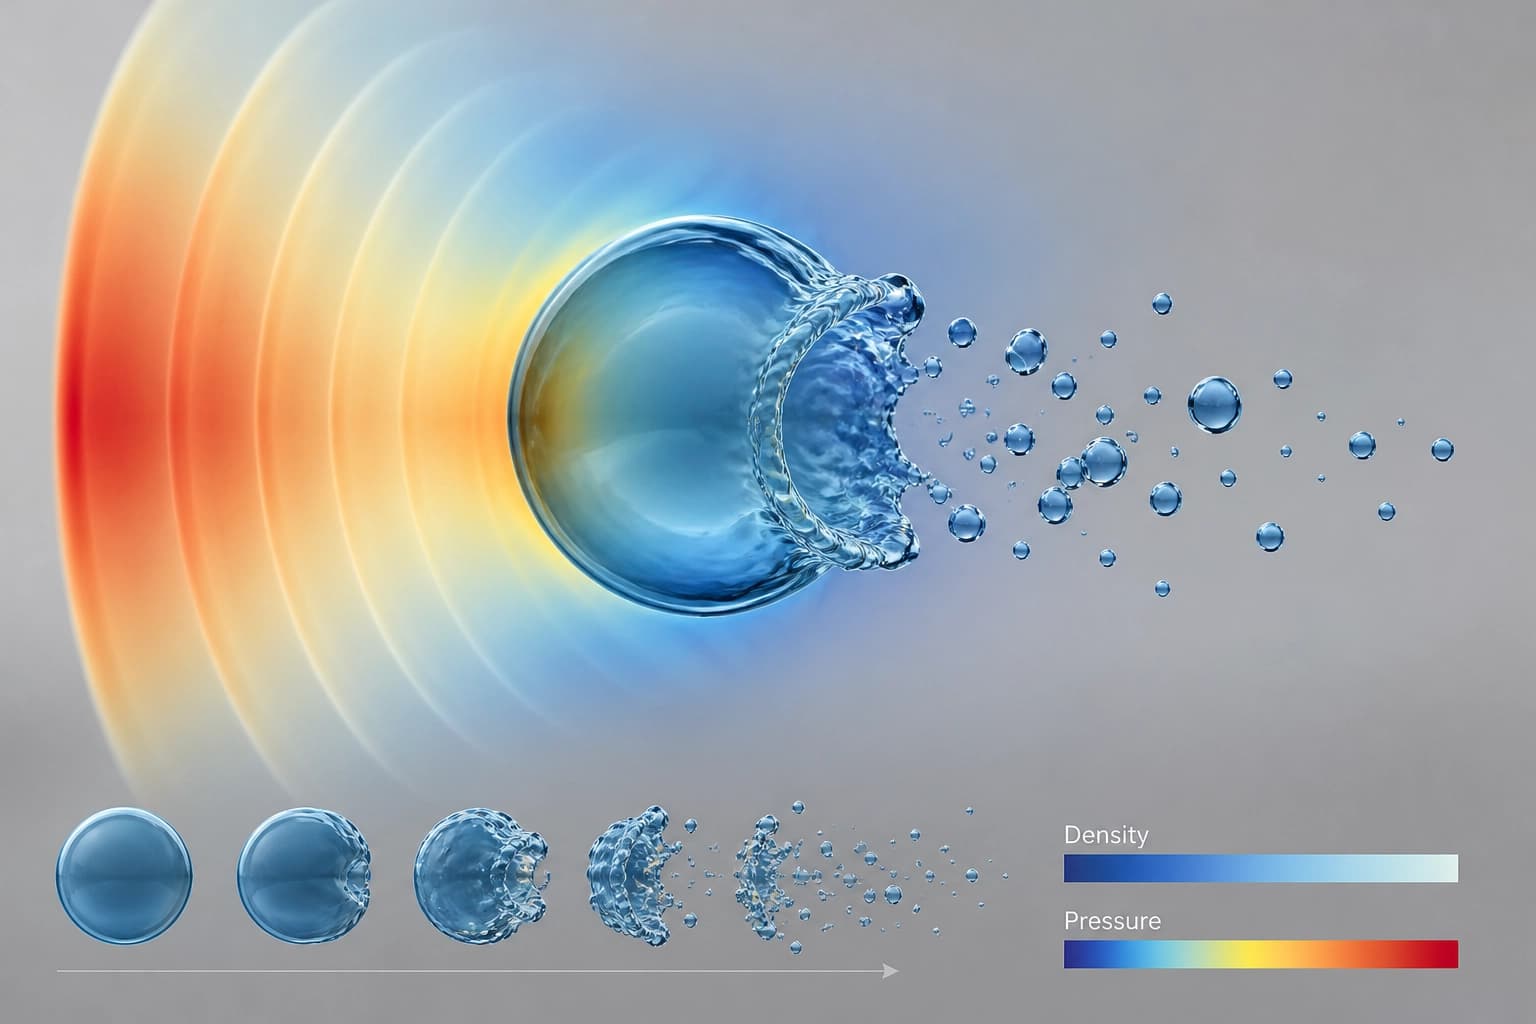
As fortes interações não lineares provocam deformações complexas das interfaces, mistura e dinâmica em múltiplas escalas. Três fatores dificultam a construção de modelos substitutos fiáveis:
- compressibilidade;
- descontinuidades abruptas;
- efeitos multifásicos.
Estes fatores estão presentes em simultâneo.
Conclusão: os dados testam os modelos quanto a descontinuidades e interfaces. Critério prático: incluir no teste cenários com descontinuidades e interfaces.
Arquiteturas comparadas
No benchmark foram avaliados modelos convolucionais, espectrais e baseados em transformadores. A avaliação incluiu também modelos fundacionais de PDE pré-treinados. O benchmark testa estas famílias em escoamentos multifásicos compressíveis com descontinuidades.
A comparação abrange diferentes formas de construir um modelo substituto. Não se limita a uma única família. As arquiteturas são avaliadas com os mesmos dados e métricas.
Conclusão: a arquitetura deve ser escolhida em função da tarefa, não do nome da família. Critério prático: testar a arquitetura no conjunto de dados em que será utilizada.
Funções de perda
O treino padrão no benchmark utiliza MSE. Também foram testadas funções de perda compostas. Estas combinam MSE com componentes de Sobolev, sensíveis às interfaces e sensíveis à estrutura.
Para a ponderação adaptativa das perdas, foram utilizados SoftAdapt e GradNorm. O benchmark inclui ambas as opções.
| Opção | Composição |
|---|---|
| MSE | Função de perda base |
| Funções compostas | MSE + Sobolev + sensível às interfaces + sensível à estrutura |
| SoftAdapt | Ponderação adaptativa das perdas |
| GradNorm | Ponderação adaptativa das perdas |
Conclusão: a escolha da função de perda depende da métrica-alvo. Critério prático: incluir SoftAdapt e GradNorm para testar a ponderação adaptativa.
Métricas de avaliação
A avaliação inclui cinco grupos de métricas:
- pontuais;
- espectrais;
- orientadas para características;
- estruturais;
- sensíveis à física.
O conjunto de métricas é multidimensional. Conclusão: não se deve avaliar um modelo com base numa única métrica. Critério prático: determinar antecipadamente qual o grupo de métricas mais importante para a tarefa.
Resultados da comparação
Nenhum modelo foi o melhor em todos os conjuntos de dados e em todas as métricas. Este resultado diz respeito a diferentes arquiteturas e configurações. As funções de perda compostas melhoram significativamente a preservação das interfaces e a precisão espectral.
O SoftAdapt proporciona as melhorias mais consistentes, quase sem custos computacionais adicionais em comparação com o treino apenas com MSE. O GradNorm também fez parte da avaliação. Não há um vencedor único em todos os indicadores.
| O que foi comparado | Conclusão |
|---|---|
| Arquiteturas | Nenhuma é a melhor em todos os conjuntos e métricas |
| Funções de perda compostas | Melhoram a preservação das interfaces e a precisão espectral |
| SoftAdapt | Melhorias mais consistentes, quase sem custos adicionais |
Conclusão: a escolha depende do conjunto de dados e da métrica. Critério prático: determinar a métrica mais importante e, em seguida, testar a função de perda e a arquitetura no conjunto-alvo.
Estado e acesso
O trabalho Neptuna foi aceite na NeurIPS-2026 (Evaluations and Datasets Track). O artigo foi submetido em 24 de julho de 2026 (v1); a última revisão é de 18 de outubro de 2026 (v3). arXiv:2607.22280.
O repositório do benchmark e o conjunto de dados estão disponíveis através de este URL https. Isto permite reproduzir a avaliação e comparar modelos com os resultados do benchmark.
Conclusão: o benchmark está disponível para testes práticos. Critério prático: utilizar o repositório como base para uma comparação reprodutível.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Invariantes polinomiais canónicos no diagnóstico de falhas em simuladores de RL: onde são realmente úteis
O estudo avalia se a incorporação de leis físicas em modelos de dinâmica treináveis se justifica: os invariantes extraídos das trajetórias e reduzidos à forma canónica por meio de bases de Gröbner proporcionam ganhos modestos nas previsões, mas são eficazes no diagnóstico — permitem localizar a restrição violada e identificar o parâmetro específico incorreto.
10 novembro 2026
AURA-Eval: como verificar se o agente de LLM reconheceu o risco e mudou o próximo passo
O framework avalia o comportamento de agentes LLM não pelo veredito final, mas pela reação ao risco em pontos-chave: as trajetórias de chamadas a ferramentas são interrompidas, após o que o modelo deve continuar o raciocínio e a ação, enquanto um painel de juízes LLM analisa a detecção de riscos, a natureza e a segurança da ação. Em 1.249 tarefas reunidas a partir de 157 trajetórias do R-Judge, as ações inseguras tornam-se mais frequentes entre 20 modelos quando não há um caminho seguro, e a remoção da supervisão antes da execução transforma 52,3% dos casos inicialmente seguros em casos inseguros.
10 novembro 2026
Memória do reservatório de Chern–Simons: dinâmica autónoma de conectividade e transporte de densidade
O artigo analisa como um reservatório preserva o histórico dos sinais de entrada simultaneamente na distribuição de densidade e nos graus de liberdade geométricos. A comparação de quatro mecanismos mostra que a corrente cria uma componente de conectividade separada, que altera a resposta subsequente da densidade, e que considerar todas as características medidas proporciona um pequeno ganho na descodificação da ordem dos impulsos.
10 novembro 2026