
Em resumo: do que se trata, afinal
Em agosto de 2026, surgiu no arXiv um trabalho com um título quase banal — «Software Defined Dataflow System for Large-scale AI Acceleration». Por trás dele está a descrição do acelerador Maia 200, e não se trata de mais uma iteração de «mais flops por watt». A ideia central aqui é arquitetural: os autores propõem redefinir as prioridades na forma como um chip de IA é concebido.
O material foi submetido em 25 de agosto de 2026 à seção cs.AR, tendo como remetente Torsten Hoefler, com 17 pessoas na lista de autores (Sherry Xu e mais dezesseis pesquisadores). O trabalho está classificado em várias rubricas ao mesmo tempo: arquiteturas de hardware, inteligência artificial, computação distribuída e paralela, novas tecnologias e aprendizado de máquina. Ou seja, a proposta não é uma nota sobre «hardware», mas sim uma conceção que abrange toda a stack.
Dados em vez de comandos: a essência da mudança
Um acelerador clássico é estruturado em torno do fluxo de comandos. Há núcleos, há um escalonador, há uma hierarquia de caches — e toda essa construção serve à execução de instruções. A memória, nesse modelo, desempenha o papel de pessoal de apoio: forneça os dados a tempo, e o resto nós fazemos.
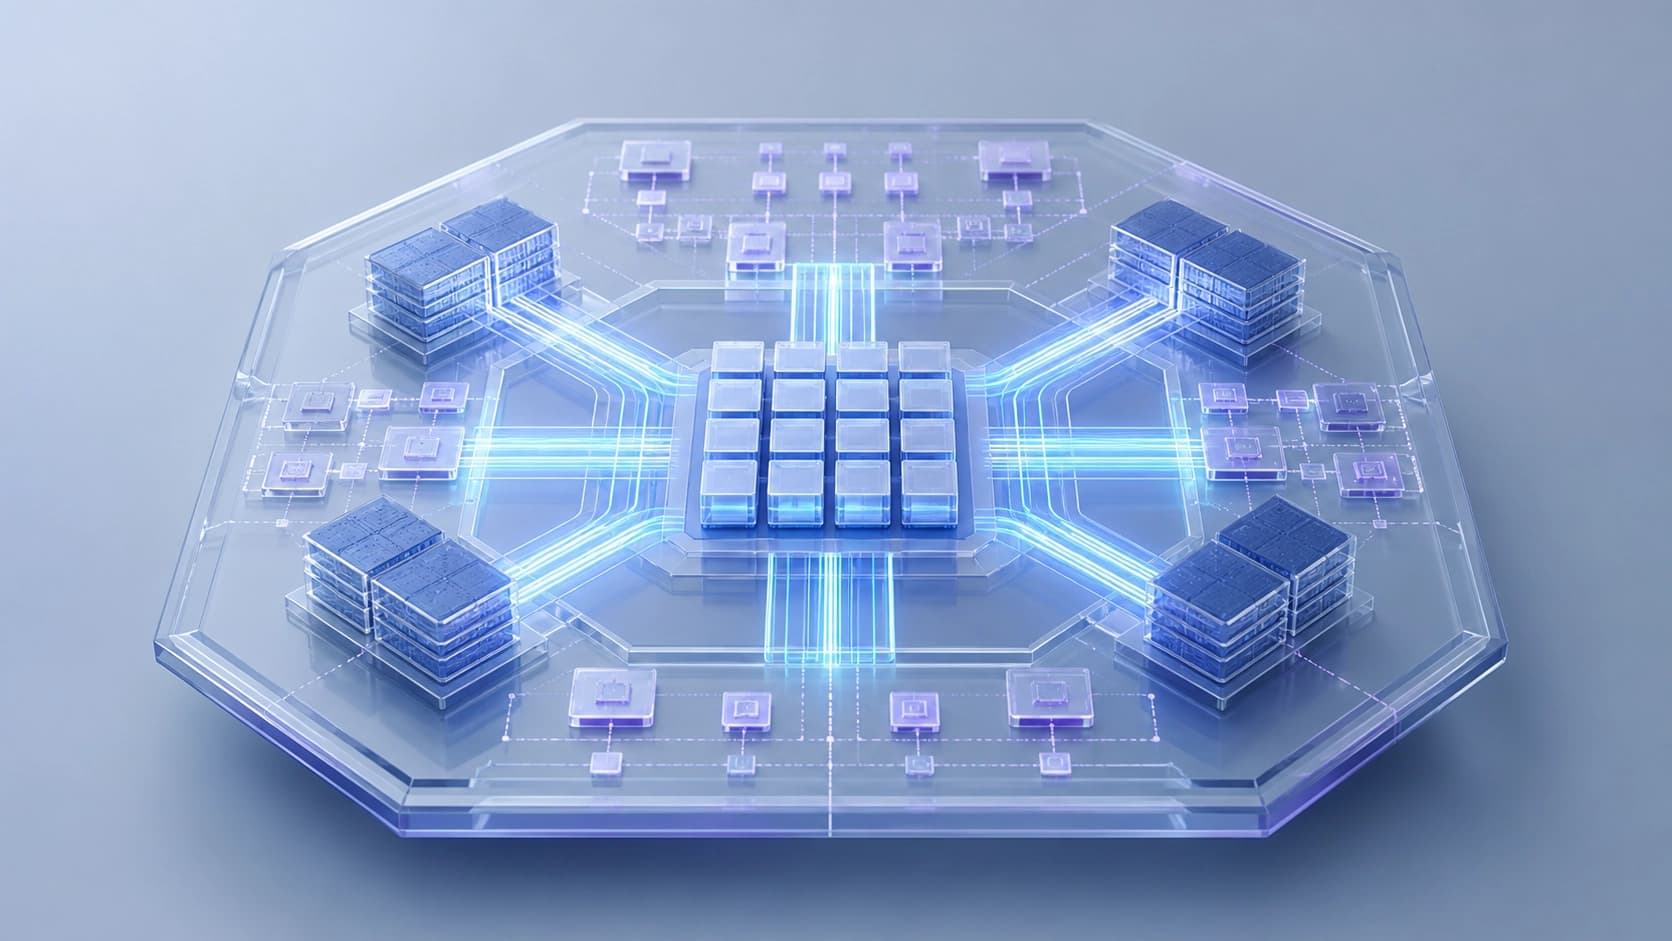
No Maia 200, a lógica se inverte. Os autores classificam o chip numa nova classe — Software Defined Locally Accessed Dataflow Architectures, abreviado SDLA. A palavra-chave aqui é «software defined»: os motores de dataflow não apenas existem no silício, eles são explicitamente programados. O programador descreve como os blocos de memória especializados e os motores de movimentação de dados devem ser orquestrados. O controle torna-se explícito, e não um efeito colateral do pipeline.
Daí o deslocamento do foco: não thread-centric, mas data-movement-centric. A pergunta «quantas instruções por ciclo» cede lugar à pergunta «com que rapidez e sem perdas os dados chegam onde serão processados». Para as cargas de trabalho modernas, são formulações de problema fundamentalmente diferentes.
Números
As características brutas do resumo são as seguintes:
- 10 145 Tflop/s no formato FP4;
- 5072 Tflop/s em FP8;
- largura de banda de memória HBM — 7 TB/s;
- envelope térmico — 750 W.
O que esses números significam — e o que não significam
A tentação de comparar imediatamente 10 145 Tflop/s em FP4 com algo familiar é grande, mas não há com o que comparar de forma correta: os autores não publicam medições em modelos específicos, e diferentes formatos de precisão e diferentes metodologias de medição produzem números incomparáveis. Vale também ter em mente que precisão muito baixa (FP4) é sempre um compromisso de qualidade, e o ganho nos números não equivale ao ganho em trabalho útil.
Muito mais interessante aqui são os 7 TB/s. É justamente essa característica que dialoga com a ideia central do artigo: se a arquitetura é construída em torno da movimentação de dados, então a largura de banda de memória não é um parâmetro secundário, mas sim a estrutura portante. E os 750 W são um lembrete de que se trata de um rack, não de uma placa de mesa.
SDLA e a nova taxonomia
Para explicar em que esse chip difere dos convencionais, os autores constroem uma taxonomia de gestão de dados. A referência para ela é a antiga classificação de Flynn, que dividia as máquinas pelo número de fluxos de comandos e de dados. Era uma linguagem conveniente para uma época em que o gargalo estava na execução.
Agora, segundo os autores, é necessária outra linguagem — sobre como o sistema administra os dados. A classificação resulta não sobre «quanto», mas sobre «como está organizado». E nesse quadro a SDLA ocupa uma célula própria: uma arquitetura em que a memória e a movimentação de dados são cidadãos de primeira classe, e não pano de fundo.
O sentido prático de tal taxonomia não está no amor por esquemas. Ela dá aos engenheiros um vocabulário: é possível discutir com fundamento a que classe pertence um determinado hardware e quais tarefas lhe são adequadas, em vez de medir tudo com um único número.
Por que isso importa para a inferência
A inferência é, em grande medida, sobre fazer passar pelo chip enormes volumes de pesos e ativações com latências mínimas. Quanto maior o modelo, mais tudo esbarra na memória e nas conexões entre os blocos, e não na aritmética. A eficiência aqui é determinada por quão bem o sistema consegue mover dados.
Os autores afirmam que o Maia 200 proporciona uma economia notável em custos e energia, sustentando paralelismo massivo justamente em cargas de inferência. Se isso se confirmar em tarefas reais, e não apenas em sintéticas, tratar-se-á de outro equilíbrio: não «o chip mais rápido», mas «o chip mais barato de alimentar no mesmo volume de requisições». Para data centers, onde a conta é feita em megawatts, esse é justamente o argumento que pesa mais.
O que ficou de fora
A prudência exige ressalvas. O trabalho é um preprint: arXiv:2608.24664, DOI 10.48550/arXiv.2608.24664, com PDF, versão HTML experimental e fontes TeX disponíveis. A revisão por pares, as medições independentes e a reprodução dos resultados ainda estão por vir. As promessas sobre economia de energia e dinheiro devem ser lidas como declaração dos autores, e não como fato medido por terceiros.
A segunda questão é o custo da transição. O dataflow programável exige outro modo de pensar: o desenvolvedor precisa descrever explicitamente as rotas dos dados, e os compiladores e frameworks precisam aprender a usar isso. Enquanto o ecossistema não acompanhar, as vantagens do hardware não serão visíveis para todos nem de imediato. Foi assim com qualquer mudança de paradigma arquitetural: primeiro a conceção, depois as ferramentas, depois a adoção em massa.
E, no entanto, o principal nesta história não são os teraflops específicos. Mais importante é a própria formulação: o gargalo da computação em IA deslocou-se para onde os dados viajam, e não para onde os comandos são executados. Se essa ideia estiver correta, os chips das próximas gerações serão projetados de outra forma — e, possivelmente, é a partir deste trabalho que se começará a contar.


