
Nova abordagem LSem2Vec: como obter o vetor de código em dois passos e sem treinamento caro
Pesquisadores propuseram uma forma simples de incorporação de código-fonte que combina grandes modelos de linguagem e modelos de embeddings de texto. O método LSem2Vec não requer ajuste fino para a tarefa e, de acordo com os resultados dos experimentos, supera cinco abordagens não supervisionadas modernas.
O que são embeddings de código
A representação vetorial de código-fonte é necessária para diversas tarefas práticas: desde a busca por trechos semelhantes até a agrupamento automático de funções por sentido. O programa se transforma em um conjunto de números com os quais algoritmos de aprendizado de máquina podem trabalhar. A qualidade do vetor, nesse caso, depende de quão bem o modelo compreende a semântica do código, e não apenas sua sintaxe.
Qual é a dificuldade
Métodos clássicos geralmente exigem treinamento separado para cada tarefa ou, no mínimo, um ajuste fino em dados do domínio. Isso é caro e nem sempre se justifica. Abordagens baseadas em grandes modelos de linguagem (LLMs) parecem mais universais, mas têm sua desvantagem: nas respostas do modelo, não é raro encontrar informações supérfluas ou incorretas, e essa "sujeira" acaba nos vetores.
A ideia do LSem2Vec
Os autores do trabalho propuseram uma abordagem em duas etapas com o nome sugestivo de LSem2Vec — LLM-extracted code Semantics to Vector embedding. Em vez de tentar treinar mais um modelo pesado, eles combinam componentes já prontos: o LLM extrai o significado do código, e um modelo de embeddings de frases converte a descrição em um vetor. Não é necessário ajuste fino para a tarefa específica.
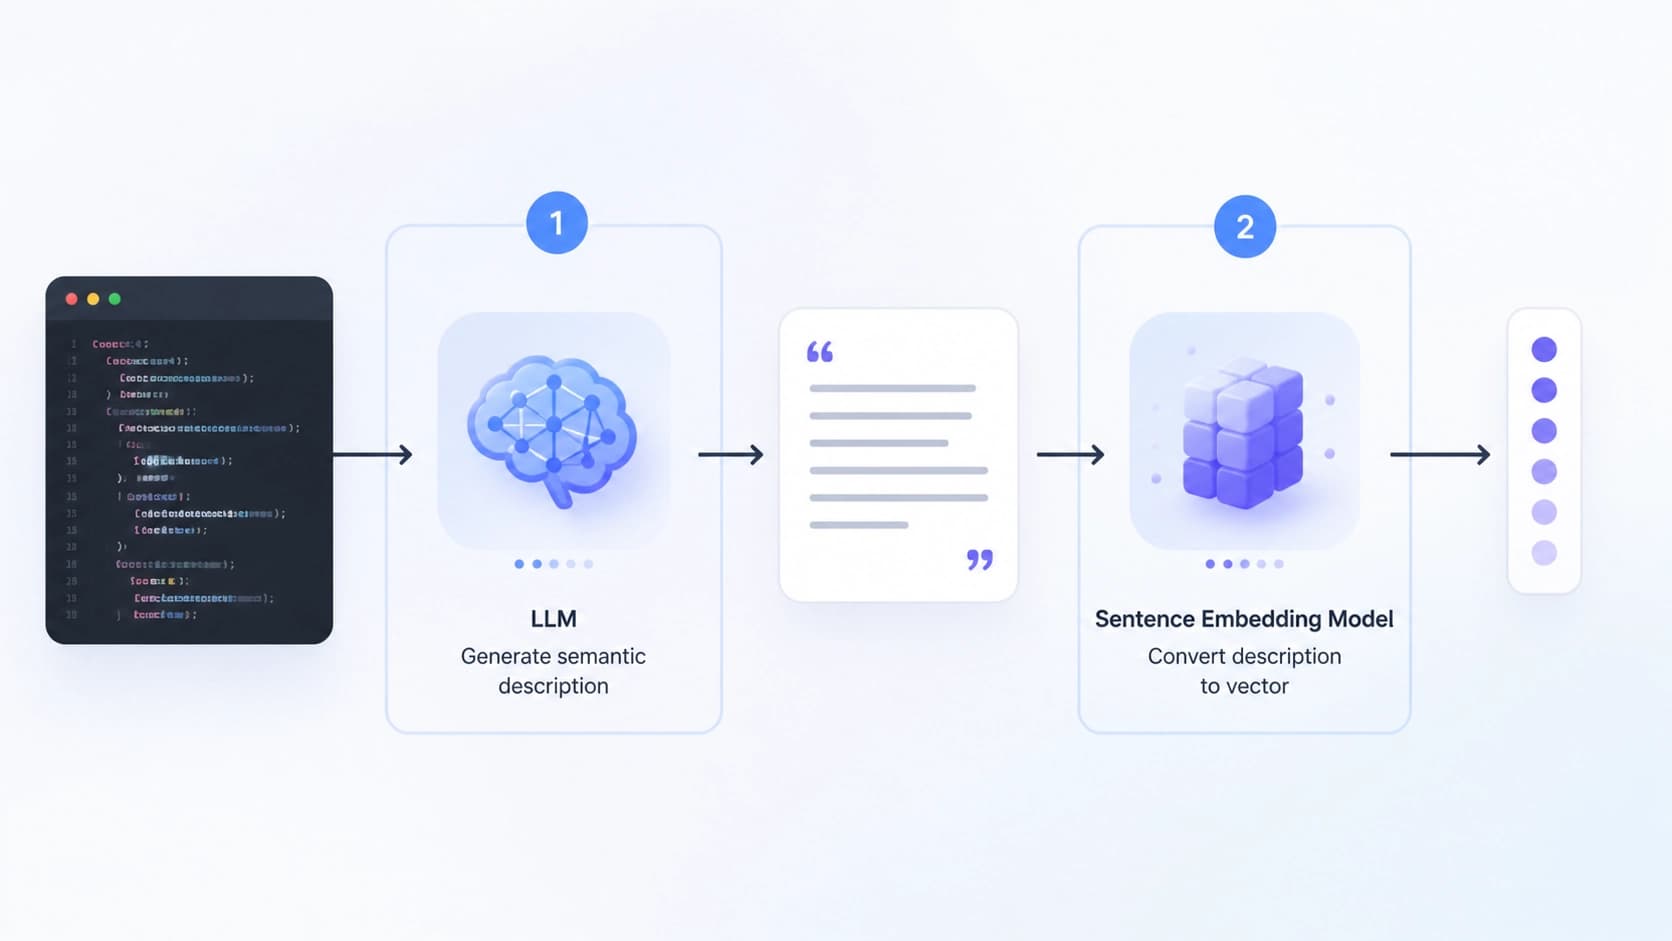
Vamos analisar o processo passo a passo. Na primeira etapa, o LLM recebe o código e deve formular o que exatamente ele faz. Não se trata de uma recontagem mecânica do código-fonte, mas de extrair a essência: o modelo descarta detalhes secundários para que apenas o que é importante para o sentido entre na descrição. De quebra, essa abordagem também elimina possíveis "fantasias" dos grandes modelos — informações incorretas que geralmente aparecem ao tentar codificar o código diretamente.
A segunda etapa é trivial para os padrões do aprendizado de máquina: a descrição obtida do LLM é alimentada em um modelo de embeddings de frases. Esse tipo de modelo já é treinado para transformar linguagem natural em vetores significativos, portanto não é necessário adaptá-lo à sintaxe das linguagens de programação.
Por que isso funciona
O ponto forte do LSem2Vec está na clara divisão de responsabilidades. Um modelo é responsável por compreender a lógica, o outro, por traduzir o texto em vetor. Cada um resolve sua tarefa da melhor forma possível e, juntos, produzem um vetor baseado na semântica, e não em características formais do código. A ausência de uma etapa de treinamento torna a abordagem barata e simples de reproduzir.
Como foi testado e quais foram os resultados
Os experimentos foram realizados em três conjuntos de dados compostos em diferentes linguagens de programação. Os autores variaram propositalmente tanto os LLMs quanto os modelos de embeddings para garantir que o resultado não dependesse de um par específico de ferramentas.
Em todas as configurações, o LSem2Vec apresentou resultados melhores do que cinco métodos não supervisionados modernos, que geralmente são projetados para condições específicas e exigem ajustes.
Status do trabalho
O artigo foi disponibilizado no arXiv em setembro de 2024, e a versão mais recente disponível é a v5, de agosto de 2026. Segundo os autores, o trabalho foi aceito pelo periódico Frontiers of Computer Science. Isso significa que a abordagem agora tem não apenas uma página de preprint, mas também uma publicação revisada por pares. O original pode ser encontrado pelo DOI: 10.1007/s11704-026-61288-0.
Conclusão
A principal lição do LSem2Vec é que problemas complexos nem sempre exigem soluções complexas. Basta aplicar sequencialmente um LLM para extrair o sentido e um modelo de embeddings de frases para criar o vetor. É rápido, dispensa ajuste fino especial e produz resultados competitivos.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
A confirmação de candidatos é mais cara do que a sua geração: iscas contra a busca de vulnerabilidades por LLM
O trabalho analisa a assimetria de custos na busca agentiva por defeitos: gerar variantes é barato, mas confirmá-las por meio de análise de alcançabilidade, execução e PoC exige a maior parte do orçamento; por isso, a verificação pode tornar-se um alvo de defesa por si só. O RedHerring proposto — iscas adaptadas ao repositório, com certificado selado — reduziu, com custos iguais, o número de vulnerabilidades reais encontradas em 38,7–60,4% em 33 projetos do OSS-Fuzz; mesmo após alertar o agente, a redução manteve-se em 37,2%.
9 novembro 2026
Verificação de alucinações em LLMs com uma representação SQL das fontes, sem ajuste fino
Este trabalho avalia se uma LLM consegue recorrer a uma competência simbólica básica — construir uma base de dados SQL a partir de documentos de origem — para fundamentar as respostas nas fontes sem supervisão na deteção de alucinações. No RAGTruth e no DiaHalu, este pipeline neuro-simbólico revela-se mais preciso do que a previsão direta e comparável aos métodos mais avançados, sem exigir afinação específica ao domínio.
9 novembro 2026
MathAdv: o que esconde a precisão final das provas geradas por máquina
Um conjunto de tarefas de diagnóstico em 13 áreas da matemática de nível universitário e de pós-graduação avalia sistemas de demonstração automática em Lean 4 não só pelo resultado final, mas também pelo domínio da matéria, pela qualidade do raciocínio informal e pela robustez perante reformulações das condições. A análise por componente mostra que traduzir um problema para uma forma formal continua a ser o principal obstáculo, e que o sucesso depende muito da área da matemática e da forma como o problema é formulado.
9 novembro 2026