
Como o prompt engineering pontual de LLMs encontra dados médicos ocultos que os sistemas padrão de desidentificação deixam passar
Um novo estudo mostrou que grandes modelos de linguagem com prompts calibrados para uma clínica específica preenchem lacunas na proteção de informações médicas — incluindo códigos internos e nomes de edifícios — superando em precisão os algoritmos existentes e, ao mesmo tempo, identificando erros na anotação de referência.
Por que os deidentificadores padrão ignoram dados "locais"
Os sistemas automáticos de deidentificação de registros médicos geralmente lidam bem com tipos típicos de informações protegidas: nomes, datas de nascimento, números de seguro. Mas em um hospital real existem dados que são sensíveis apenas dentro daquela organização. São nomes abreviados de clínicas, nomes de prédios, códigos internos de departamentos. Para uma pessoa, essas strings indicam claramente o local do tratamento, mas um algoritmo universal não pode conhecer todas as designações locais.
As soluções tradicionais dependem de dicionários ou de modelos treinados com categorias fixas. Ambas ignoram o que não está em seus repositórios. Os pesquisadores chamam isso de PHI "institucionalmente localizada", e é exatamente aí que surgem riscos sérios de vazamento.
Como o LLM consegue preencher a lacuna
Para verificar se grandes modelos de linguagem com in-context learning conseguem resolver esse problema, os autores do experimento pegaram 100 notas anotadas de oncologia pediátrica — no total, mais de cinco mil fragmentos de PHI — e compararam oito LLMs com dois sistemas especializados (Stanford TiDE e OpenMed PII) e dois baselines baseados em padrões.
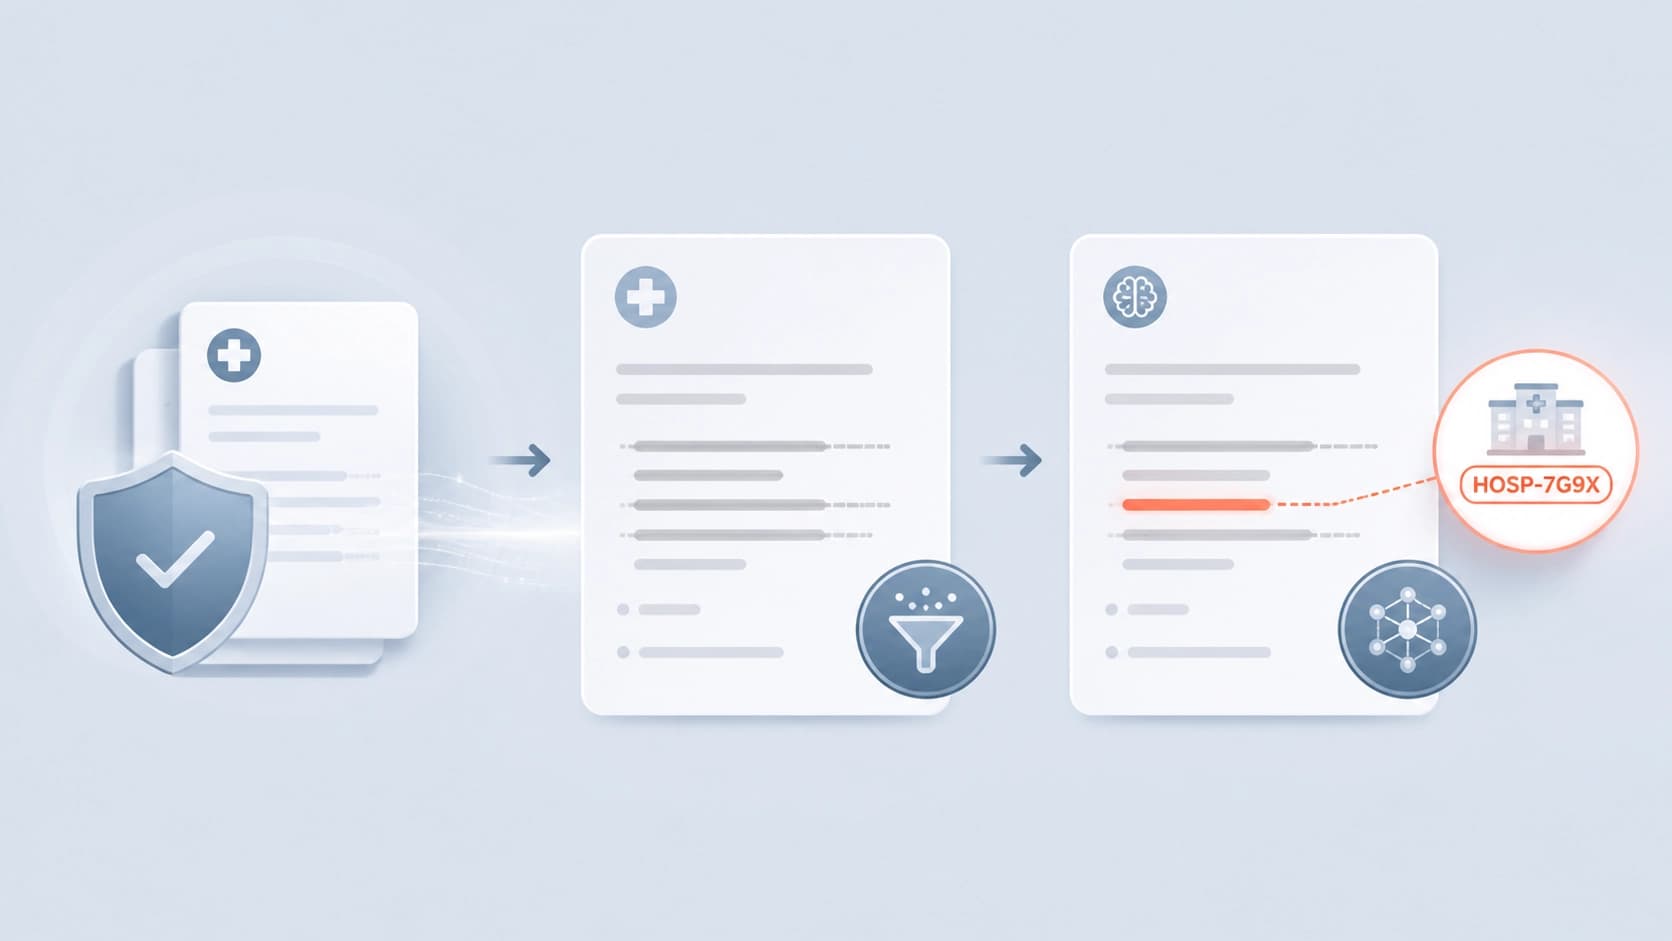
O resultado favoreceu os LLMs: o melhor modelo alcançou F1 = 0,918 ± 0,001, enquanto o melhor sistema especializado, TiDE, mostrou apenas 0,779. A vantagem foi especialmente notável nas categorias contextualmente dependentes — justamente aquelas designações locais que normalmente ficam fora do alcance dos algoritmos.
Três níveis de prompts: da HIPAA ao ajuste fino
O truque principal não é apenas uma consulta, mas um ajuste direcionado do prompt para a instituição específica. No experimento, foram usadas três variações:
- Prompt básico — instrução geral baseada no padrão HIPAA.
- Prompt com categorias locais — adiciona uma lista de tipos institucionais de PHI que o padrão não considera.
- Prompt com proteção contra edição excessiva — instrução adicional para não remover conteúdo clínico desnecessário.
Listar as categorias omitidas recuperou 79% dos 61 fragmentos anteriormente não encontrados (48 itens). E a instrução contra edição excessiva restaurou a precisão, que sofria devido ao "excesso de cautela" do modelo.
Agentes e ensembles não trouxeram ganhos
Pode-se supor que executar vários modelos ou um esquema multiagente daria um resultado ainda melhor. Os autores testaram 14 dessas configurações e as compararam com o melhor prompt único. Descobriu-se que nenhuma arquitetura de agente superou um prompt único calibrado em uma única passagem. Nos agentes, o F1 permaneceu na faixa de 0,906–0,907 — ou seja, praticamente no mesmo nível, mas sem ganho adicional.
LLM como auditor de anotação
Um valor adicional da abordagem com LLM é que ela ajuda a verificar a qualidade do próprio conjunto de referência. Os modelos apontaram 414 locais onde a anotação original provavelmente estava incompleta. Após verificação manual, 227 spans de PHI omitidos foram confirmados. Quando a anotação foi corrigida e o prompting reiniciado, a revocação subiu para 0,981 com F1 = 0,907 ± 0,002. Isso significa que o LLM pode atuar não apenas como ferramenta de deidentificação, mas também como auditor para criar conjuntos de treinamento mais precisos.
Conclusões
Um prompt bem ajustado permite que o LLM preencha a lacuna institucional de PHI e encontre o equilíbrio ideal entre precisão e revocação em uma única chamada ao modelo. Esse método é mais caro que as abordagens tradicionais baseadas em dicionários, mas esses custos são parcialmente compensados pela possibilidade de verificar e melhorar o próprio padrão de referência.
Os autores consideram o LLM uma alternativa legítima e adaptável aos deidentificadores especializados. A principal estratégia de implementação é o desenvolvimento de prompts institucionalmente específicos, que levem em conta as realidades locais de cada clínica.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
A transição para o simplex probabilístico reduz a lacuna modal em modelos multimodais contrastivos
O trabalho arXiv:2610.32890 propõe substituir embeddings esféricos por um simplex probabilístico, adicionando adaptadores softmax leves e a similaridade de Variação Total. Em cinco benchmarks de recuperação, a distância ℓ2 entre centroides de modalidades diferentes diminui 97–99%, mantendo ou melhorando a qualidade da recuperação.
3 novembro 2026
Como o ActionRAG reavalia evidências durante a difusão no grafo de memória de agentes LLM
Foi proposta uma arquitetura de memória em grafo que, na fase de indexação, harmoniza cuidadosamente as entidades e, no momento da consulta, reavalia as relações com base na estrutura local. No MemoryAgentBench, o método alcançou uma precisão média de 55,1 e uma melhoria de 5,4 pontos percentuais face ao melhor método de referência de recuperação, com um custo de síntese reduzido por consulta.
3 novembro 2026
Quinze empresas apoiaram o MDK Tether para automatizar a mineração
Fabricantes de equipamentos, pools e operadores assumiram o desenvolvimento de integrações com o conjunto aberto da Tether para unificar a monitorização e a gestão dos equipamentos; o agente de IA QVAC já funciona com base nele. Ainda não foram publicados dados independentes que confirmem a redução dos custos de eletricidade ou o aumento da eficiência.
2 novembro 2026