
Dados aninhados e o velho problema da inferência causal
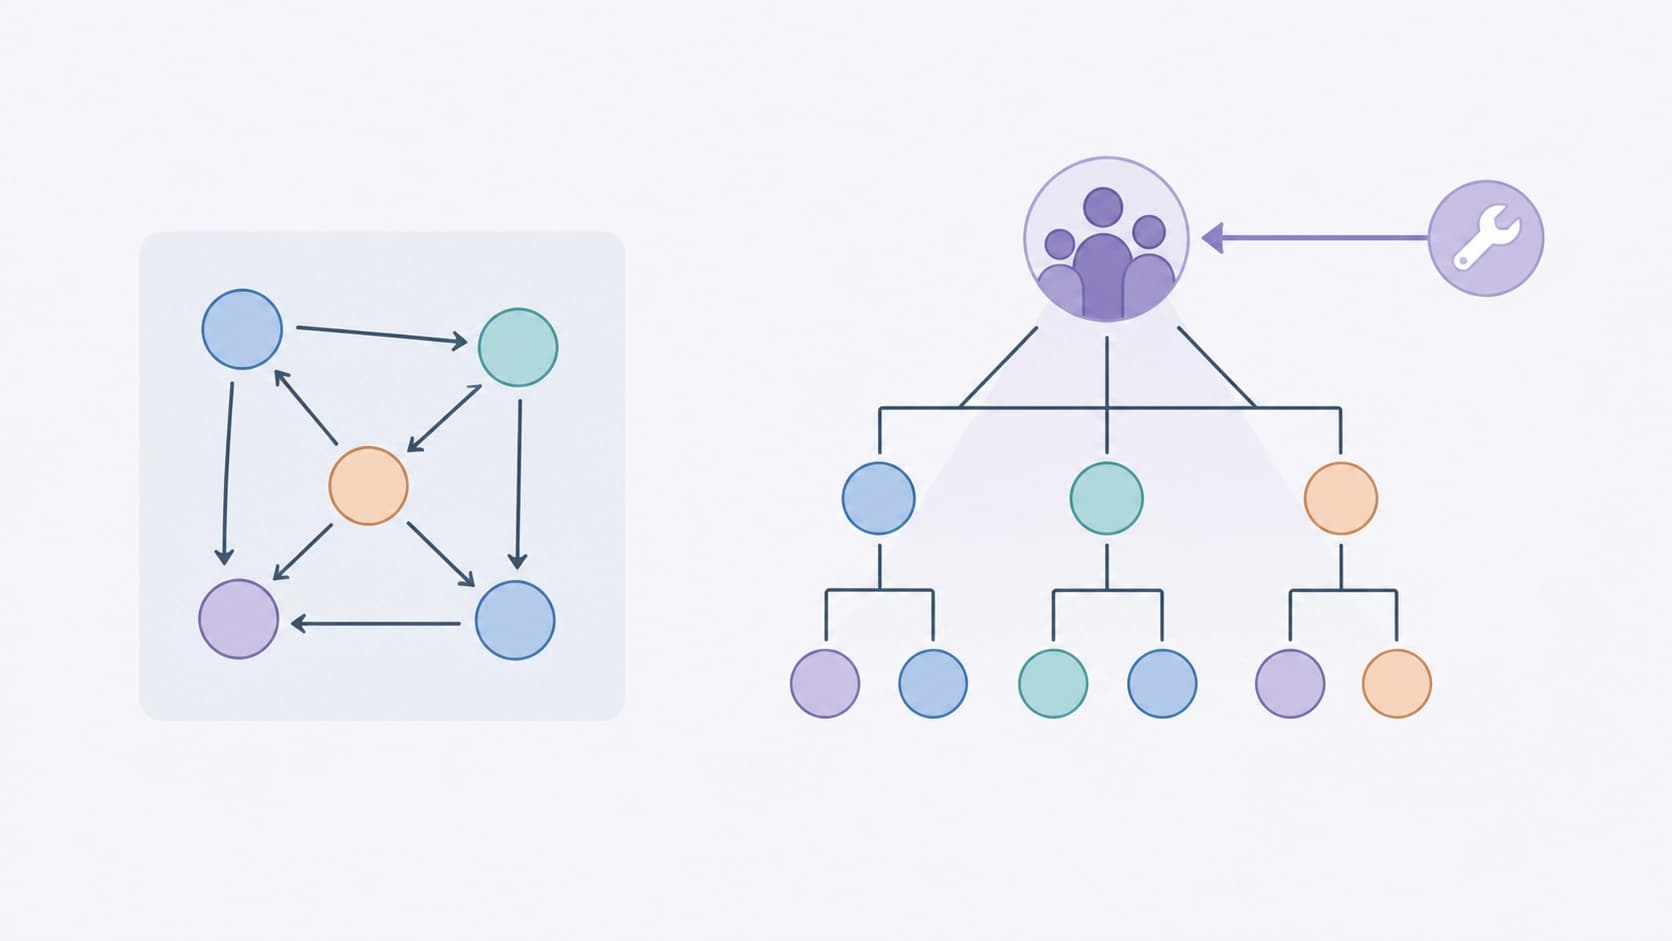
Os métodos clássicos de inferência causal funcionam bem quando as observações são independentes entre si. Mas basta que os dados ganhem uma hierarquia — alunos dentro de turmas, pacientes dentro de clínicas, funcionários dentro de departamentos — e o esquema ingênuo começa a enganar. O grupo comum cria uma correlação entre os objetos que o modelo erroneamente toma por sinal, e as intervenções que ocorrem no nível superior (por exemplo, a mudança de condições em toda uma turma) simplesmente não têm onde ser "conectadas".
É exatamente sobre isso o novo preprint arXiv:2608.24500 na seção stat.ML — "Scalable and Versatile Identification for Hierarchical Structural Causal Models: A New Look at Project STAR". O trabalho foi publicado em 25 de agosto de 2026 e foi preparado por um grupo de nove autores — Janis Aiad, Aghiles Drali, Aymen El Ouadrhiri, Anass Ettahiri, Yasser Oufqir, Simon Patry, David Cortes, Marianne Clausel e Emilie Devijver. Estão disponíveis o PDF, a versão HTML e os fontes TeX; o tema é aprendizado de máquina e inteligência artificial.
O material é interessante não tanto por mais um modelo, mas pela tentativa de montar um pipeline completo e reproduzível: da representação formal do grafo até um número concreto que se possa defender em um artigo ou relatório para um cliente.
O que os autores propõem
Trata-se de um pipeline para modelos causais estruturais hierárquicos (HSCM). Ele é aberto e foi concebido como escalável: a mesma lógica deve suportar tanto um pequeno exemplo didático quanto dados com um grande número de grupos.
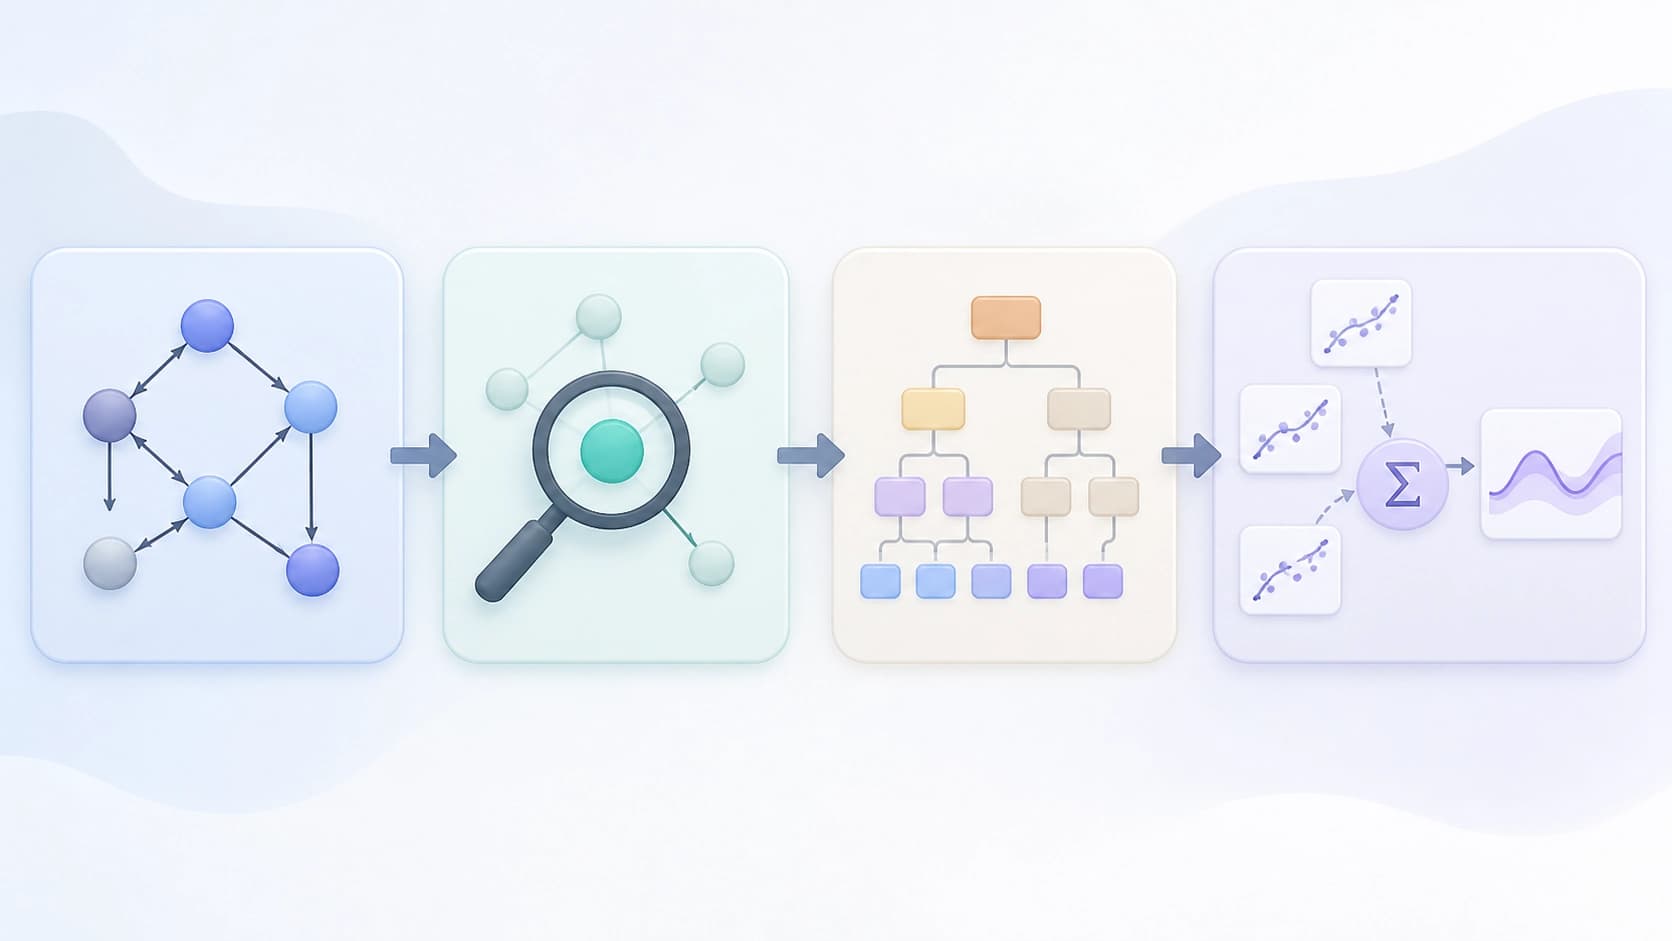
A construção é montada a partir de quatro camadas:
- transformações de grafo — preparação da estrutura que descreve as dependências entre os níveis;
- identificação simbólica via do-calculus na biblioteca pyAgrum — a máquina determina por si mesma quais efeitos são, em princípio, deriváveis dos dados disponíveis e emite a expressão correspondente;
- tradução dessa expressão em fórmulas fechadas de HSCM — o resultado simbólico se transforma em algo computável no âmbito do modelo hierárquico;
- estimação numérica a partir de modelos probabilísticos locais já ajustados.
A lógica aqui é fundamentalmente em duas etapas. Primeiro, descobre-se se o efeito é identificável em princípio — isso é uma questão de matemática, não de dados. E só depois entra a estatística: estimativa, erro, robustez.
Árvore sintática abstrata como chave para a escala
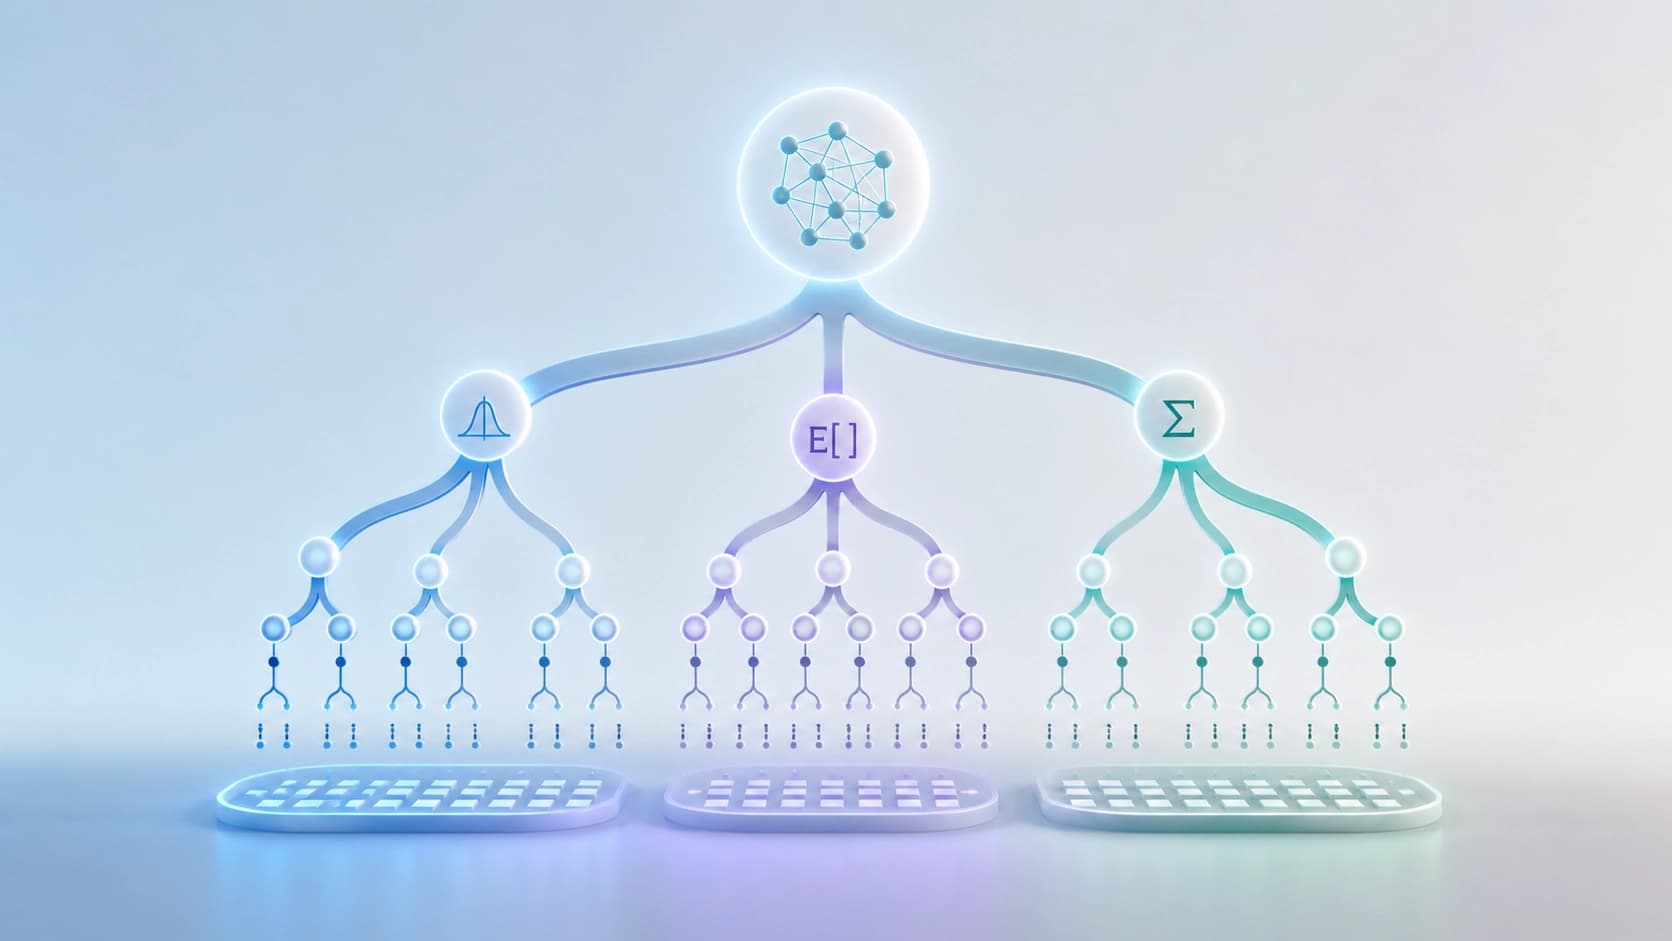
O principal achado técnico do trabalho é uma árvore sintática abstrata (AST) adaptada. A fórmula identificada do pyAgrum não é calculada "de forma direta": ela é decomposta em uma árvore, e as folhas dessa árvore se tornam subtarefas independentes de três tipos — cálculo de densidade, cálculo de esperança matemática e marginalização.
Por que isso é importante? As subtarefas obtidas podem ser calculadas em paralelo e os resultados intermediários podem ser armazenados em cache. Em vez de uma única expressão pesada, em que um erro em uma etapa inicial estraga tudo o que vem depois, surge um conjunto de partes independentes, cada uma verificável separadamente. Na prática, os autores transformam o problema de poder computacional em um problema de organização das computações.
Verificação no Project STAR
Como exemplo substantivo, toma-se o experimento STAR (Student-Teacher Achievement Ratio), realizado em 1985 no estado do Tennessee, EUA. É um conjunto de dados hierárquico de referência: foi criado para avaliar a influência do tamanho da turma no desempenho escolar, e as observações nele estão aninhadas em turmas. Essa estrutura é um polígono ideal para HSCM, porque a intervenção aqui ocorre naturalmente no nível da turma, e não da criança individual.
Antes de passar aos dados reais, os autores testam o pipeline em motivos canônicos de HSCM e em cenários de benchmark, nos quais a resposta verdadeira é conhecida de antemão. Essa é uma ordem razoável: primeiro, certificar-se de que o método encontra a resposta correta onde ela é conhecida, e só então aplicá-lo a dados em que não há como verificar. A aplicação final são os resultados de matemática no jardim de infância no âmbito do STAR.
O que os resultados mostraram
As conclusões foram sóbrias, e é nisso que está seu valor.
Em primeiro lugar, os modelos de base planos, que ignoram a hierarquia, recuperam associações — mas não são capazes de codificar a intervenção no nível da turma. A correlação "turma menor — notas mais altas" e o efeito causal da redução da turma são coisas diferentes, e a primeira não substitui o segundo.
Em segundo lugar, a identificação simbólica por si só não basta. Mesmo que a fórmula seja corretamente derivada, para a inferência hierárquica prática é necessária uma camada numérica funcional.
Daí a terceira tese: a estimação escalável e as verificações de estabilidade numérica não são um apêndice ao método, mas sua parte central. Uma expressão bonita que é impossível de calcular ou que desmorona à menor mudança nos dados não tem valor científico. Por isso, no pipeline, dedica-se tanta atenção à decomposição das computações e ao controle de robustez.
Por que isso é necessário além do STAR
Dados hierárquicos aparecem muito mais frequentemente do que parece. Educação, medicina, testes A/B com clusterização, pesquisas de opinião por regiões, medições industriais por lotes — em toda parte há aninhamento, e em toda parte há a tentação de ignorá-lo em nome da simplicidade.
O valor do trabalho está em que ele propõe não um truque isolado, mas um procedimento reproduzível. Código aberto, identificação automática via pyAgrum, transição formal para fórmulas computáveis, subtarefas independentes — tudo isso junto reduz a barreira de entrada: o pesquisador não precisa derivar por conta própria as fórmulas para cada nova estrutura de grafo.
Limitações e bom senso
Vale lembrar que temos diante de nós um preprint, e não uma publicação revisada por pares: arXiv:2608.24500 na versão v1, DOI 10.48550/arXiv.2608.24500. Os resultados em motivos canônicos e em um único conjunto de dados são uma boa verificação, mas não uma prova universal.
Além disso, qualquer inferência causal se apoia em suposições sobre a estrutura do grafo. O pipeline automatiza as computações e as torna mais transparentes, mas não elimina a questão "será que descrevemos o mundo corretamente?". Se o grafo estiver errado, um efeito cuidadosamente calculado continuará sendo um equívoco cuidadosamente calculado.
É por isso que o principal resultado prático do artigo soa prosaico: identificação sem estimação é inútil, estimação sem robustez é arriscada, e dados aninhados exigem um nível separado no modelo, caso contrário as intervenções no nível dos grupos simplesmente não têm com o que ser correlacionadas.


