
Roteiro personalizado: como o ChatPlanner usa LLM para considerar as preferências dos passageiros
O novo framework ChatPlanner combina modelos de linguagem ajustados com RAG para reconhecer preferências conversacionais e incorporá-las ao cálculo de rotas. Em experimentos, o sistema encontrou mais alternativas adequadas do que planejadores convencionais e permaneceu computacionalmente prático.
Por que um planejador "compreensivo" é necessário
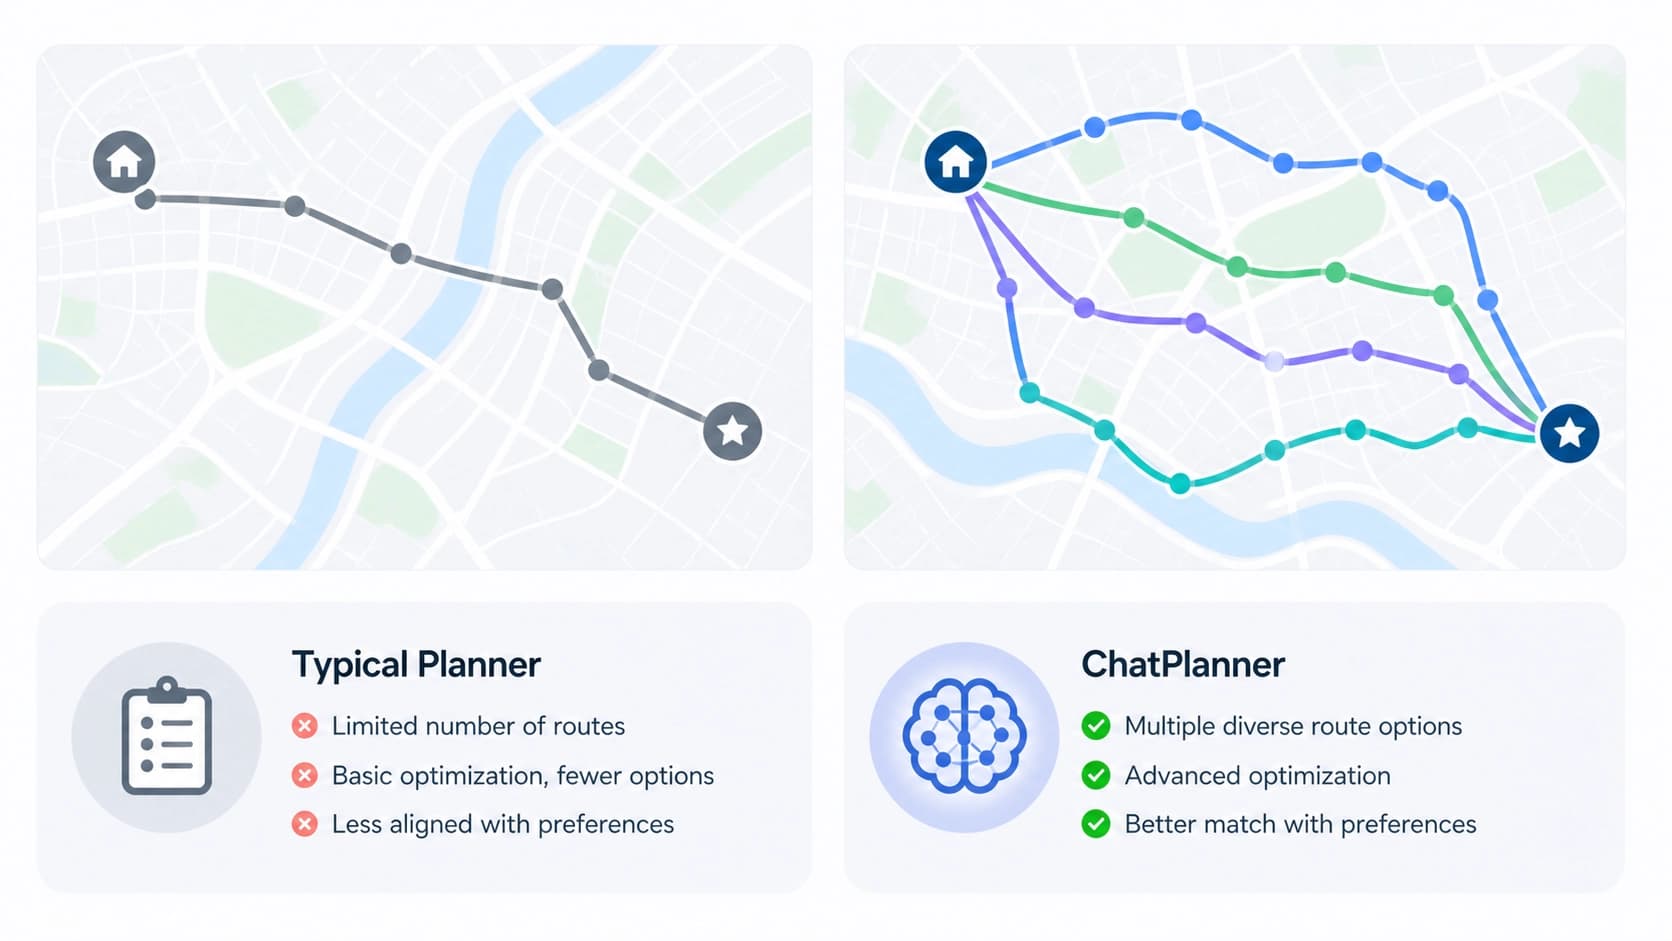
Cada passageiro escolhe uma rota à sua maneira. Para um, o mais importante é chegar mais rápido; para outro, fazer menos baldeações; um terceiro evita conscientemente ônibus ou quer reduzir caminhadas. Aplicativos de navegação padrão geralmente oferecem apenas algumas opções impessoais, ordenadas por tempo ou preço. As preferências individuais ficam de fora.
O framework ChatPlanner, descrito no preprint arXiv:2606.15315, propõe mudar essa situação. Os autores — Tingting Yang, Chenhao Xue e Jun Chen — desenvolveram uma abordagem em que o usuário explica seus desejos em palavras comuns, e o sistema os traduz em requisitos de rota. Isso expande significativamente os limites do roteamento clássico: o diálogo com o passageiro torna-se um sinal de entrada tão importante quanto o horário e o mapa de transporte.
A solução é construída em torno de grandes modelos de linguagem e já foi submetida ao periódico Transportation Research Part C. Pelo texto do trabalho, não se trata apenas de mais um chatbot: o modelo influencia diretamente a lógica de otimização da busca de rotas.
Arquitetura da solução
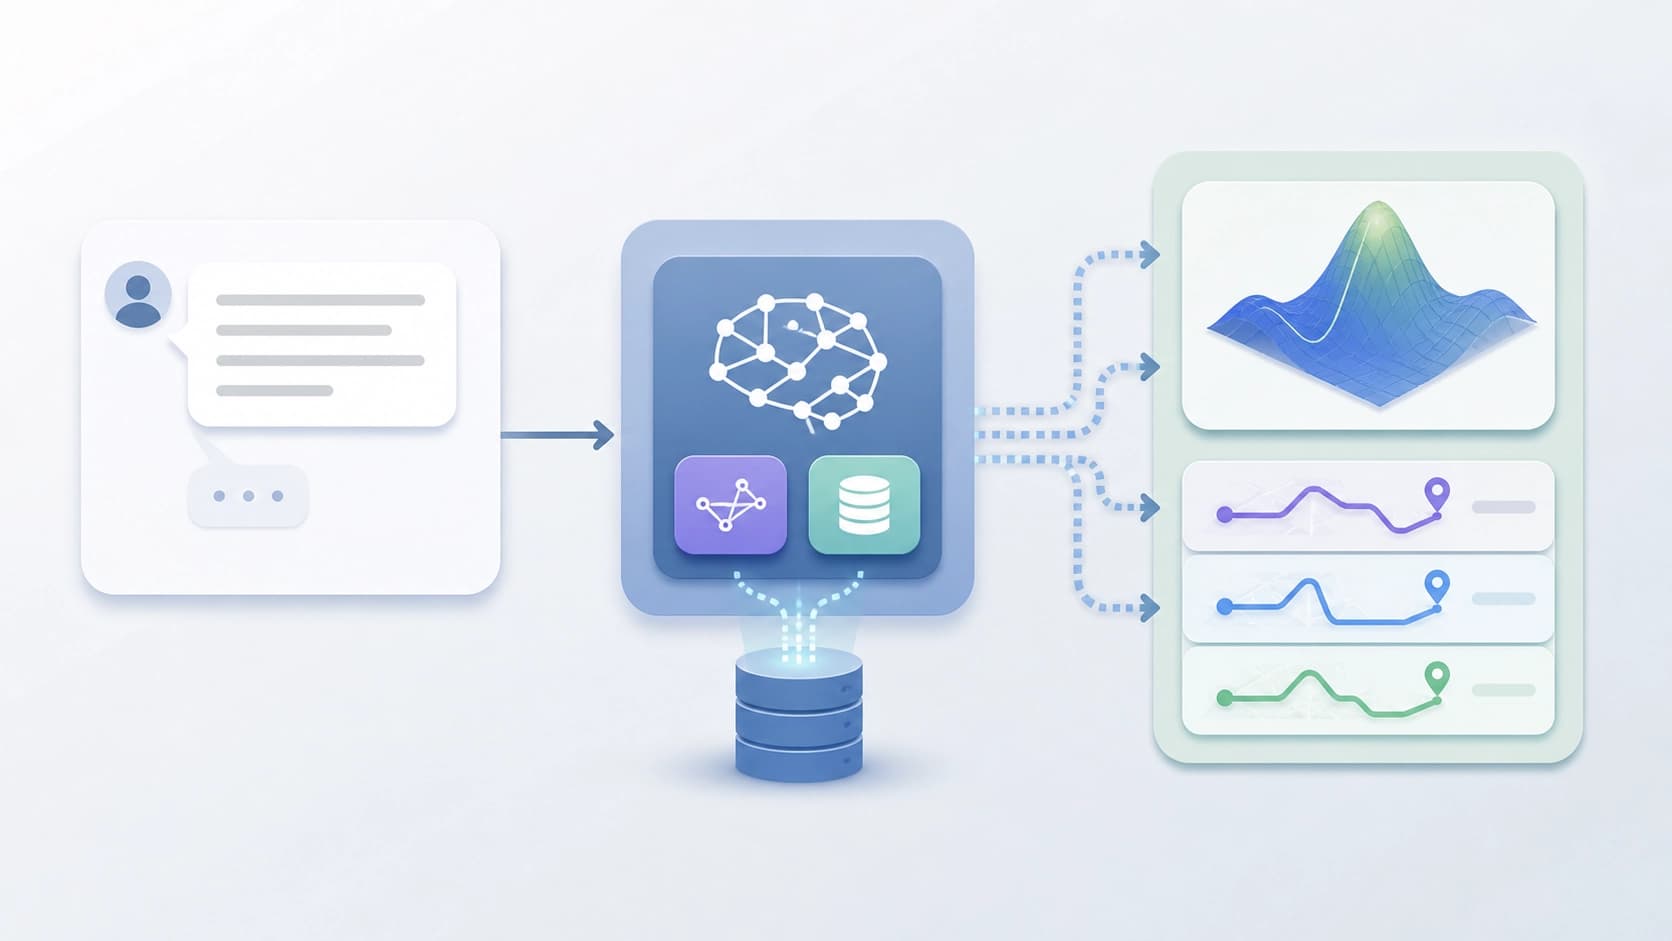
No centro do ChatPlanner está uma interface de diálogo que processa consultas em linguagem natural. O usuário pode escrever algo como "quero mais rápido, mas sem metrô" ou "não suporto longas esperas". A tarefa do framework não é apenas reconhecer as palavras, mas extrair delas parâmetros de roteamento: prioridades de tempo, número de baldeações, modos de transporte e outras características.
Para isso, utiliza-se uma combinação de dois mecanismos:
- LLM ajustada (fine-tuning) — responsável pela saída estruturada e treinada para reconhecer padrões típicos de preferências. Ela "entende" como os desejos são normalmente formulados e os padroniza em um formato único.
- Retrieval-Augmented Generation (RAG) — adiciona contexto relevante à consulta. Isso ajuda a resolver expressões ambíguas ou coloquiais e a calibrar com mais precisão avaliações contínuas — por exemplo, o grau de aversão a baldeações.
O resultado do processamento é um conjunto de pontuações de preferência (preference scores) para diferentes critérios. Essas pontuações são então integradas à função objetivo do algoritmo de roteamento de transporte público. Em outras palavras, a LLM não apenas reescreve uma rota pronta, mas participa ativamente de sua construção, ajustando a otimização ao passageiro específico.
Treinamento: personas e contextos
Para que o modelo tivesse o que aprender, os autores criaram conjuntos de dados que incluem oito personas e cinco contextos. Personas são tipos generalizados de passageiros com diferentes prioridades e hábitos: por exemplo, um estudante para quem o preço importa, um idoso com mobilidade limitada ou um viajante a negócios que valoriza cada minuto. Os contextos descrevem situações típicas — viagem ao aeroporto, horário de pico, passeio turístico e assim por diante.
Essa anotação é importante não apenas para o treinamento. Ela é usada para estabelecer padrões de referência de avaliação — "rubricas" — com as quais as respostas do sistema são comparadas. Graças a isso, é possível avaliar objetivamente o quão corretamente o framework extraiu preferências e parâmetros de rota do diálogo.
Experimentos e resultados
Para confirmar a viabilidade da abordagem, os pesquisadores realizaram quatro experimentos. Cada um verificava um aspecto específico:
- Viabilidade das soluções — se o sistema sempre oferece rotas reais e exequíveis.
- Extração de informações — o quão precisamente os parâmetros de roteamento e preferências são reconhecidos.
- Qualidade e completude do conjunto de soluções — quantas alternativas adequadas o framework gera e quão boas elas são.
- Latência e viabilidade computacional — se o sistema responde em tempo aceitável.
Os resultados mostraram que o ChatPlanner gera consistentemente soluções viáveis. O ajuste fino proporcionou a estrutura de saída necessária e permitiu que o sistema aprendesse padrões gerais de preferências. A RAG, por sua vez, forneceu o contexto da consulta específica — com ela, foi possível lidar com formulações imprecisas e coloquiais e calibrar corretamente as pontuações. A melhor precisão é alcançada com o uso conjunto de ambas as abordagens: a extração de informações torna-se não apenas mais precisa, mas também consistente com a rubrica.
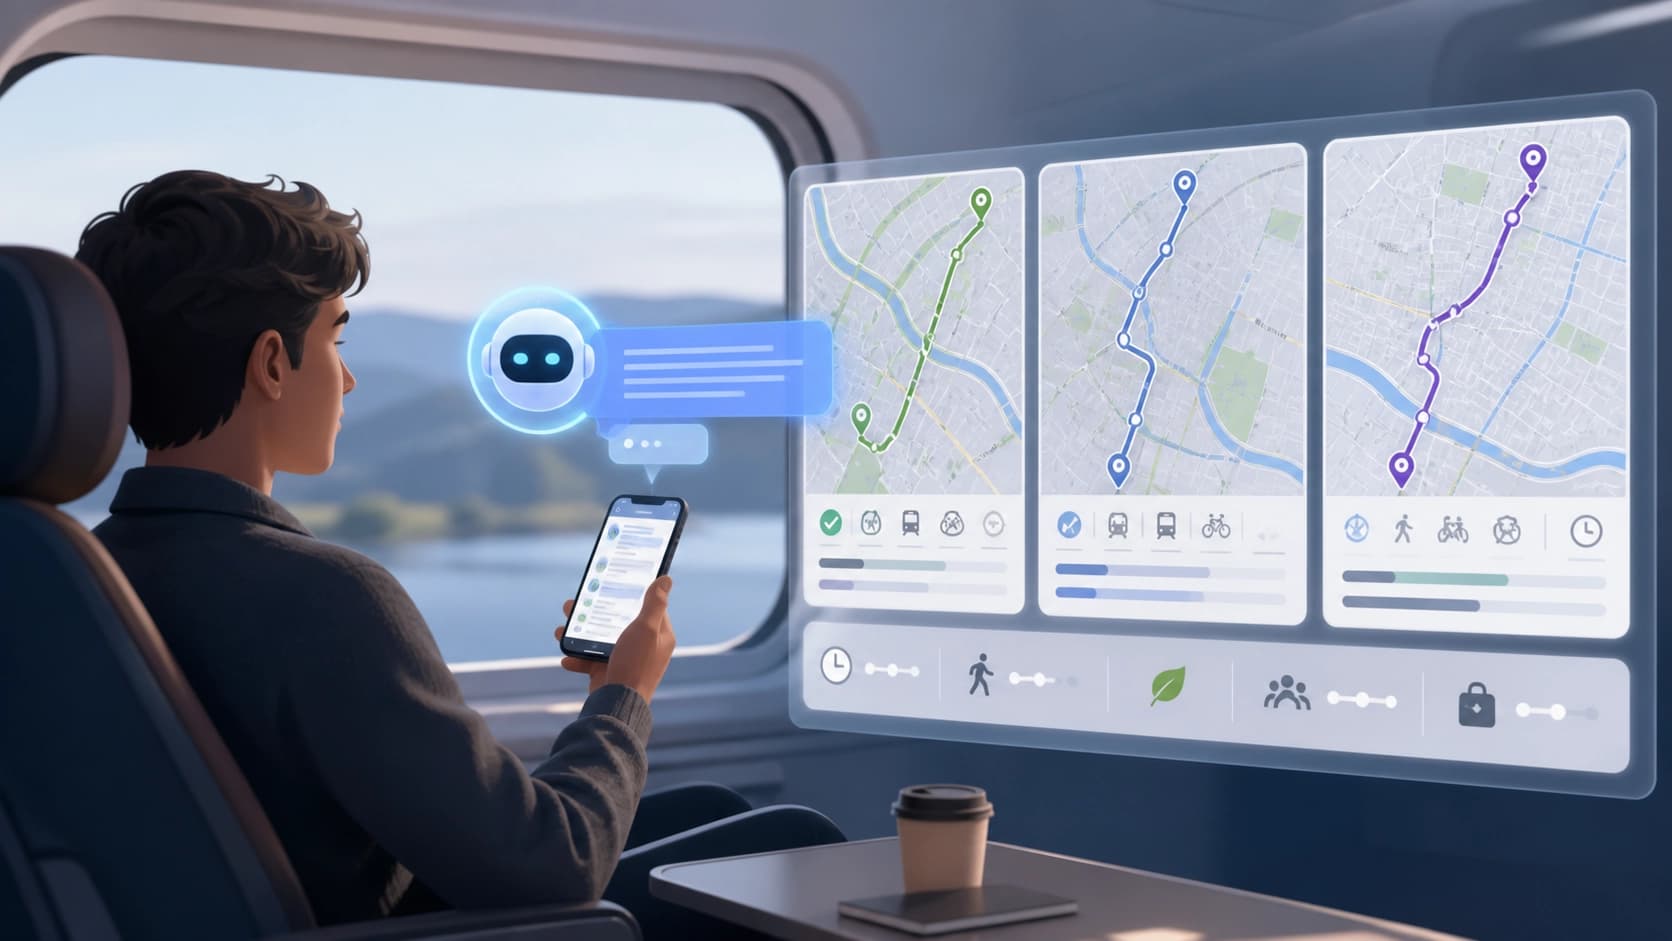
Nos estudos de caso, o framework encontrou soluções que atendiam a diferentes desejos dos passageiros e abrangiam os mais variados aspectos da viagem. Essas rotas eram ignoradas pelos planejadores existentes. Além disso, o ChatPlanner gerava mais alternativas, dando ao usuário uma escolha significativa.
Desempenho
Os autores deram atenção especial à aplicabilidade prática. As medições de latência confirmam que o framework é computacionalmente viável: apesar do envolvimento de modelos de linguagem pesados e mecanismos adicionais de RAG, o sistema pode operar em tempo real. Esse é um argumento importante de que a abordagem não ficará apenas no laboratório, mas pode servir de base para serviços reais de planejamento de viagens.
Conclusões
A pesquisa do ChatPlanner é um passo em direção a um novo paradigma, no qual a compreensão da linguagem natural e a otimização de transporte não existem mais separadamente. Em vez de exigir que o passageiro defina parâmetros claramente, o sistema os extrai da conversa. O diálogo torna-se parte integrante do processo de otimização, e a busca de rotas, um serviço personalizado.
Por enquanto, é um desenvolvimento científico, mas seus resultados parecem convincentes: a combinação de fine-tuning e RAG permite alta precisão, e o desempenho permanece aceitável. Provavelmente, interfaces semelhantes logo aparecerão em aplicativos de transporte urbano, e a escolha de rota se tornará tão natural quanto conversar com um concierge.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Invariantes polinomiais canónicos no diagnóstico de falhas em simuladores de RL: onde são realmente úteis
O estudo avalia se a incorporação de leis físicas em modelos de dinâmica treináveis se justifica: os invariantes extraídos das trajetórias e reduzidos à forma canónica por meio de bases de Gröbner proporcionam ganhos modestos nas previsões, mas são eficazes no diagnóstico — permitem localizar a restrição violada e identificar o parâmetro específico incorreto.
10 novembro 2026
AURA-Eval: como verificar se o agente de LLM reconheceu o risco e mudou o próximo passo
O framework avalia o comportamento de agentes LLM não pelo veredito final, mas pela reação ao risco em pontos-chave: as trajetórias de chamadas a ferramentas são interrompidas, após o que o modelo deve continuar o raciocínio e a ação, enquanto um painel de juízes LLM analisa a detecção de riscos, a natureza e a segurança da ação. Em 1.249 tarefas reunidas a partir de 157 trajetórias do R-Judge, as ações inseguras tornam-se mais frequentes entre 20 modelos quando não há um caminho seguro, e a remoção da supervisão antes da execução transforma 52,3% dos casos inicialmente seguros em casos inseguros.
10 novembro 2026
Memória do reservatório de Chern–Simons: dinâmica autónoma de conectividade e transporte de densidade
O artigo analisa como um reservatório preserva o histórico dos sinais de entrada simultaneamente na distribuição de densidade e nos graus de liberdade geométricos. A comparação de quatro mecanismos mostra que a corrente cria uma componente de conectividade separada, que altera a resposta subsequente da densidade, e que considerar todas as características medidas proporciona um pequeno ganho na descodificação da ordem dos impulsos.
10 novembro 2026