
Orang-orang dapat dipahami, LLM tidak: para ahli tidak dapat menjelaskan logika model
Para peneliti membandingkan faktor-faktor tersembunyi di balik jawaban manusia dan enam model bahasa pada tugas penalaran kuantitatif dan kimia. Faktor-faktor yang diekstraksi dari jawaban manusia berhasil diinterpretasikan oleh para ahli, sementara sebagian besar konstruk model ternyata tidak transparan bagi mereka.
Orang Dapat Dipahami, LLM Tidak: Para Ahli Gagal Menjelaskan Logika Model
Ketika kita melihat hasil tes, tampak wajar untuk berasumsi bahwa kecerdasan buatan memecahkan masalah "seperti manusia": menggunakan konsep, aturan, dan penalaran yang sama. Namun, penelitian baru mempertanyakan asumsi ini. Para ilmuwan menemukan bahwa struktur tersembunyi yang menentukan jawaban LLM, dalam banyak kasus, tidak dapat diinterpretasikan oleh manusia — bahkan oleh para ahli di bidangnya.
Apa yang sebenarnya diuji
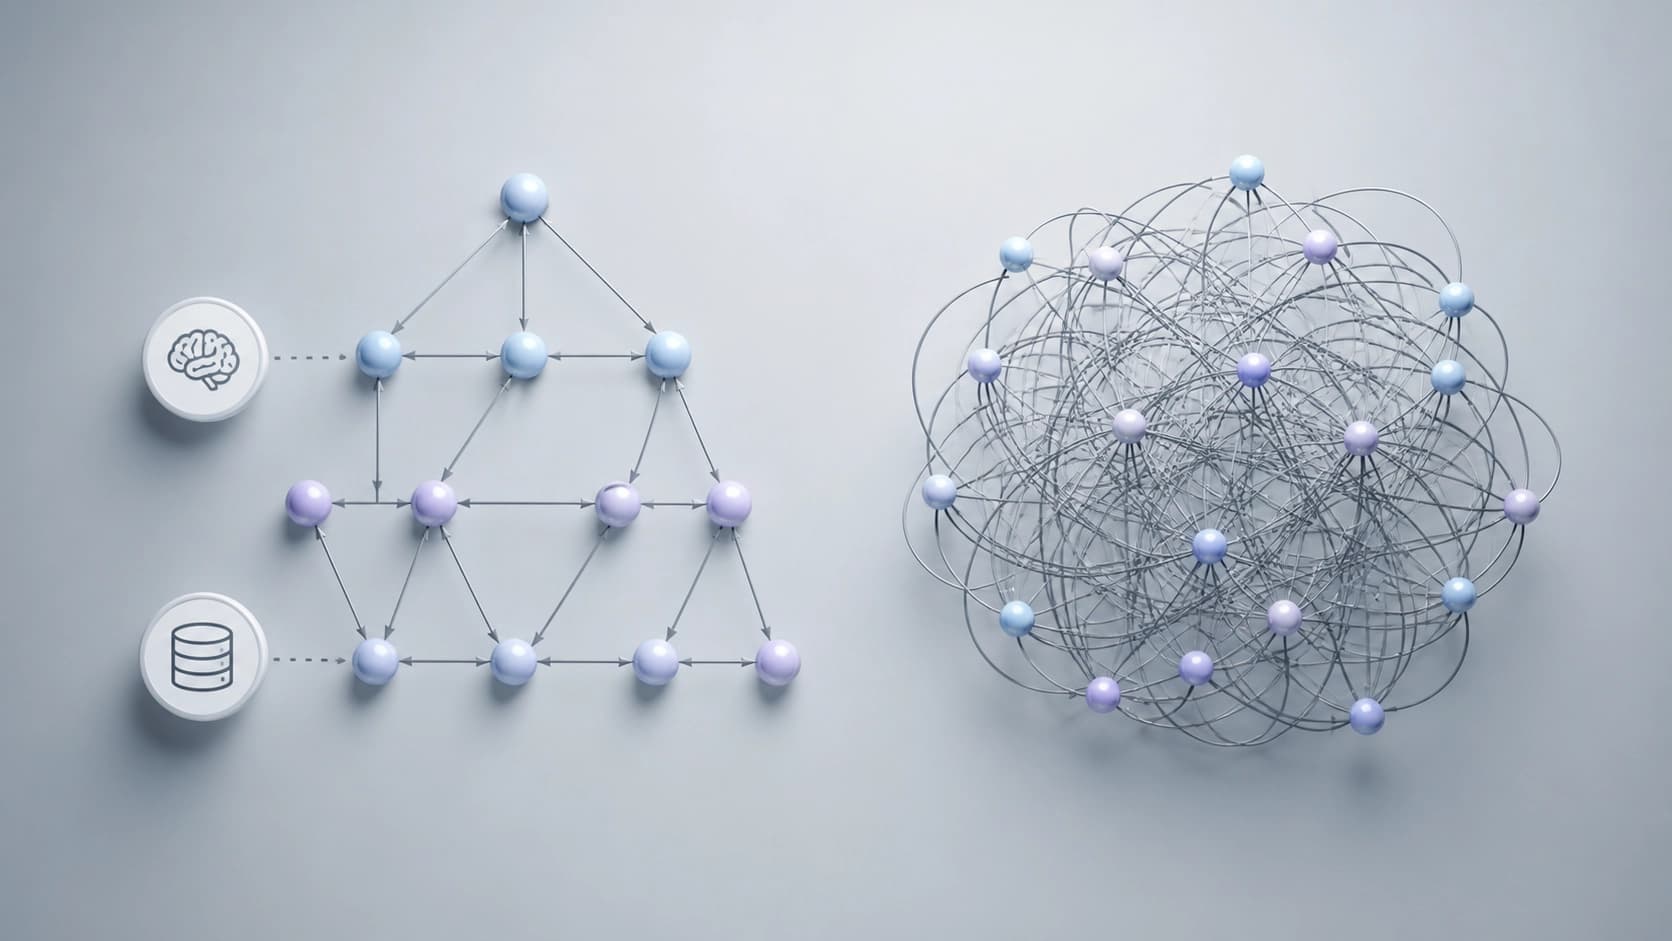
Para penulis penelitian (arXiv:2608.17810) — Alona Strugatski, Likol Zeinfeld, Jason Cooper, dan rekan-rekan mereka — mengambil jawaban dari manusia dan enam LLM yang berbeda untuk tugas penalaran kuantitatif dan kimia. Dengan menggunakan analisis faktor eksploratori, mereka mengidentifikasi faktor laten tersembunyi untuk setiap kelompok yang diduga mendasari keberhasilan dalam menyelesaikan tugas-tugas tersebut.
Para ahli materi kemudian mempelajari struktur yang dihasilkan secara buta dan mencoba menghubungkan faktor-faktor tersebut dengan makna pedagogis: misalnya, "kemampuan bekerja dengan rumus" atau "pemahaman stoikiometri". Format buta menghilangkan petunjuk — para spesialis tidak tahu apakah grafik tersebut berasal dari manusia atau model.
Hasil: Kesenjangan dalam interpretabilitas
Para ahli hampir tanpa masalah memahami faktor-faktor yang diperoleh dari jawaban manusia. Sebagian besar konstruk mendapat penjelasan yang bermakna, yang mudah diterjemahkan menjadi rekomendasi untuk pembelajaran atau diagnosis.
Dengan LLM, gambarnya berbeda:
- Dalam penalaran kuantitatif, para ahli gagal menginterpretasikan secara bermakna satu pun faktor yang diidentifikasi untuk model.
- Dalam kimia, situasinya sedikit lebih baik, tetapi masih jauh dari ideal: hanya sekitar setengah dari struktur yang berhasil dijelaskan.
Apa artinya ini
Para penulis menarik kesimpulan penting: ketika LLM menunjukkan hasil tinggi pada tes, itu tidak berarti mereka bernalar dengan cara yang kita kenal. Model dapat menemukan cara yang efisien secara statistik, tetapi sepenuhnya "asing" bagi manusia untuk memecahkan masalah. Mekanisme internal mereka bekerja pada tingkat pola yang tidak membawa makna pedagogis atau kognitif yang dapat dipahami.
Pengamatan ini menantang praktik umum ketika orang mencoba menarik kesimpulan tentang tingkat pengetahuan atau kompetensi dari hasil AI. Jika kita tidak dapat menjelaskan konstruksi apa yang mendasari jawaban, kita berisiko menghubungkan kemampuan yang tidak ada pada model — atau sebaliknya, melewatkan keterbatasan nyata.
Ke mana harus melangkah selanjutnya
Penelitian ini tidak menyatakan bahwa menginterpretasikan LLM mustahil secara prinsip. Penelitian ini hanya menunjukkan bahwa pendekatan klasik yang diciptakan untuk mempelajari kognisi manusia tidak dapat langsung diterapkan pada model. Mungkin perlu mengembangkan metode analisis yang benar-benar baru — yang memperhitungkan sifat "non-manusia" dari struktur laten.
Sementara itu, pertanyaan tetap terbuka: jika para ahli tidak dapat menjelaskan logika model, dapatkah kita mengandalkan penggunaannya dalam pendidikan dan penilaian pengetahuan? Jawabannya, kemungkinan besar, akan membutuhkan peninjauan ulang baik pendekatan untuk menguji AI maupun ekspektasi kita terhadap "kecerdasan" mesin.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Verifikasi kandidat lebih mahal daripada generasinya: honeypot untuk melawan pencarian kerentanan berbasis LLM
Karya ini mengulas asimetri biaya dalam pencarian bug oleh agen: menghasilkan kandidat itu murah, sedangkan mengonfirmasinya melalui analisis keterjangkauan, eksekusi, dan PoC membutuhkan sebagian besar anggaran, sehingga verifikasi dapat dijadikan sasaran pertahanan tersendiri. RedHerring yang diusulkan—umpan yang disesuaikan dengan repositori dan dilengkapi sertifikat tertutup—mengurangi jumlah kerentanan nyata yang ditemukan sebesar 38,7–60,4% dengan biaya yang sama di 33 proyek OSS-Fuzz; bahkan setelah agen diperingatkan, penurunannya tetap mencapai 37,2%.
9 November 2026
Pemeriksaan halusinasi LLM melalui tampilan sumber SQL tanpa fine-tuning
Penelitian ini menguji apakah LLM dapat memanfaatkan keterampilan simbolik dasar—menyusun basis data SQL dari dokumen sumber—untuk melakukan grounding ke sumber tanpa supervisi dalam deteksi halusinasi. Pada RAGTruth dan DiaHalu, pipeline neuro-simbolik ini lebih akurat daripada prediksi langsung dan sebanding dengan metode mutakhir, tanpa memerlukan fine-tuning khusus domain.
9 November 2026
MathAdv: Apa yang Tersembunyi di Balik Akurasi Akhir Pembuktian Mesin
Kumpulan tugas diagnostik dari 13 bidang matematika tingkat universitas dan pascasarjana ini mengevaluasi sistem pembuktian otomatis di Lean 4 tidak hanya berdasarkan hasil akhir, tetapi juga penguasaan materi, kualitas penalaran informal, dan ketahanan terhadap perumusan ulang soal. Analisis per komponen menunjukkan bahwa menerjemahkan soal ke dalam bentuk formal masih menjadi kendala utama, sementara tingkat keberhasilan sangat bergantung pada bidang matematika dan cara soal dirumuskan.
9 November 2026