
Tolok ukur baru SemComp-Bench menguji apakah model video menyelesaikan tugas hingga tuntas.
Para peneliti memperkenalkan dataset dan metodologi untuk mengevaluasi pembuatan video berdasarkan pelaksanaan tugas secara semantik: model tidak hanya harus membuat video yang masuk akal, tetapi juga mencapai hasil yang diinginkan dan mempertahankan keterkaitan makna dengan referensi. Eksperimen awal menunjukkan bahwa ini masih menjadi tugas yang sulit bagi model video modern.
Semantik Penyelesaian Tugas: Perspektif Baru dalam Generasi Video
Model generasi video modern sangat mahir menangani permintaan singkat seperti "kucing bermain dengan bola benang" — hasilnya indah dan tampak nyata. Namun, apakah sistem benar-benar memahami hasil yang diinginkan pengguna? Para peneliti dari Tiongkok mengusulkan tolok ukur SemComp-Bench yang menguji bukan sekadar kualitas visual, melainkan apakah tugas telah diselesaikan secara semantik.
Kelompok penulis yang dipimpin oleh Keyu Tu (total delapan peneliti) mempresentasikan makalah yang menjelaskan SemComp-Bench di arXiv. Karya ini diterbitkan pada 18 Agustus 2026 dan mencakup bidang visi komputer dan kecerdasan buatan. Konsep baru diperkenalkan — Semantic Task Completion Video Generation, yaitu generasi video dengan penyelesaian tugas secara semantik. Keberhasilan di sini tidak ditentukan oleh seberapa mulus objek bergerak atau kesesuaian bingkai-demi-bingkai dengan referensi, melainkan oleh apakah hasil yang diminta tercapai dan apakah hubungan semantik dengan sampel dipertahankan.
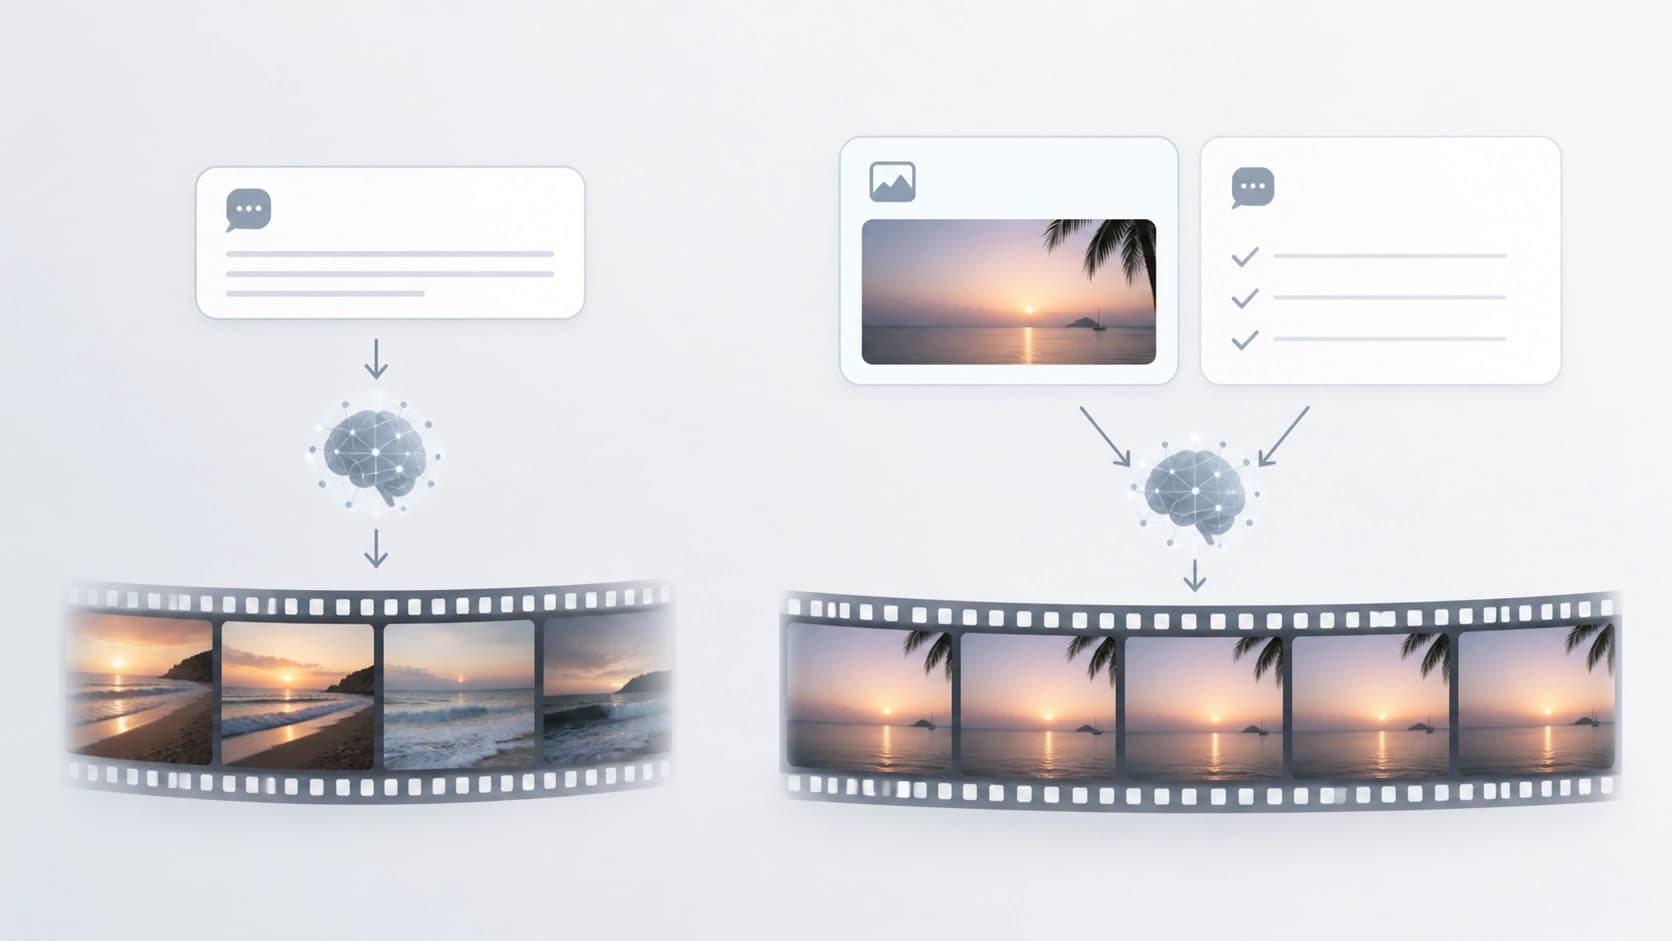
Ide kuncinya adalah "penjangkaran semantik" (semantic grounding). Model tidak hanya harus menyalin gambar, tetapi memahami makna tingkat tinggi dari tugas: misalnya, jika gambar referensi menunjukkan meja yang sudah ditata dan instruksi meminta "tambahkan teko", maka dalam video akhir teko harus muncul di atas meja. Tidak perlu menampilkan setiap langkah perantara atau membuat salinan bingkai-demi-bingkai dari sampel — yang penting hanyalah adegan akhir dan kesesuaiannya dengan tugas.
Bagaimana Data dan Evaluasi SemComp-Bench Disusun
Untuk pengujian sistematis, penulis membuat kumpulan data SemComp-Data. Kumpulan ini mencakup contoh dari enam domain berbeda — dengan cara ini penulis berupaya mencakup spektrum skenario seluas mungkin. Setiap elemen kumpulan data berisi:
- gambar referensi (apa yang seharusnya menjadi hasil akhir);
- instruksi terperinci dengan detail;
- instruksi singkat — varian yang lebih mungkin ditemui dalam permintaan nyata;
- klip video akhir yang menunjukkan hasil yang diharapkan.
Untuk menyiapkan data, para peneliti membangun jalur pemrosesan empat tahap. Jalur ini mengubah video mentah menjadi instance SemComp-Data yang terstandarisasi. Otomatisasi semacam itu memungkinkan penskalaan kumpulan data tanpa anotasi manual untuk setiap video.
Evaluasi dalam SemComp-Bench dibangun di sekitar vision-language model (VLM). Model menjawab pertanyaan biner terstruktur — artinya setiap pertanyaan memiliki jawaban tegas "ya" atau "tidak". Ini membuat pengujian transparan dan dapat direproduksi. Berdasarkan hasilnya, dua metrik dihitung:
- Skor OA (Outcome Achievement) — apakah hasil yang ditentukan tercapai;
- Skor GR (Generation Reliability) — seberapa andal model mereproduksi solusi sambil mempertahankan hubungan dengan gambar referensi.
Pada dasarnya, metrik pertama menjawab pertanyaan "apakah apa yang diminta telah dilakukan", sedangkan metrik kedua menjawab "apakah hal itu dilakukan tepat dalam konteks contoh".
Apa yang Ditunjukkan Pengujian Awal
Penulis menjalankan beberapa model generasi video yang representatif melalui tolok ukur tersebut. Ternyata, tugas menyelesaikan semantik hingga tuntas masih menjadi tantangan terbuka. Bahkan sistem modern sering menghasilkan video yang tampak berkualitas, tetapi tidak sesuai dengan inti permintaan: teko tidak muncul, objek berubah menjadi sesuatu yang mirip, dan hasilnya hanya samar-samar menyerupai yang diharapkan.
Sangat sulit bagi model untuk mempertahankan hubungan dengan gambar referensi ketika instruksinya singkat dan tidak memuat semua detail. Skor OA dan Skor GR menjadi rendah, artinya model "tidak memahami" tugas pada tingkat makna. Ini menegaskan: generasi video saat ini lebih tentang "gambar yang indah" daripada pelaksanaan perintah.
Kemunculan SemComp-Bench menggeser fokus dalam pengujian model video: alih-alih mengevaluasi kemiripan bingkai dengan realitas — kini yang diuji adalah hasil yang bermakna bagi pengguna. Jika sebelumnya tolok ukur bertanya "apakah video terlihat seperti kenyataan", kini pertanyaannya diajukan secara berbeda: "apakah tugas telah diselesaikan". Ini adalah langkah menuju video generatif yang tidak sekadar menjadi demo, melainkan alat untuk menyelesaikan masalah praktis.
Penulis menerbitkan karya ini di platform arXiv dengan nomor 2608.17426, DOI: https://doi.org/10.48550/arXiv.2608.17426. Materi tersedia untuk dipelajari, dan pendekatan evaluasi ini berpotensi menjadi dasar bagi generasi generator video berikutnya.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Toollery: memilih alat untuk agen LLM dari puluhan ribu opsi tanpa fine-tuning
Toollery membangun indeks pencarian berdasarkan deskripsi keterampilan dan alat, lalu saat ada permintaan hanya meneruskan sekumpulan kandidat terbatas ke model. Dalam eksperimen pada pustaka berskala hingga puluhan ribu fungsi, pendekatan ini mampu mempertahankan kualitas pemilihan dengan top-K tetap, meskipun dampak akhirnya bergantung pada profil beban dan caching di penyedia.
11 November 2026
Diagnostik bertahap agen GUI dalam analisis dasbor: benchmark DashAct
DashAct diperkenalkan sebagai tolok ukur yang terdiri atas 348 trajektori yang diverifikasi manusia, yang menguraikan kerja agen GUI dengan panel interaktif menjadi tiga tahap dan empat kondisi visual. Hasilnya menunjukkan masalah yang terus berulang dalam memprediksi tindakan dan mengaitkannya dengan target visual, serta ketergantungan respons agen pada dukungan kontekstual dan spasial.
11 November 2026
WILSON: menggabungkan tingkat pembesaran dan preparat pasien untuk analisis patomorfologi dan penyusunan laporan
Pracetak ini memperkenalkan WILSON — model vision-language yang mengodekan gambar seluruh slide dan rangkaian preparat dari satu pasien pada berbagai tingkat pembesaran, bukan hanya satu slide “terbaik”. Tanpa pelatihan lanjutan untuk tugas tertentu, model ini mengungguli model slide khusus dan berukuran lebih besar pada sejumlah metrik dengan beban komputasi yang jauh lebih rendah, sementara deskripsi diagnostiknya mendapat penilaian lebih tinggi dari para ahli patologi.
11 November 2026