
Masalah: kode yang berjalan, tetapi melakukan hal yang salah
Agen berbasis model bahasa besar sudah mampu mengambil artikel ilmiah dan menghasilkan repositori yang berfungsi darinya. Masalahnya, "berfungsi" dan "mereproduksi" bukanlah sinonim. Skrip bisa saja berhasil melewati semua pengujian, melatih model, dan mencetak metrik yang indah, tetapi di dalamnya urutan langkah diam-diam tertukar, pengali dalam fungsi kerugian hilang, atau ada placeholder yang menggantikan tahap yang tidak trivial.
Justru mode kegagalan inilah yang oleh penulis karya baru disebut semantic drift: kode yang dihasilkan secara diam-diam menyimpang dari apa yang dijelaskan dalam spesifikasi artikel. Kesalahannya tidak mencolok — ia hidup dalam detail yang tidak diperiksa secara otomatis oleh siapa pun. Hasilnya — reproduksi yang secara formal terjadi, tetapi secara ilmiah tidak membuktikan apa pun.
Apa itu SA-Bench
Untuk mengukur drift, ia harus dibuat teramati terlebih dahulu. Hal inilah yang ditangani oleh SemanticAlign-Bench, disingkat SA-Bench — benchmark diagnostik yang dijelaskan dalam artikel arXiv:2608.24252 (diterima di Findings of EMNLP 2026, penulis — Xue Hu, Zewei Pan, Zeli Su, Zhou Liu, dan Wentao Zhang).
Materinya mencakup 30 karya dari konferensi ICLR, ICML, dan NeurIPS 2025 dan terbagi ke dalam lima bidang pembelajaran mesin. Yang dinilai bukan "kesan" terhadap kode, melainkan sekumpulan klaim yang dapat diverifikasi. Secara total, benchmark ini mengumpulkan 1.491 klaim semacam itu.
Semantic Alignment Units: atom spesifikasi
Ide metodologis utamanya adalah menguraikan deskripsi artikel menjadi elemen-elemen terkecil yang dapat diverifikasi terhadap repositori secara manual. Elemen-elemen ini disebut Semantic Alignment Units (SAU). Setiap unit adalah klaim tersendiri tentang implementasi: hyperparameter tertentu, rumus, urutan operasi, kondisi berhenti, skema pembagian data.
Pendekatan granular semacam ini penting karena menghilangkan sifat biner dari penilaian "berhasil / tidak berhasil". Alih-alih satu centang per artikel, muncul ratusan pertanyaan kecil, dan terlihat di mana tepatnya implementasi melemah.
Empat dimensi drift
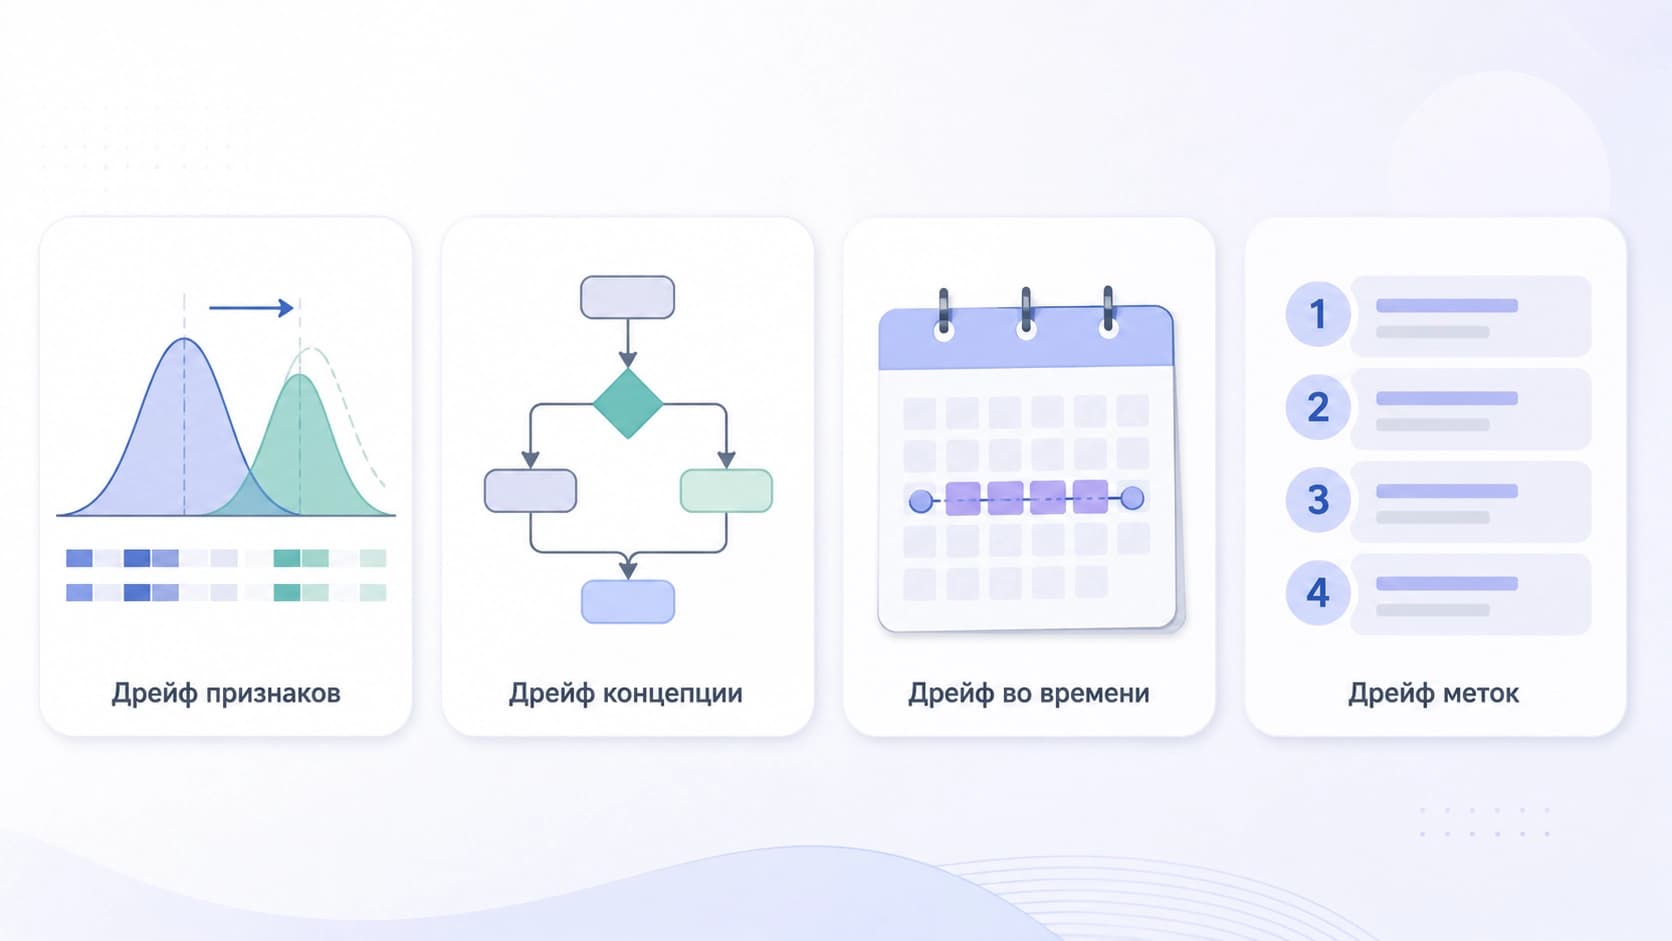
Setiap repositori dinilai berdasarkan empat sumbu diagnostik:
- drift numerik — nilai koefisien, dimensi, ambang batas, dan besaran lain tidak sesuai dengan spesifikasi;
- drift metodologis — prosedur pelatihan atau komputasi itu sendiri disusun berbeda dari yang dimaksudkan dalam karya;
- drift protokol — skema eksperimen dilanggar: pembagian sampel, kondisi perbandingan, tata cara evaluasi;
- drift urutan — langkah-langkah dijalankan dalam urutan yang salah, dan ini mengubah hasil.
Pemisahan sumbu ini memberi manfaat praktis: pengembang melihat bukan "kualitas rendah" yang abstrak, melainkan jenis kerusakan yang konkret.
Hasil: 0,301 sebagai plafon
Penulis menjalankan 12 konfigurasi generator — empat model yang dikombinasikan dengan tiga scaffold. Setiap penilaian diukur dalam pecahan dari satu.
Angkanya cukup menyadarkan. Hasil terbaik ditunjukkan oleh kombinasi Claude dan PaperCoder — rata-rata 0,301 poin SAU dari 1,0 yang mungkin. Skor rata-rata keseluruhan dari semua 360 penilaian — 0,221.
Dengan kata lain, bahkan konfigurasi terkuat pun hanya menjalankan dengan benar kurang dari sepertiga dari apa yang disyaratkan spesifikasi. Meski demikian, model tidak mengabaikan persyaratan: taksonomi kegagalan menunjukkan bahwa agen biasanya berusaha memenuhi sebagian besar poin, tetapi mengimplementasikannya dengan salah. Sebagian besar klaim yang bernilai nol berasal dari dua skenario — ketidaksesuaian implementasi dengan maksud (implementation mismatch) dan stub, yaitu tempat di mana logika yang sebenarnya digantikan oleh formalitas kosong.
Profil kesalahan semacam ini menunjukkan hal penting: persoalannya bukan kemalasan agen dan bukan karena ia "tidak membaca sampai habis" artikelnya. Persoalannya adalah ia dengan yakin mereproduksi versi yang tampak masuk akal, tetapi salah.
Dapat dijalankan tidak sama dengan kesetiaan ilmiah
Kesimpulan tersendiri dari karya ini menyangkut bagaimana scaffold modern disusun. Scaffold yang dioptimalkan untuk dapat dijalankan — agar kode sekadar berjalan dan tidak crash — memberi keuntungan yang terbatas untuk reproduksi ilmiah. Ini logis: keberhasilan menjalankan menguji sintaksis dan keberadaan dependensi, tetapi tidak mengatakan apa pun tentang apakah logikanya sesuai dengan maksud penulis.
Untuk mempersempit kesenjangan, dibutuhkan scaffold kelas lain — yang mengutamakan verifikasi spesifikasi semantik. Sederhananya, agen tidak cukup hanya menulis dan menjalankan kode, tetapi harus mencocokkan setiap langkahnya dengan klaim dari artikel dan mampu membuktikan bahwa kecocokan itu ada.
Apa yang berubah dalam praktik
SA-Bench bukanlah kompetisi model, melainkan alat diagnostik. Nilainya terletak pada kenyataan bahwa ia memindahkan pembahasan reproduktibilitas dari ranah "berfungsi / tidak berfungsi" ke ranah "seberapa tepat kesesuaiannya". Benchmark, anotasi, dan pipeline evaluasi tersedia secara terbuka, sehingga metodologinya dapat diterapkan juga pada tugas Anda sendiri — misalnya, untuk memeriksa pipeline internal pembuatan kode berdasarkan spesifikasi teknis, bukan hanya berdasarkan artikel ilmiah.
Bagi mereka yang membangun agen, kesimpulannya berbunyi demikian: peningkatan "kecerdasan" generator tanpa lapisan verifikasi tersendiri akan membentur plafon. Semantic drift bukanlah bug pada model tertentu, melainkan sifat dari pendekatan di mana tidak ada yang memeriksa kesesuaian makna. Dan selama lapisan semacam itu belum ada, reproduksi kode riset akan tetap menjadi tugas di mana manusia masih perlu membaca setiap barisnya.


