
Pembelajaran in-context tabular dengan pakar spars: OrionMoE-Small-v1.0 yang ringkas
Model dasar yang ringkas untuk tugas tabular ini memprediksi observasi baru berdasarkan tabel acuan berlabel tanpa melatih ulang parameter. Pemilihan pakar secara adaptif dengan mempertimbangkan kumpulan data dan representasi fitur menghasilkan kinerja yang kompetitif, terutama pada konteks kecil dan dimensi tinggi.
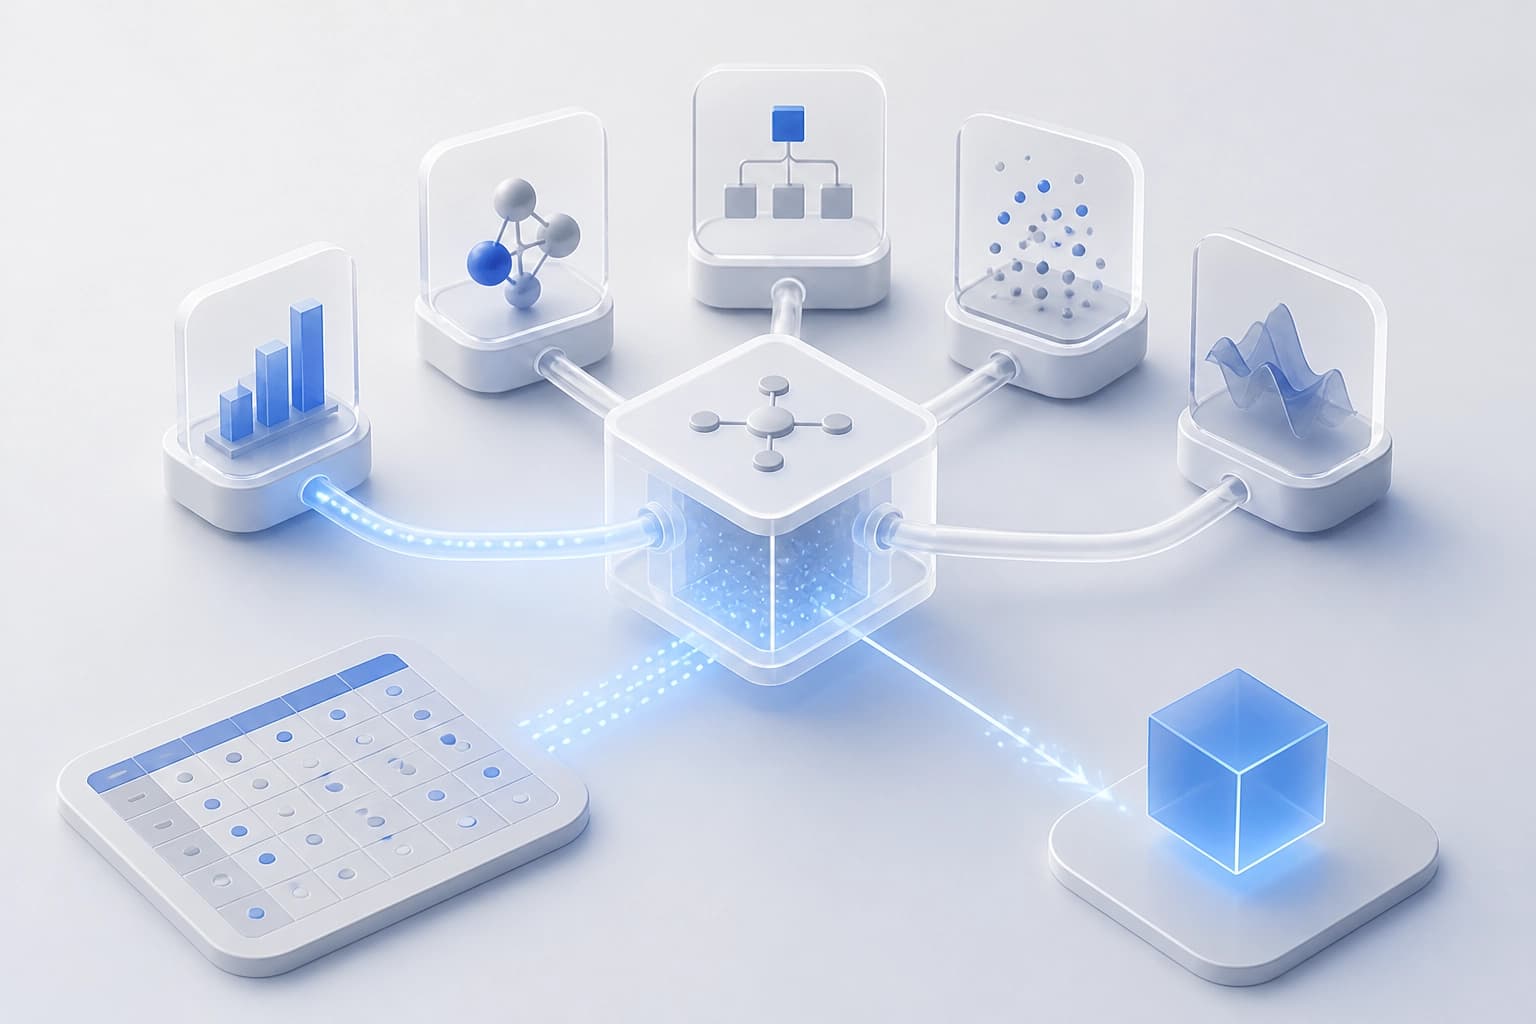
Pembelajaran dalam konteks: inti modus
Model memprediksi observasi yang belum terlihat berdasarkan tabel dukungan berlabel. Model tidak memperbarui parameter untuk tugas tertentu. Artikel ini mengulas OrionMoE-Small-v1.0 — model dasar tabular ringkas untuk pembelajaran dalam konteks.
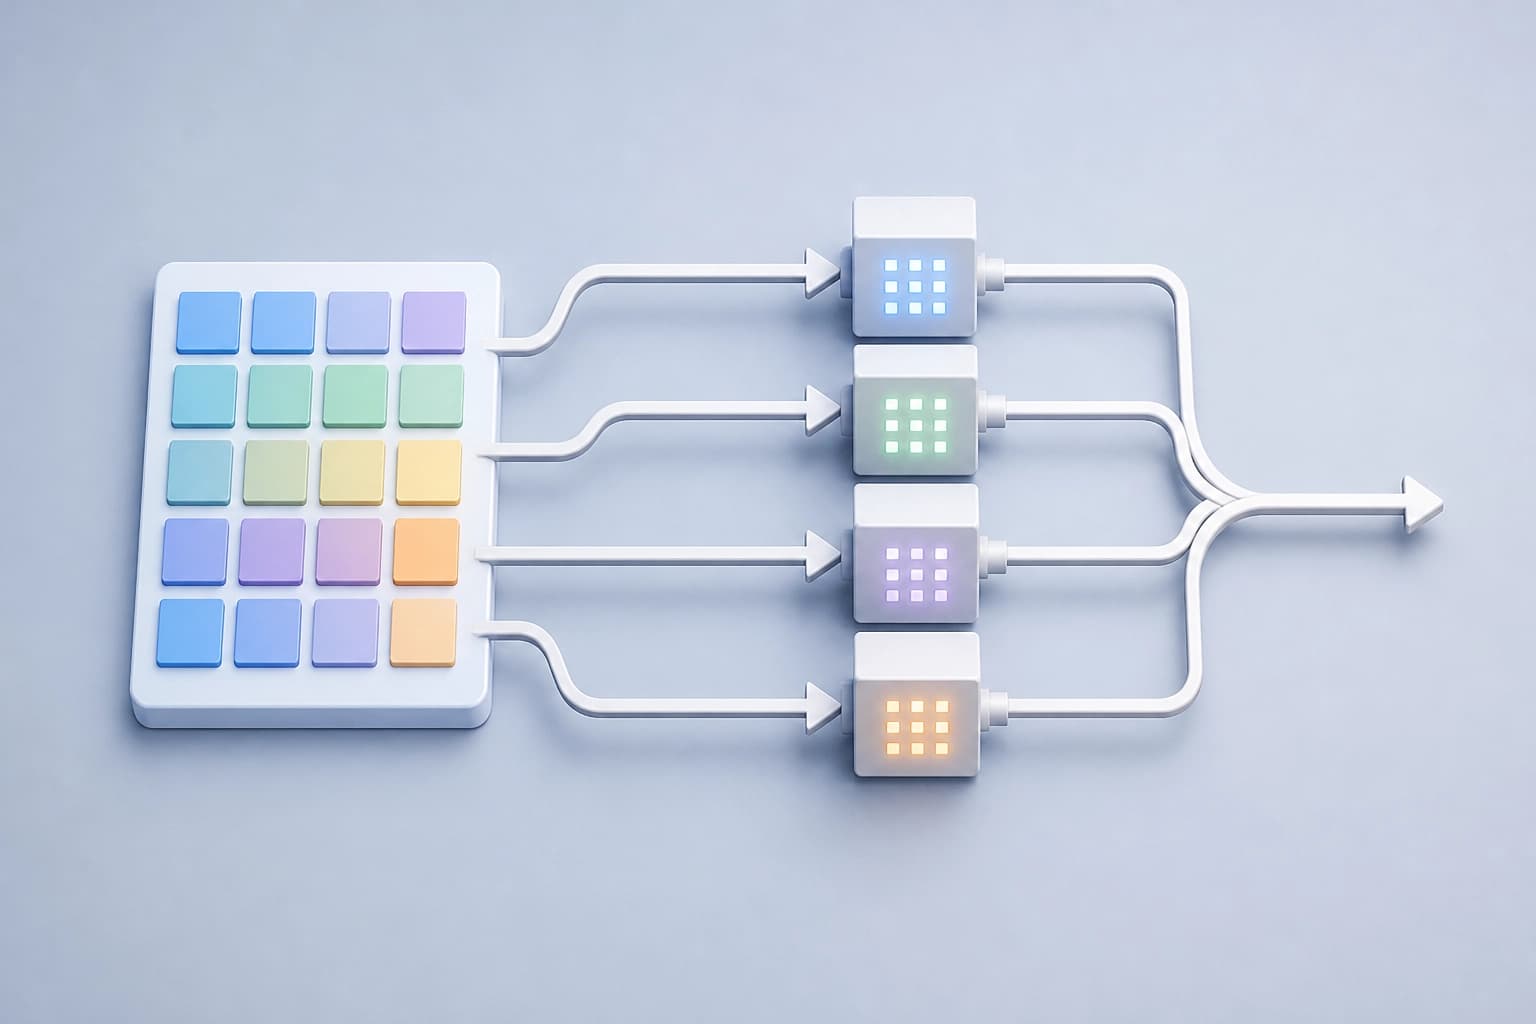
Elemen utama modus ini:
- masukan — tabel dukungan berlabel;
- tujuan — memprediksi observasi yang belum terlihat;
- adaptasi — tanpa memperbarui parameter untuk tugas tertentu;
- modus — pembelajaran dalam konteks.
Kriteria praktis: tugas memungkinkan prediksi berdasarkan tabel dukungan berlabel. Adaptasi gradien untuk tugas tersebut tidak diperlukan.
Arsitektur: dual-axis transformer dan pakar jarang
OrionMoE-Small-v1.0 dibangun di atas arsitektur dual-axis transformer. Model ini memadukan representasi yang mempertimbangkan distribusi data dengan komputasi campuran pakar yang jarang. Komputasi ini dikondisikan oleh set data. Pemilihan pakar yang diaktifkan mempertimbangkan representasi sel dan konteks keseluruhan set data.
Rancangan model:
- arsitektur — dual-axis transformer;
- representasi — mempertimbangkan distribusi data;
- komputasi — campuran pakar jarang yang dikondisikan oleh set data;
- pemilihan pakar — berdasarkan representasi sel dan konteks set data;
- alokasi komputasi — adaptif di antara tugas tabular yang heterogen;
- jalur komputasi — sama untuk berbagai tugas.
Kriteria praktis: tugas tabular yang heterogen memerlukan alokasi komputasi yang adaptif. Model mempertahankan jalur komputasi yang sama untuk berbagai tugas.
Pelatihan: tugas klasifikasi sintetis
Model menjalani prapelatihan hanya pada tugas klasifikasi sintetis. Tugas-tugas ini didasarkan pada prior kausal terstruktur. Untuk tugas lanjutan, model membuat prediksi tanpa adaptasi gradien. Anotasi menyebutkan nama OrionMoE-Small-v1.0.
Penulis artikel: Mohamed Bouadi, Nassim Bouarour, Aditya Tanna, Vinay Kumar Sankarapu. Para penulis mengirimkan artikel pada 14 Oktober 2026. Revisi terakhir diterbitkan pada 18 Oktober 2026. Versi artikel — v2.
Hal-hal yang diketahui tentang pelatihan:
- data — hanya tugas klasifikasi sintetis;
- dasar — prior kausal terstruktur;
- tugas lanjutan — tanpa adaptasi gradien.
Kriteria praktis: sumber menjelaskan prapelatihan hanya pada tugas klasifikasi sintetis. Tidak ada data yang diberikan mengenai jenis tugas lainnya.
Hasil dan kriteria penerapan
OrionMoE-Small-v1.0 menunjukkan hasil yang kompetitif pada beberapa tolok ukur tabular. Perbandingan dilakukan dengan model dasar yang jauh lebih besar. Analisis mencatat hasil yang sangat kuat khususnya pada set data dengan konteks kecil dan dimensi tinggi. Analisis tambahan menunjukkan hasil relatif yang menguntungkan pada kondisi ketidakseimbangan kelas.
| Skenario | Hasil analisis |
|---|---|
| Perbandingan dengan model dasar yang jauh lebih besar | hasil yang kompetitif |
| Konteks kecil dan dimensi tinggi | hasil yang sangat kuat |
| Ketidakseimbangan kelas | hasil relatif yang menguntungkan |
| Komposisi fitur | analisis menyoroti pentingnya |
Kriteria praktis: konteks kecil dan dimensi tinggi merupakan kondisi dengan hasil yang sangat kuat. Ketidakseimbangan kelas dan komposisi fitur merupakan poin analisis tersendiri.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan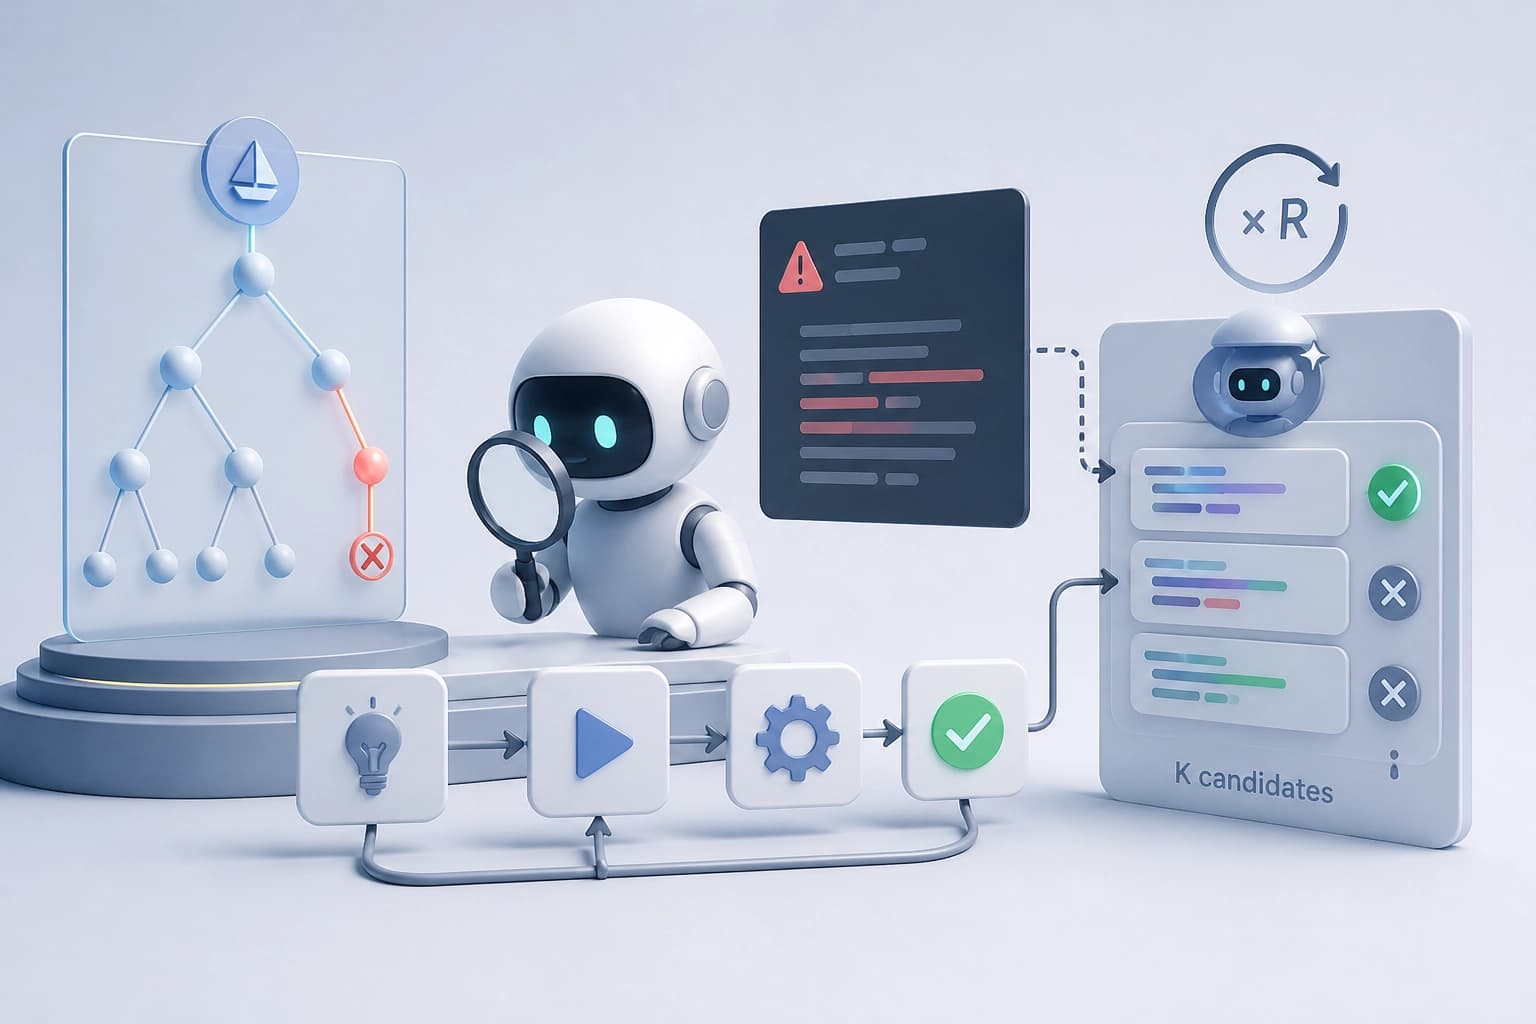
Perbaikan taktik terbatas di Lean 4 dengan bantuan diagnostik kompilator
Modul bertahap ini tidak membuang taktik yang ditolak, tetapi meminta model koreksi untuk memperbaikinya hingga R kali dengan mempertimbangkan kesalahan Lean; dengan K kandidat, modul ini meningkatkan proporsi tugas yang berhasil diselesaikan. Eksperimen pada LeanDojo dan Lean Workbook menunjukkan peningkatan yang terutama berasal dari kegagalan eksekusi dangkal, dengan konsekuensi waktu pencarian yang lebih lama.
16 November 2026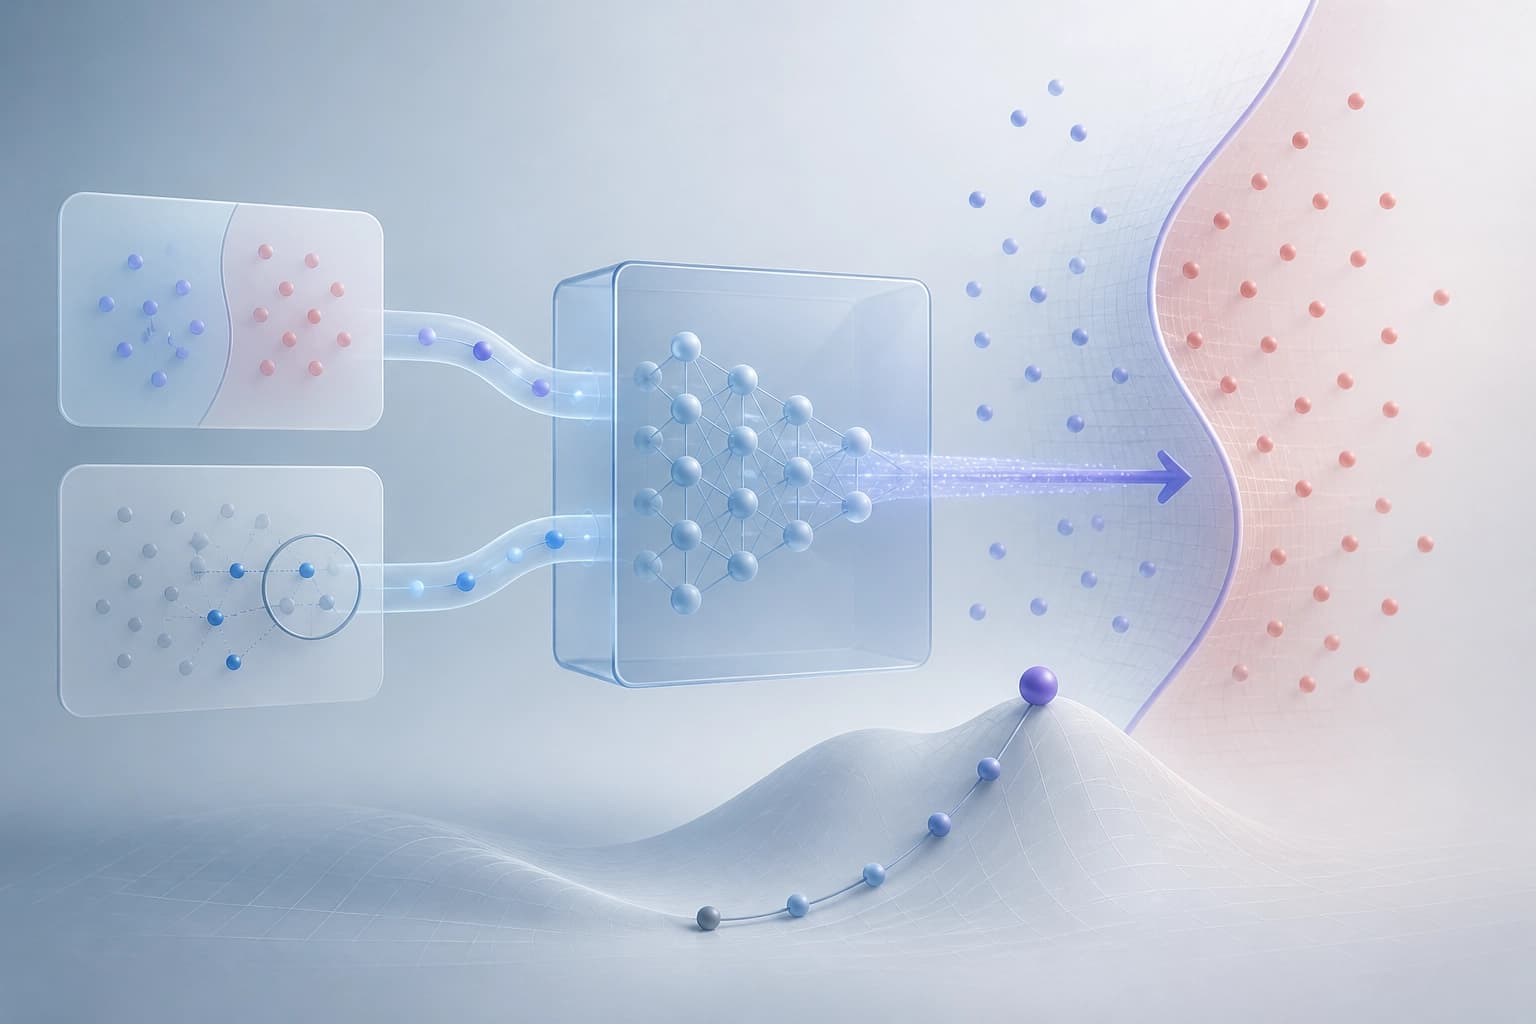
Metode Genesis Steering: pengarahan aktivasi pada data yang digunakan saat fine-tuning
Metode ini menghasilkan vektor pengarah dari contoh kontras yang terdapat dalam data penyempurnaan, dan jika contoh tersebut tidak tersedia, metode ini memilih sampel pelatihan yang mungkin melalui membership inference lalu membentuk kumpulan data proksi. Bagian teoretis menguraikan pergeseran optimal menuju batas keputusan dan estimasi berdasarkan data proksi; secara empiris, data internal Tülu-3-8B memberikan efek yang lebih kuat daripada kumpulan data eksternal, sedangkan kegunaan proksi MIA pada Llama-3.1-8B-Instruct terbatas oleh rasio pergeseran arah.
16 November 2026
Pencarian lokal atas pergeseran kovariat untuk profil dengan prediksi yang tidak andal
Artikel ini menjelaskan pipeline diagnostik yang pertama-tama mengidentifikasi kelompok pasien yang dapat diinterpretasikan dengan tingkat keyakinan model yang rendah, lalu memeriksa keberadaan pergeseran kovariat yang merugikan di dalam kelompok-kelompok tersebut. Dalam eksperimen pada MIMIC-IV dengan tiga tugas klinis dan tiga pergeseran subkelompok buatan, pendekatan ini membantu menemukan pergeseran terkait usia yang sulit terlihat pada evaluasi agregat.
15 November 2026